
CQRS tel qu'utilisé ici
Résumé. La séparation des responsabilités entre commandes et requêtes (Command Query Responsibility Segregation, CQRS) sépare le code qui change l'état du code qui répond aux questions. Ce kit en applique la forme légère : chaque cas d'usage est soit une commande, soit une requête, chacune avec un seul gestionnaire (handler) et atteinte par un bus de commandes ou un bus de requêtes. Une commande passe par l'agrégat et renvoie au plus un identifiant ; une requête ne change jamais l'état et peut lire une projection par un port sans charger d'agrégats. Les agrégats gardent leur état dans des tables, sauf si l'on choisit d'en faire passer un à l'event sourcing, et il n'y a pas de seconde base de données par défaut. Cette page dit ce que cela apporte, ce que cela n'apporte pas, et quand la séparation ne vaut pas la peine.
D'une règle de méthode à une règle d'architecture
Section intitulée « D'une règle de méthode à une règle d'architecture »La séparation commande-requête de Bertrand Meyer est une règle qui porte sur les méthodes : une méthode change l'état ou renvoie une valeur, pas les deux. Greg Young et Udi Dahan l'ont élevée au niveau du modèle : utiliser un modèle pour écrire et un autre pour lire, parce que les deux ont des formes et des charges différentes. Le résumé et la mise en garde de Fowler font référence : la séparation aide dans une minorité de domaines complexes et ajoute du risque ailleurs.
Le kit en prend la partie qui coûte peu et rapporte dans chaque projet :
| Élément | Règle dans ce kit |
|---|---|
| un cas d'usage | une commande ou une requête, dans son propre dossier, avec un seul gestionnaire |
| une commande | change l'état par un seul agrégat ; ne renvoie rien ou un identifiant |
| une requête | ne change rien ; renvoie une vue taillée pour l'appelant |
| le point d'entrée | CommandBus et QueryBus, jamais une classe de gestionnaire |
| ce qui est commun à tous les cas d'usage | un middleware de bus, pas du code répété dans les gestionnaires |
Le texte normatif est ARCHITECTURE.md, section 4 (« Cas d'usage »,
« Bus ») ; la forme d'un gestionnaire est application/handler-shape, et une requête qui
enregistre, supprime ou publie est signalée par application/command-query-separation.
Les deux chemins, sur l'application de prise de rendez-vous
Section intitulée « Les deux chemins, sur l'application de prise de rendez-vous »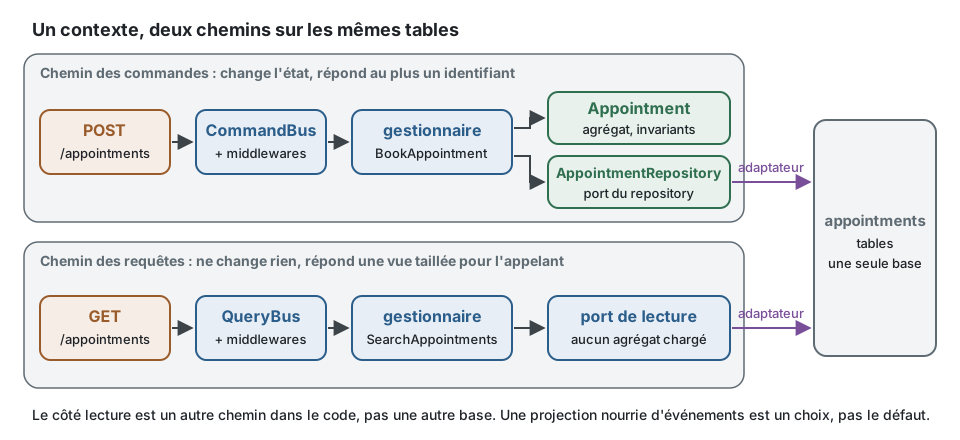
Commande. BookAppointment porte l'acteur et le créneau demandé. Le gestionnaire charge ce
dont il a besoin, appelle une seule méthode d'intention (Appointment.book(...)), enregistre par
le port du repository et ne fait rien d'autre : l'enregistrement transmet les événements
enregistrés, et l'unité de travail les distribue une fois que le gestionnaire a rendu la main,
avant la validation (commit). Il renvoie l'identifiant du nouveau rendez-vous et rien d'autre :
le client qui veut afficher le rendez-vous envoie GetAppointment. Renvoyer l'agrégat entier
lierait la réponse au modèle d'écriture.
Requête. SearchAppointments a besoin de vingt lignes de cinq colonnes, filtrées selon ce
que l'acteur a le droit de voir, et paginées. Charger vingt agrégats avec leurs invariants pour
jeter l'essentiel de leur état est du gaspillage. Le gestionnaire interroge un port de lecture,
dont l'adaptateur interroge directement les tables et renvoie la forme que déclare le port. Le
périmètre d'accès calculé par l'authorizer entre dans cette requête SQL, de sorte que rien
n'est filtré en mémoire après le chargement (voir
Authentification et autorisation).
Les deux chemins lisent les mêmes tables. Le côté lecture est un autre chemin de code, pas une autre base de données.
Le chemin des requêtes dans le code
Section intitulée « Le chemin des requêtes dans le code »Une requête nomme sa réponse dans son type, un port de lecture déclare la forme dont l'appelant a besoin, et le gestionnaire interroge le port. Le bus déduit la réponse de la requête, si bien que la route obtient un résultat typé sans connaître le gestionnaire :
import { definePermissions } from '@ddd-ts-kit/auth';import { AuthorizedQuery, InMemoryQueryBus, type Actor, type BusMiddleware, type Logger } from '@ddd-ts-kit/kernel';import { QueryHandler, Requires } from '@ddd-ts-kit/kernel/declarations';
const appointmentsPermissions = definePermissions('appointments', {  'appointment.search': { description: 'Search the appointments of a practitioner' },});
// application/ports/appointment-lines.port.ts : la forme dont l'écran a besoin, pas l'agrégatexport interface AppointmentLine {  readonly id: string;  readonly startsAt: string;  readonly clientName: string;}
export abstract class AppointmentLines {  abstract ofPractitioner(practitionerId: string, limit: number): Promise<readonly AppointmentLine[]>;}
// application/queries/search-appointments/search-appointments.query.ts@Requires(appointmentsPermissions['appointment.search'])export class SearchAppointments extends AuthorizedQuery<readonly AppointmentLine[]> {  constructor(    actor: Actor,    readonly practitionerId: string,  ) {    super(actor);  }}
// application/queries/search-appointments/search-appointments.handler.ts : lit, n'enregistre jamais@QueryHandler(SearchAppointments)export class SearchAppointmentsHandler implements QueryHandler<SearchAppointments> {  constructor(private readonly lines: AppointmentLines) {}
  execute(query: SearchAppointments): Promise<readonly AppointmentLine[]> {    return this.lines.ofPractitioner(query.practitionerId, 20);  }}
// platform/buses/ : ce par quoi passe chaque requête, écrit une fois pour toutesdeclare const logger: Logger;declare const lines: AppointmentLines; // l'adaptateur que la plateforme lie au port
const logged: BusMiddleware = async (message, next, info) => {  logger.info('use case', { kind: info.kind, name: info.name });
  return next();};
const queryBus = new InMemoryQueryBus()  .use(logged)  .register(SearchAppointments, new SearchAppointmentsHandler(lines), { context: 'appointments' });
// presentation/ : la route connaît le bus et la requête, jamais le gestionnaireexport async function appointmentsOf(actor: Actor, practitionerId: string): Promise<readonly AppointmentLine[]> {  return queryBus.execute(new SearchAppointments(actor, practitionerId));}
Dans un projet généré, les bus sont construits dans src/platform/buses/. Dans le style déclaré,
les gestionnaires sont enregistrés à partir de leurs déclarations ; dans le style explicite, le
module du contexte appelle register pour chacun, comme le fait l'exemple pour montrer ce que
contient le bus (voir Ports et composition).
Deux habitudes que tiennent les règles
Section intitulée « Deux habitudes que tiennent les règles »Au lieu d'une commande qui rend l'agrégat à l'appelant :
export class BookAppointment extends AuthorizedCommand<Appointment> { /* ... */ }// la route sérialise l'agrégat : la réponse est désormais liée au modèle d'écritureécrivez une commande qui renvoie son identifiant, et une requête pour ce qu'affiche le client :
export class BookAppointment extends AuthorizedCommand<string> { /* ... */ }const id = await commandBus.execute(new BookAppointment(actor, calendarId, startsAt));const appointment = await queryBus.execute(new GetAppointment(actor, id));Au lieu d'une requête qui change l'état au passage :
async execute(query: GetAppointment): Promise<AppointmentView> { const appointment = await this.appointments.findById(query.appointmentId); appointment.markSeenBy(query.actor.id); await this.appointments.save(appointment); // application/command-query-separation return toView(appointment);}écrivez le changement comme une commande à part entière (MarkAppointmentSeen), envoyée par
l'appelant qui la veut, et gardez la requête comme une pure lecture.
Pourquoi des bus
Section intitulée « Pourquoi des bus »Une route pourrait appeler directement un gestionnaire. Les bus existent pour trois raisons :
-
Un seul endroit pour ce dont chaque cas d'usage a besoin. La plateforme générée (
src/platform/buses/) place sur les bus, sous forme de middlewares et du plus extérieur au plus intérieur : la remontée d'un échec inattendu (quand la stack comprend un outil de suivi des erreurs), l'entrée de journal, la mesure, le contrôle de permission, le span du cas d'usage, la mise en attente d'un fichier déposé et le réveil du relais de l'outbox (commandes seulement, quand la stack les comprend), l'entrée d'audit (quand le journal d'audit est activé) et, pour les commandes, l'unité de travail. Un gestionnaire ne contient rien de tout cela, donc rien de tout cela ne peut être oublié dans un nouveau gestionnaire.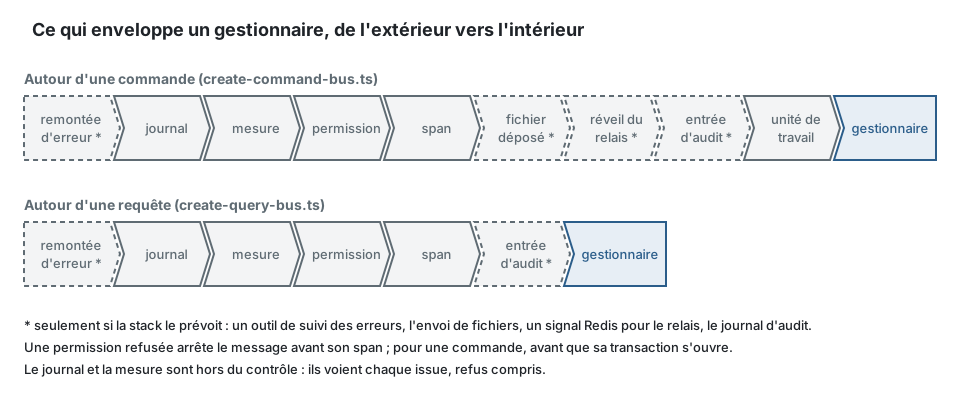
-
Un seul point d'entrée pour chaque appelant. Une route, un gestionnaire d'événement d'intégration et un job planifié envoient tous une commande. Le cas d'usage est autorisé, audité et exécuté dans une transaction de la même façon, quel que soit celui qui l'a lancé.
-
Une couture. Les bus sont des ports du noyau avec des implémentations dans le processus. Un autre transport est un adaptateur choisi dans la racine de composition ; les appelants ne changent pas.
Le prix est un niveau d'indirection : « aller à la définition » sur execute mène au bus, pas au
gestionnaire. Le gestionnaire vit à côté de sa commande, dans le même dossier, et c'est ainsi
qu'on le trouve.
Ce que cela apporte
Section intitulée « Ce que cela apporte »- Les cas d'usage sont visibles. La liste des commandes et des requêtes d'un contexte est sa
surface fonctionnelle :
ddd-ts-kit describe <context>l'affiche, et une permission est déclarée sur chacune (authz/declared). - Les lectures cessent de tordre le modèle. Un agrégat est dimensionné pour ses invariants (voir Agrégats), pas pour les écrans qui l'affichent. Une nouvelle colonne dans une liste est un changement d'un adaptateur de lecture.
- Chaque côté est testé comme il le mérite : le comportement pour les commandes, la forme renvoyée pour les requêtes.
- Les commandes sont faciles à rendre idempotentes et à auditer : ce sont des données nommées, envoyées par un seul endroit.
- La porte vers un stockage de lecture séparé reste ouverte. Un port de lecture peut plus
tard être servi par une projection alimentée par des événements, comme l'est
availability, sans toucher aux appelants.
Ce que cela n'apporte pas, et ce que le kit ne fait pas
Section intitulée « Ce que cela n'apporte pas, et ce que le kit ne fait pas »- L'event sourcing est un choix par agrégat, il ne fait pas partie de CQRS. Les agrégats sont stockés sous forme d'état par défaut, et leurs événements du domaine sont enregistrés pour être distribués à la fin de l'unité de travail, pas pour les reconstruire. CQRS et l'event sourcing sont des patrons indépendants que l'on présente souvent ensemble : un agrégat dont l'historique est le métier peut passer à l'event sourcing pendant que les autres gardent leurs lignes (L'event sourcing, par agrégat).
- Pas de base de lecture séparée. Une projection est
une table du contexte consommateur. Les packages d'exécution portent le côté lecture :
Criteria(les filtres, le tri et la page d'une liste, vérifiés contre une définition), l'hydratation, le portReadModelStoreavec un registre en table SQL, les déclarations@Projectionet@Ond'un projecteur et une reconstruction (README du kernel, « Criteria », « Hydration » et « Projections »). La CLI en génère une partie :generate query --searchécrit un port de lecture avec un adaptateur en mémoire et un fake, etgenerate projection <context> <Name> <event-type>écrit un projecteur et sa spec, dans le les deux styles (dans le style explicite sur tsyringe, le fichier de module du contexte l'inclut parbuilder.include(<Name>Projection); sur une plateforme câblée à la main, la classe est simple et le module la souscrit sous son nom de consommateur), etgenerate read-model <context> <Name> --field <name>:<type>...écrit le modèle de lecture qu'il tient : le port au-dessus deReadModelStoreavec le type de sa ligne et ses critères, la table dans le schéma du contexte, l'adaptateur de stockage de l'ORM du projet lié au port, le fake, et une spec qui lancereadModelContractsur les deux. Les colonnes des champs acceptent null, puisqu'une ligne supprimée est une trace qui ne garde que sa clé et son tampon (ce que laisse une ligne supprimée), et une contrainte de vérification,<table>_live_rows_whole, garde entière toute autre ligne (sur Prisma, dont le langage de schéma n'en a pas, l'instruction reste à ajouter à la migration) ; une colonne de texte qu'une lecture trie ou compare par intervalle prend la collation"C"dans sa migration, les critères ordonnant les chaînes par point de code. L'état de chaque partie est dans la proposition sur le côté lecture. - Pas de performance en soi. Deux chemins de code sur une seule base de données passent à l'échelle comme une seule base de données.
- Pas de commandes asynchrones par défaut. Les bus dans le processus sont attendus (
await). Une commande à laquelle on répond « acceptée » et qui est traitée plus tard est une conception que le projet construit sur des événements.
Quand une projection est le bon modèle de lecture
Section intitulée « Quand une projection est le bon modèle de lecture »availability répond à FindOpenSlots. La réponse combine les heures de travail et les absences
tenues par calendars avec les rendez-vous tenus par appointments. Interroger les deux
contextes à chaque recherche couplerait trois contextes à l'exécution. À la place,
availability garde sa propre table des créneaux ouverts, mise à jour à l'arrivée de
calendars.calendar.working-hours-changed, appointments.appointment.booked ou
appointments.appointment.cancelled. La recherche est une seule requête locale. Le coût est que
la réponse peut avoir un instant de retard : un créneau affiché comme ouvert peut avoir été pris
il y a une seconde, et c'est appointments qui refuse la double réservation (voir
Cohérence à terme).
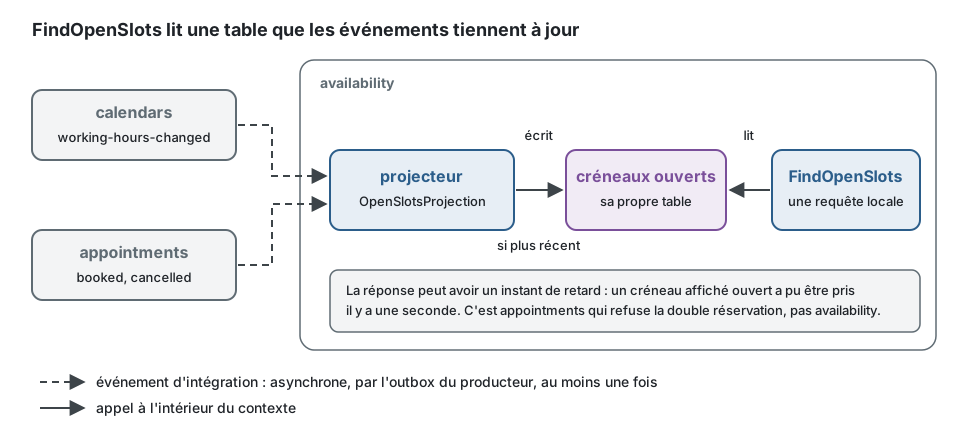
Le projecteur applique chaque événement à une ligne, et son registre n'écrit que quand l'événement est plus récent que celui que tient la ligne, si bien qu'une nouvelle livraison ou un événement en retard ne change rien. Une réservation dit toute la ligne de son créneau ; une annulation change la ligne que sa réservation a écrite :
import { defineIntegrationEvent, type PayloadOf } from '@ddd-ts-kit/events';import { ReadModelStore, stampOf, type IntegrationEvent, type ReadModelWrite } from '@ddd-ts-kit/kernel';import { On, Projection } from '@ddd-ts-kit/kernel/declarations';import { zodSchema } from '@ddd-ts-kit/validation/zod';import { z } from 'zod';
// appointments/published-language/ : ce qu'availability peut savoir d'une réservationconst slotTaken = z.object({ appointmentId: z.string(), calendarId: z.string(), startsAt: z.iso.datetime() });
export const appointmentBooked = defineIntegrationEvent({  type: 'appointments.appointment.booked',  version: 1,  payload: zodSchema(slotTaken),});
export const appointmentCancelled = defineIntegrationEvent({  type: 'appointments.appointment.cancelled',  version: 1,  payload: zodSchema(slotTaken),});
// availability/application/ports/open-slots.port.ts : le modèle de lecture, une ligne par créneauexport interface OpenSlotRow {  readonly calendarId: string;  readonly startsAt: string;  readonly open: boolean;}
export abstract class OpenSlots extends ReadModelStore<OpenSlotRow> {}
// availability/application/projections/open-slots.projection.tsconst keyOf = ({ calendarId, startsAt }: PayloadOf<typeof appointmentBooked>) => `${calendarId}@${startsAt}`;
@Projection('availability.open-slots')export class OpenSlotsProjection {  constructor(private readonly slots: OpenSlots) {}
  @On(appointmentBooked)  booked(event: IntegrationEvent<PayloadOf<typeof appointmentBooked>>): Promise<ReadModelWrite> {    const { calendarId, startsAt } = event.payload;
    // l'événement dit toute la ligne : il la crée, ou remplace ce qu'un événement plus ancien a écrit    return this.slots.upsertIfNewer(keyOf(event.payload), stampOf(event), () => ({ calendarId, startsAt, open: false }));  }
  @On(appointmentCancelled)  cancelled(event: IntegrationEvent<PayloadOf<typeof appointmentCancelled>>): Promise<ReadModelWrite> {    // l'événement change une partie d'une ligne qu'une réservation a créée : sans cette ligne, la réponse est `missing`    return this.slots.updateIfNewer(keyOf(event.payload), stampOf(event), (row) => ({ ...row, open: true }));  }}
FindOpenSlots lit ensuite OpenSlots avec des critères, comme n'importe quel autre port de
lecture. Le projecteur n'envoie aucune commande et ne lit aucun autre contexte : il ne fait que
garder sa table à jour.
Quelle écriture pour quel événement
Section intitulée « Quelle écriture pour quel événement »| L'événement | L'écriture | Quand la clé ne tient aucune ligne |
|---|---|---|
| dit toute la ligne, ou peut la créer | upsertIfNewer(key, stamp, next) |
next reçoit undefined et la ligne qu'il répond est écrite |
| ne concerne pas ce modèle de lecture | upsertIfNewer dont le next répond undefined |
rien n'est écrit : ignored |
| change une partie d'une ligne qu'un autre événement a créée | updateIfNewer(key, stamp, change) |
rien n'est écrit : missing |
| retire la ligne | delete(key, stamp) |
la trace est écrite : traced |
Une écriture qui porte toute la ligne est juste dans n'importe quel ordre. Quelles que soient
les livraisons, la ligne finit telle que le dit l'événement le plus récent. Préférez-la : un
événement qui énonce ce qu'il laisse (la réservation ci-dessus, avec son calendrier, son début et
open) n'a besoin de rien des événements qui le précèdent.
Un événement qui change une partie d'une ligne n'est juste que si les événements de sa clé sont appliqués dans l'ordre. Le registre refuse de remonter le temps, et il ne fait que cela. Il ne peut pas remettre ce qui est arrivé dans le désordre :
- un changement livré avant la création de sa ligne ne trouve rien à changer :
updateIfNewern'écrit rien et répondmissing. La création écrit ensuite la ligne telle qu'elle était au départ, et le changement n'est pas appliqué de nouveau par le registre ; - de deux changements partiels livrés dans le désordre, le plus ancien est
staleet acquitté : ce que lui seul disait est perdu ; - par-dessus la trace d'une suppression, un changement qui n'est pas plus tardif que la
suppression est
stale, et un plus tardif estmissing: la ligne a été retirée, par son histoire ou en dehors d'elle.
updateIfNewer n'est donc pas un remède au désordre. C'est l'écriture d'un changement partiel
sur une alimentation qui garde l'ordre d'une clé, et il distingue une ligne absente (missing)
d'un événement filtré (ignored), ce qu'un upsertIfNewer dont le next répond undefined ne
pouvait pas.
Quelles alimentations gardent l'ordre d'une clé.
| Alimentation | Ordre des événements d'une clé | Un événement en échec |
|---|---|---|
les événements du domaine du contexte, appliqués dans la sauvegarde (@On(EventClass), l'alimentation par défaut) |
l'ordre où l'agrégat les a enregistrés, dans la transaction de la sauvegarde | fait échouer la sauvegarde, donc la commande ; rien ne le livre de nouveau |
le registre d'événements, par un abonnement de rattrapage (feed: 'event-store') |
l'ordre du registre | le lot est annulé et relu à chaque interrogation, jusqu'à ce qu'il passe : tous les flux attendent derrière lui |
| le bus dans le processus, sans outbox | l'ordre de publish, un événement à la fois |
publish est rejeté vers le cas d'utilisation, après l'exécution des autres gestionnaires ; rien ne le livre de nouveau |
le relais de l'outbox, ordering: 'none' (par défaut) |
aucun : un enregistrement en échec est doublé par ses successeurs, et plusieurs relais s'entrelacent | retenté avec un délai croissant, puis mort |
le relais de l'outbox, ordering: 'per-key' |
gardé tant qu'un seul relais tourne : un enregistrement attend les enregistrements antérieurs de sa clé | bloque les événements suivants de sa clé jusqu'à ce qu'il sorte ou soit mort |
| Kafka | l'ordre d'une partition : un enregistrement en échec est retenté sur place | la partition est mise en pause pour tout le groupe entre les tentatives, puis l'enregistrement est mort et ses successeurs continuent sans lui |
| RabbitMQ, NATS, Redis Streams | aucun : plusieurs messages sont traités à la fois et une nouvelle tentative revient après ses successeurs | quelques tentatives à délai constant, chaque gestionnaire du consommateur exécuté de nouveau, puis mort |
Que faire de missing. La projection décide, puisqu'elle seule connaît son alimentation :
- Alimentée dans la sauvegarde ou par un abonnement de rattrapage : répondez-le, ne levez jamais. Les événements y sont dans l'ordre, si bien qu'une ligne absente est une ligne que ce modèle de lecture ne tient pas, ou une ligne retirée en dehors de l'histoire (un effacement). Une erreur ferait échouer la commande pour toujours, ou bloquerait l'abonnement.
- Alimentée par un broker sans ordre (RabbitMQ, NATS, Redis Streams, un relais sans
per-key) : préférez des événements qui portent toute la ligne. Là où un changement partiel est tout ce que donne l'amont, lever une erreur à vous surmissingfait retenter le fournisseur, puis rejeter (quand un gestionnaire échoue sans cesse) : quelques tentatives sur quelques secondes, auxquelles survit une création elle-même en retard, et chaque gestionnaire du consommateur s'exécute de nouveau à chacune. Répondremissingà la place abandonne le changement et le compte. - Sur Kafka, ne levez pas pour cela. Un changement en avance sur sa création dans la même partition ne peut jamais réussir en attendant, et chaque tentative met la partition en pause pour tout le groupe.
- Comptez-le.
projection_events_totala le résultatmissing: un compte qui monte est un changement arrivé avant sa création, ou après un retrait.
Une seule sorte de tampon par clé. stampOf(event) ordonne par l'instant de l'événement,
puis par son id ; stampOf(event, version) ordonne par une version que l'amont compte par clé.
L'ordre est total dans chaque sorte : le plus récent d'un ensemble d'événements est le même quel
que soit l'ordre de leurs livraisons. Quand un tampon a une version et l'autre non, les instants
décident, et ce n'est pas un ordre : avec A (version 1, 12:09), B (sans version, 12:05) et C
(version 2, 12:01), C est plus récent que A, A plus récent que B et B plus récent que C, si bien
que la ligne qui reste dépend de l'ordre des livraisons. Tamponnez de la même façon chaque
événement qui écrit une clé, les lignes de la source d'une reconstruction comprises. Le seul
mélange voulu est une suppression faite en dehors de l'histoire de la clé, comme un effacement
tamponné à l'horloge : il est plus tardif que tout ce que la ligne a vu, et les instants le
disent.
La table d'un modèle de lecture, et ce que laisse une ligne supprimée
Section intitulée « La table d'un modèle de lecture, et ce que laisse une ligne supprimée »delete(key, stamp) ne retire pas la ligne de sa table. Il laisse une trace : la clé, le tampon
et deleted = true, et rien d'autre. C'est la trace qui fait tenir une suppression quel que soit
l'ordre des livraisons : un événement plus ancien qui arrive plus tard trouve un tampon plus
récent et ne change rien. Cela vaut pour une clé que la table ne tient pas encore : une
suppression livrée avant la création qu'elle suit insère la trace, et la création en retard est
stale. Une telle suppression répond traced, pas applied : elle a enregistré sa trace et n'a
retiré aucune ligne, comme une suppression par-dessus une trace antérieure. Un code qui compte
ce qu'il a retiré (un effacement qui rapporte ce qu'il a atteint) ne compte que applied. Sur un stockage SQL, cela demande quatre choses à la table et à qui la lit :
-
Chaque colonne de la ligne accepte NULL. Une trace ne garde aucune donnée : chaque colonne que le registre associe contient NULL, hormis la clé, le locataire et le tampon, si bien que les données personnelles d'une ligne supprimée ont disparu et qu'une valeur unique qu'elle tenait est de nouveau libre. Une table dont des colonnes refusent NULL est refusée par son nom (
ReadModelTableNotReadyError) : à la construction du registre sur Drizzle et TypeORM, d'après la définition, et sur les quatre ORM avant l'écriture de la première trace, par une lecture des colonnes que tient la base, si bien qu'une migration pas encore exécutée est vue elle aussi, et jamais par une requête qui ferait échouer la transaction de l'événement. Son message nomme la table, ce qui l'empêche de contenir une trace, ce qu'est la contrainte de vérification, et la migration à écrire, en instructions qui nomment les colonnes que le registre associe et aucune autre. Sur Prisma, les champs du modèle sont optionnels eux aussi (String?). Une application n'attend pas cette première trace : chaque table est vérifiée à son démarrage. -
Une contrainte de vérification garde entières les lignes vivantes, à la place du NOT NULL que les colonnes ne portent plus.
generate read-modell'écrit avec la table, sous ce nom ; une table écrite avant, ou à la main, la prend dans une migration :alter table scheduling.appointment_listalter column status drop not null,alter column starts_at drop not null,add constraint appointment_list_live_rows_wholecheck (deleted or (status is not null and starts_at is not null)); -
Un lecteur qui interroge la table directement filtre
deleted = false. Le registre le fait dansgetetsearch; une requête à vous (une jointure, un agrégat) doit le faire. -
Les traces ne sont jamais purgées. Une purge par
last_event_atn'est pas sûre : le tampon est l'instant de l'événement, pas celui de sa livraison, si bien qu'aucun âge d'une trace ne dit qu'un événement plus ancien de sa clé ne sera pas livré de nouveau, et cet événement recréerait alors la ligne.
La clé est unique entre les locataires. La trace d'un modèle de lecture de données d'un
locataire porte le locataire du travail en cours, et sa clé est prise pour tous les locataires,
comme la clé d'une ligne vivante : une clé que deux locataires pourraient partager est un
identifiant généré ou porte le locataire (acme:2026-03-01). Sous une clé que tient un autre
locataire, une suppression est ignored, puisque rien de ce locataire n'est là à supprimer et
que sa trace ne peut pas être écrite, et un upsert est refusé aussitôt par
ReadModelKeyHeldElsewhereError, une ConcurrencyError dont le message le dit. Un travail élevé
sur plusieurs locataires lit une telle clé comme tenue et n'écrit que dans son propre locataire,
si bien que son écriture d'une clé que tient un autre locataire se termine encore, après cinq
tentatives, par une simple ConcurrencyError.
Une table peut tenir unique une autre valeur de la ligne (un slug, un numéro, par un index
unique de votre migration). La base la garde : une ligne qui prend la valeur que tient une ligne
vivante d'une autre clé est refusée, par l'erreur du pilote ou par UniqueViolationError, et le
gestionnaire de l'événement la voit ; la trace d'une ligne supprimée libère sa valeur. Des
événements d'une même clé appliqués en même temps ne sont jamais refusés pour la valeur qu'ils
écrivent tous. PostgreSQL peut les refuser quand l'insertion nomme la clé seule comme cible de
conflit, puisque deux insertions qui se croisent se rencontrent alors d'abord sur l'autre index :
les registres des quatre ORM insèrent par une instruction qui passe sur toute valeur unique, et
seulement quand elle n'a rien écrit par une seconde qui nomme la clé, ce qui distingue une clé
tenue, pour laquelle l'événement est comparé à la ligne et appliqué s'il est plus récent, d'une
valeur que tient une autre ligne, qui est refusée.
Chaque table vérifiée au démarrage, et avant un déploiement
Section intitulée « Chaque table vérifiée au démarrage, et avant un déploiement »Un registre refuse sa table avant sa première trace, et sur Drizzle et TypeORM à sa construction. Un conteneur construit un registre quand quelque chose le demande pour la première fois, si bien que dans une application câblée ainsi les deux refus arrivent avec la première requête ou le premier événement qui atteint le modèle de lecture, en production, et une table à la fois. Deux choses le disent plus tôt, pour toutes les tables d'un coup.
Les tables qu'une application liste. ReadModelTables du noyau prend une liste d'entrées,
chacune un nom et ce qui construit le registre d'un modèle de lecture comme l'application le lie :
la même classe, avec les mêmes options. Chaque table est alors lue par son propre registre, par le
code que ce registre exécute avant sa première trace (tableState(), sur les quatre ORM) : le
verdict est celui du registre par construction, pas un second avis. Rien n'est deviné d'après la
base : une table que personne ne liste n'est jamais lue, quelles que soient les colonnes qu'elle
porte (un autre service dans la même base, une sauvegarde, un schéma que le rôle ne peut pas
utiliser), et une liste vide ne vérifie rien. states() rend ce que chaque table listée peut
contenir, notReady() celles qui ne peuvent pas contenir une trace, require() refuse avec
ReadModelTablesNotReadyError, une seule erreur qui les nomme toutes :
1 read model table is not ready for this version: notification.contacts. Apply the migrations of the project before the application starts; a table they leave as it is takes the migration written under its name.
The read model table notification.contacts cannot hold the trace of a deleted row: "address" refuses NULL. A deleted row keeps its key, its tenant and its stamp only. The check constraint contacts_live_rows_whole, which keeps the live rows whole, is missing. The migration to write:-- The change of definition: brief, under the lock that stops the readers and the writers of the table.do $kit$begin  if exists (select 1 from pg_constraint where conrelid = to_regclass('"notification"."contacts"') and conname = 'contacts_live_rows_whole' and pg_get_constraintdef(oid) !~ '^CHECK [(][(]..( NOT VALID|)$') then    raise exception 'The constraint contacts_live_rows_whole of notification.contacts is not written as ddd-ts-kit writes the one that keeps the live rows of a read model whole: it is left as it is, and nothing was changed.';  end if;  alter table "notification"."contacts" alter column "address" drop not null, drop constraint if exists "contacts_live_rows_whole", add constraint "contacts_live_rows_whole" check ("deleted" or ("address" is not null)) not valid;end$kit$;-- Then the validation of the constraint and the cleaning of the rows deleted before, which reads the whole table: in the same migration on a small table; on a large one, in a migration that runs outside the transaction of the change of definition, where it stops neither readers nor writers.alter table "notification"."contacts" validate constraint "contacts_live_rows_whole";update "notification"."contacts" set "address" = null, "label" = null where "deleted" and ("address" is not null or "label" is not null);
(L'expression régulière de l'instruction est abrégée ici : l'erreur l'écrit en entier.)
Chaque entrée est essayée. Une entrée dont le registre ne peut pas être construit, ou dont la
base refuse de lire la table (un rôle sans le droit d'utiliser le schéma), ne cache pas les
autres : elle est dite sous son nom avec ce qui a échoué, dans unread de la même erreur, et les
tables restantes sont lues quand même. Ce qui a échoué est dit en quelques mots, le message du
pilote et jamais l'instruction dans laquelle un ORM l'enveloppe.
Une base injoignable n'est pas un refus du démarrage. La vérification dit les tables qui ne
sont pas prêtes ; elle ne fait pas attendre sa base à une application, qui ne l'attendait pas
avant sa première requête. Quand la lecture ne trouve pas de base (une connexion refusée, un hôte
introuvable, un délai dépassé, une connexion que le serveur ferme, lus à travers l'enveloppe de
chaque ORM), elle s'arrête là et le démarrage se poursuit, en 'required' comme en 'reported',
avec un seul avertissement qui le dit et dit pourquoi (ECONNREFUSED 127.0.0.1:5432) ; chaque
registre refuse encore avant sa première trace. Une base qui répond et refuse la lecture (un
droit, une instruction qui échoue) est une table non lue, qui arrête un démarrage 'required'.
db:read-models sort avec le code 3 sur une base qu'il ne peut pas joindre, avec la même cause
courte.
Ce pour quoi une table est lue. Les colonnes que le registre associe comme champs de sa ligne, et aucune autre : la clé, la colonne du locataire sous le nom que le registre lui donne, le tampon sous les noms que la définition lui donne, une colonne que le registre n'associe pas (une clé primaire de substitution, une colonne que la base remplit, une colonne qui appartient à quelqu'un d'autre) ne sont jamais comptées, jamais modifiées et jamais vidées. D'une colonne associée, la base dit si elle refuse NULL, ce qu'une migration ouvre, ou si rien ne peut l'ouvrir : une partie de la clé primaire, une colonne d'identité, une colonne générée, une colonne d'un domaine qui refuse NULL, une colonne que la table n'a pas. Une telle colonne est nommée avec ce qu'elle est et aucune instruction n'est écrite pour elle : le registre doit cesser de l'associer comme champ. Une table absente de la base est dite telle, puisque sa migration n'a pas été exécutée. Sur Drizzle et TypeORM, une définition qui déclare un champ NOT NULL refuse le registre à sa construction, quoi que tienne la base : la liste rapporte ce refus comme les autres, et n'écrit aucune instruction avant que la définition soit corrigée. Sur TypeORM, la table et ses colonnes sont nommées comme la base les tient, par la stratégie de nommage de la source de données.
La migration, en deux étapes. Elle est écrite d'après cette lecture (steps de l'erreur tient
les deux, statements les deux dans l'ordre). La première est le changement de définition, une
seule instruction : NOT NULL retiré des champs qui le refusent et, dans le même alter table, la
contrainte de vérification réécrite avec les champs qu'elle tenait et ceux qui viennent de perdre
NOT NULL, not valid. C'est une seule instruction pour qu'aucune ligne ne soit écrite entre les
deux, quoi qui valide chaque instruction, et elle lit d'abord la contrainte que la base tient sous
ce nom : celle qui n'est pas écrite comme le kit l'écrit n'est jamais supprimée, l'instruction
échoue sur elle, en nommant la contrainte et sa table, et ne change rien. La seconde étape valide la contrainte et vide les lignes
supprimées auparavant, celles qui tiennent encore des données seulement. Chaque identifiant est
entre guillemets, le délimiteur dollar de la première étape est un délimiteur qu'aucun nom de
l'instruction ne porte, et les instructions ne portent ni barre oblique inverse ni point
d'interrogation, si bien qu'une chaîne de JavaScript ou knex.raw les transporte telles quelles ;
une colonne dont le nom porte lui-même un point d'interrogation est l'exception, et l'erreur le
dit sous ses instructions : écrivez-le \? dans knex.raw. Exécutée deux
fois, la migration finit là où elle a fini la première fois et n'échoue sur rien. C'est la
migration de la base qui a été lue : lancez db:read-models sur chaque environnement.
Une grande table exécute la seconde étape à part. La première étape prend ACCESS EXCLUSIVE, qui arrête lecteurs et écrivains, et le tient jusqu'à la fin de sa transaction. Validée dans cette transaction, la contrainte est vérifiée sur toute la table sous ce verrou. Hors d'elle, la validation prend SHARE UPDATE EXCLUSIVE et la mise à jour ROW EXCLUSIVE, qui n'arrêtent ni les uns ni les autres. Sur une petite table, une migration avec les deux étapes convient. Sur une grande, la seconde étape va dans une migration à elle, et chaque outil demande quelque chose de plus pour l'exécuter hors de la transaction de la première (par outil).
Ce que la vérification lit à côté des colonnes, en avertissements. Une table dont les champs
acceptent NULL n'est pas refusée pour ses contraintes : une ligne peut n'exiger aucun champ. Ce
que la base tient sous <table>_live_rows_whole est lu quand même, sur les quatre ORM de la même
façon : absente, tenue avec les champs qu'elle nomme, non validée, ou une autre vérification.
Seule la forme que le kit écrit, telle que PostgreSQL la réaffiche, est lue comme tenant des
champs : (deleted or title is not null) and .. ou deleted or not (..) sous ce nom est une autre
vérification. Le démarrage avertit, et db:read-models affiche, une contrainte non validée (avec
l'instruction qui la valide), une autre vérification sous ce nom, toute autre contrainte de
vérification de la table qui nomme un champ de la ligne (celle qui y refuse NULL refuse une
trace ; celle qui est écrite pour les seules lignes vivantes, deleted or .., laisse entrer toute
trace et n'est pas nommée), et une table qui est une vue, dont les colonnes de base ne sont pas
lues.
Au démarrage, les tables des contextes que l'application héberge. Un projet généré garde la
liste dans src/platform/database/read-model-tables.ts, entre des marqueurs : une entrée est le
contexte d'un modèle de lecture et la classe de son registre, ['billing', KnexInvoiceSummaries].
Le contexte est l'un de ceux que le fichier tient dans Contexts, que generate context
remplit : une entrée sous un autre nom, mal orthographié compris, ne compile pas. generate read-model ajoute le registre qu'il écrit ; init, avec ou sans --force, ajoute les registres
que l'arbre contient et que la liste ne contient pas, si bien qu'un projet généré avant
l'existence de la liste la retrouve remplie. Il lit chaque classe de chaque contexte, plusieurs
dans un même fichier comprises et tests mis à part, et tient pour un registre une classe qui n'est
pas abstraite au-dessus du registre du kit de l'un des quatre ORM (KnexReadModelStore et ses
trois pareils), directement ou par des classes du projet. Un nom de classe que deux
contextes partagent est importé sous un alias qui porte le contexte (KnexSummaries as ShippingKnexSummaries), par le générateur comme par init. Un registre qu'il ne peut pas lister
avec certitude (son propre constructeur n'est pas celui d'un registre généré, ou est hérité ; la
classe est générique ; son fichier ne l'exporte pas par son nom) est nommé dans une note, avec la
raison, et dans NOT_LISTED, que la vérification dit à chaque démarrage tant que le registre
n'est pas listé : une classe écrite à côté de lui, dans un fichier à elle, qui l'étend avec le
constructeur d'un registre généré ((database: <Type>) ou
(database: <Type>, scope: ExecutionScope), <Type> étant un nom ou un membre d'un nom comme
Persistence['database']) est listée par init et en répond. Un registre laissé de côté exprès
est un commentaire qui porte <contexte>: <Registre> et la raison, écrit entre les marqueurs de
LISTED (// ddd-ts-kit:read-model-tables) : init le laisse alors de côté, et rien n'en
avertit. init --force garde ce que contiennent les marqueurs qu'il écrit et rien d'autre, une paire de marqueurs ajoutée à la main comprise, si bien qu'un commentaire, ou une classe, écrit ailleurs dans le fichier est perdu au suivant, et
qu'un tel commentaire ne laisse rien de côté ; une entrée simplement supprimée revient au prochain
init --force.
Un registre écrit à la main et jamais listé est signalé. ddd-ts-kit check lit les registres
de l'arbre comme init, par la même lecture, et persistence/read-model-listed signale, en
erreur, chacun de ceux dont la liste ne répond pas : aucune entrée de LISTED sous son contexte
ne le nomme ni ne nomme une classe qui l'étend, NOT_LISTED ne le nomme pas, et aucun commentaire
entre les marqueurs ne porte <contexte>: <Registre>. Une entrée importée par un fichier qui réexporte la classe, export { A as B } from ou export * from, sur un niveau, répond de la classe à laquelle ce nom mène, et d'aucun autre registre que ce fichier réexporte. Son correctif donne l'import et
l'entrée à ajouter, l'entrée seule quand la liste importe encore la classe, et, pour un registre
que la liste ne peut pas construire, ce qui s'y oppose. Le constat est posé sur le fichier du
registre et se répare dans la liste : check interrogé sur la seule liste, comme le crochet de
pré-commit l'interroge sur les fichiers indexés, le signale aussi. La liste est tenue à l'arbre
elle aussi : une entrée dont le fichier n'importe ni ne déclare la classe, dont l'import ne mène
à aucun fichier, ou dont un autre contexte déclare la classe, et une ligne de NOT_LISTED dont
la classe a disparu ou dont LISTED répond du registre. Un projet sur l'un des quatre ORM qui
contient des registres et aucune liste, généré avant la 0.112.0, est signalé une fois, avec
ddd-ts-kit init --force pour correctif ; sans l'un d'eux, init n'écrit pas de liste et la
règle ne dit rien. Un LISTED dont les entrées sont étalées ou construites par un appel ne peut
pas être lu : la règle le dit une fois et ne juge aucun registre. Ce que la règle ne juge pas,
puisque le texte ne le dit pas : une classe abstraite ; un registre en mémoire ou dans un moteur de recherche, et une classe directement au-dessus de TableReadModelStore du noyau ; un registre des tests ; une classe déclarée dans une fonction ou dans un bloc namespace, et une expression de classe qui n'a pas de nom à elle (celle qui en a un est lue sous ce nom) ; une base qui n'est pas le nom du registre du kit ni d'une classe du projet : un espace de noms (kit.KnexReadModelStore), un alias d'import, un appel (mixin(KnexReadModelStore)) ; de deux classes de même nom dans un même contexte, laquelle une entrée nomme ; le fait qu'une classe qui étend un registre lise la même table ; la raison que donne un commentaire ; ce qu'un paquet exporte
(npx ddd-ts-kit explain persistence/read-model-listed).
Où la vérification tourne. Une application vérifie, à son démarrage et avant
qu'un consommateur soit abonné ou une requête servie, les entrées des contextes qu'elle héberge
(le module de la plateforme sur tsyringe, InversifyJS et Awilix, dans le style déclaré comme
explicite ; start de compose-application.ts sur une plateforme câblée à la main).
L'application entière et le worker hébergent tous les contextes sauf ceux exécutés en services ;
un service (generate service) héberge son seul contexte, si bien qu'une fois son schéma et ses
migrations déplacés vers une base à lui, chaque racine démarre sur les tables qu'elle a. Elle est
active par défaut, deux courtes lectures du catalogue par table listée, aucune ligne et aucun
verrou.
Un déploiement qui démarre l'application avant que ses migrations soient passées. Par défaut
le démarrage échoue, et c'est la réponse sûre d'un déploiement progressif : les nouvelles instances
ne deviennent jamais prêtes, les anciennes continuent de servir, et les nouvelles démarrent une
fois la migration passée. Une chaîne où la migration attend que la nouvelle version soit en
service attendrait sans fin : elle passe readModelTables: 'reported' à composeApplication dans
main.ts. Le même message est alors journalisé en une erreur, une table qui n'a pas pu être lue
comprise, le démarrage se poursuit, et chaque registre refuse encore par son nom avant sa première
trace.
Avant un déploiement. DATABASE_URL=<la base du déploiement> npm run db:read-models exécute la
même vérification depuis la ligne de commande (scripts/read-model-tables.ts), sur chaque table
listée ; npm run db:read-models -- --context billing, une fois par contexte, sur les tables de
ces contextes, comme le service de billing les vérifie sur sa base. Il lui faut l'adresse de la
base et aucune autre variable de l'application. Un fichier .env donne l'adresse quand la ligne
de commande ne la donne pas : le script affiche donc d'abord la base qu'il lit (son nom et son
hôte, jamais les identifiants), puis combien de tables il a lues et leurs noms, les avertissements
et chaque refus. Son code de sortie distingue les cas : 0 quand chaque table listée est prête, 1
quand l'une ne l'est pas, 2 quand DATABASE_URL ne nomme aucune base, 3 quand aucune table n'a pu
être lue (la base ne répond pas, ou refuse la lecture), 4 quand --context nomme un contexte
auquel aucun modèle de lecture listé n'appartient, avec les contextes que tient la liste : un nom
mal orthographié ne passe jamais pour une vérification. Lancée sur la base de l'environnement une
fois ses migrations passées, c'est la porte du déploiement ; lancée après npm run db:migrate sur
une base vide, comme en a une chaîne d'intégration, elle dit la même chose des migrations du
projet, une table qu'elles ne créent jamais comprise. C'est un script du projet et non une
commande de ddd-ts-kit, qui n'a aucun pilote de base de données : le script lit par les registres
que le projet a déjà. Rien ne lit les fichiers de migration eux-mêmes : les quatre outils les
écrivent sous quatre formes, et ce qu'un fichier dit d'une colonne n'est pas ce que tient la base
une fois toutes les migrations passées.
Ce que la vérification ne fait pas :
- Elle ne prouve pas qu'une trace sera écrite. Elle lit ce qui refuse NULL sur les colonnes elles-mêmes, le domaine d'une colonne, et la contrainte des lignes vivantes ; elle avertit des autres contraintes de vérification et d'une vue. Elle ne lit ni un déclencheur, ni une règle, ni une contrainte de vérification d'un domaine, ni une contrainte d'exclusion, ni la table sous une vue : une table trouvée prête peut encore refuser une trace pour l'une de ces raisons, et le registre échoue alors sur l'instruction.
- Un registre qui n'est pas listé n'est pas vérifié.
generate read-modeletinitlistent ce qu'ils savent lire dans l'arbre ; un registre écrit à la main ensuite s'ajoute à la main, et celui qui manque à la liste est refusé, comme avant, par son propre registre avant sa première trace. - Une base par locataire se vérifie par la connexion de chacune ; un schéma par locataire par le chemin de recherche de la connexion donnée à la vérification.
- Un modèle de lecture sur OpenSearch ou en mémoire n'a pas de telle table. La trace d'une suppression est un document qui garde sa clé et son tampon, et un mapping ne refuse aucun champ absent : il n'y a rien à migrer, et l'index de chaque registre est déjà provisionné au démarrage. Listé, un tel registre n'a rien à dire.
Limites et quand ne pas l'utiliser
Section intitulée « Limites et quand ne pas l'utiliser »- Un contexte CRUD sans règles (une liste de salles, un écran de réglages) gagne peu à avoir
une commande, un gestionnaire, un bus et un port de lecture par opération. Le générateur rend
les fichiers bon marché à créer, pas à lire. Un contexte
generic, ou un contextesupportingmince, peut garder un modèle trivial ; abandonner la séparation pour lui est une décision enregistrée, pas une habitude. - « Une commande renvoie au plus un identifiant » crée des frictions. Un client qui a besoin de la ressource créée fait un second appel. C'est voulu ; quand l'aller-retour compte, la route peut envoyer la requête après la commande et renvoyer son résultat.
- Lire ses propres écritures n'est pas automatique dès qu'une lecture vient d'une projection alimentée par des événements. Lisez alors cet écran depuis les tables d'écriture, ou concevez l'interface pour ce délai.
- L'ordre des middlewares compte, et il est invisible depuis un gestionnaire. Lisez
src/platform/buses/create-command-bus.tsetcreate-query-bus.tspour savoir ce qui enveloppe un cas d'usage. - Un gestionnaire de requête qui a besoin d'une règle du domaine (un prix, une éligibilité) doit appeler le domaine pour l'obtenir, pas la recopier en SQL. Contourner les agrégats sert la forme, pas la logique.
- Bertrand Meyer, Object-Oriented Software Construction, 2e édition, Prentice Hall, 1997 (séparation commande-requête).
- Greg Young, « CQRS Documents », 2010, https://cqrs.files.wordpress.com/2010/11/cqrs_documents.pdf
- Martin Fowler, « CQRS », 2011, https://martinfowler.com/bliki/CQRS.html
- Martin Fowler, « Event Sourcing », 2005, https://martinfowler.com/eaaDev/EventSourcing.html
- Vaughn Vernon, Implementing Domain-Driven Design, Addison-Wesley, 2013, chapitre 4 (« Architecture », la section sur CQRS).
- Vlad Khononov, Learning Domain-Driven Design, O'Reilly, 2021, chapitre 8 (CQRS).