
@ddd-ts-kit/drizzle
Les adaptateurs Drizzle des ports du noyau et des événements sur PostgreSQL : une unité de travail que les repositories ne voient jamais, le store de l'outbox transactionnelle, le store des événements traités, et un schéma de base de données par contexte délimité (bounded context). Drizzle est la persistance par défaut du kit, pas une obligation : tout ici implémente des ports, et un autre ORM est un autre adaptateur qui passe les mêmes suites de contrat.
npm i @ddd-ts-kit/drizzle drizzle-ormFonctionne avec tous les pilotes PostgreSQL de drizzle (node-postgres, postgres-js, PGlite,
Neon) : les fonctions sont génériques sur le type de la base, si bien qu'executor() est typé
exactement comme votre db.
Sa place dans une application
Section intitulée « Sa place dans une application »Rien d'ici n'est importé depuis domain/ ni application/. Un gestionnaire (handler) dépend du
port de repository de son domaine ; l'adaptateur de ce port, dans infrastructure/, exécute
ses instructions sur la Database du projet ; la plateforme construit l'unité de travail une
fois et la lie.
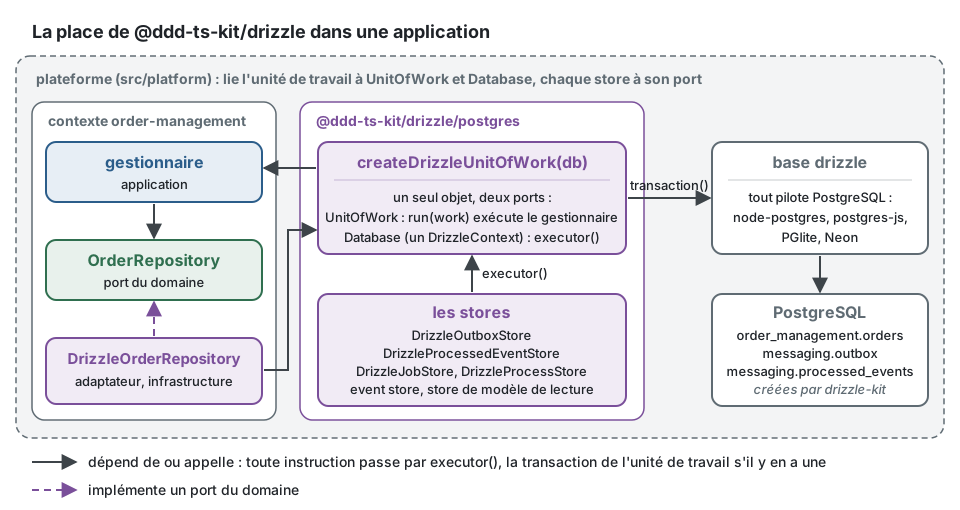
L'idée à retenir : toute instruction passe par executor(). Dans une unité de travail,
c'est la transaction de cette unité de travail : la ligne de l'agrégat, l'enregistrement
d'outbox de l'événement qu'il a publié et la marque d'événement traité d'un consommateur sont
validés ou annulés ensemble. Hors d'une unité de travail (une requête, un script), c'est la base
elle-même.
Les tables sont de simples définitions drizzle : exportez-les depuis les fichiers de schéma que lit drizzle-kit, et vos propres migrations les créent.
import { integer, text } from 'drizzle-orm/pg-core';import { contextSchema, outboxTable, processedEventsTable } from '@ddd-ts-kit/drizzle/postgres';
export const outbox = outboxTable('messaging'); // messaging.outbox ; sans argument : public.outboxexport const processedEvents = processedEventsTable('messaging');
// contexts/order-management/infrastructure/persistence/order-management.schema.tsexport const orderManagement = contextSchema('order-management'); // schéma order_managementexport const orders = orderManagement.table('orders', {  id: text('id').primaryKey(),  status: text('status').notNull(),  version: integer('version').notNull(),});
outbox est indexée pour le relais (les enregistrements en attente par prochaine tentative,
index partiel) ; processed_events a (consumer, event_id) pour clé primaire.
Racine de composition
Section intitulée « Racine de composition »DrizzleContext est la poignée sur laquelle les repositories et les stores exécutent leurs
requêtes. Il est générique sur la base drizzle : le projet nomme donc sa propre base par une
classe, qui est alors le jeton d'injection :
import type { PgQueryResultHKT } from 'drizzle-orm/pg-core';import { DrizzleContext } from '@ddd-ts-kit/drizzle/postgres';
export abstract class Database extends DrizzleContext<PgQueryResultHKT> {}
C'est la classe qu'écrit la CLI : typée sur la base neutre vis-à-vis du pilote, si bien que les
mêmes repositories tournent sur node-postgres en production et sur PGlite dans les tests, la
connexion étant typée PgDatabase<PgQueryResultHKT>. Un projet lié à un seul pilote peut nommer
sa sorte à la place (DrizzleContext<NodePgQueryResultHKT>), ce qui type exactement le résultat
brut d'execute.
createDrizzleUnitOfWork(db) donne un seul objet qui est à la fois le UnitOfWork du noyau et
cette Database. Liez-le aux deux :
import { drizzle } from 'drizzle-orm/node-postgres';import type { PgDatabase, PgQueryResultHKT } from 'drizzle-orm/pg-core';import { defineContextModule } from '@ddd-ts-kit/di';import { IntegrationEventPublisher, ProcessedEventStore, UnitOfWork } from '@ddd-ts-kit/kernel';import { OutboxPublisher, OutboxStore } from '@ddd-ts-kit/events';import {  createDrizzleUnitOfWork,  DrizzleOutboxStore,  DrizzleProcessedEventStore,} from '@ddd-ts-kit/drizzle/postgres';import { Database } from '@/platform/database/database';import { outbox, processedEvents } from '@/platform/database/schema';
const db: PgDatabase<PgQueryResultHKT> = drizzle(process.env.DATABASE_URL);const unitOfWork = createDrizzleUnitOfWork(db);
export const persistenceModule = defineContextModule({ name: 'persistence', register(builder) { builder.rebind(UnitOfWork).toValue(unitOfWork); builder.bind(Database).toValue(unitOfWork); builder .bind(OutboxStore) .toFactory((resolve) => new DrizzleOutboxStore(resolve(Database), { table: outbox })); builder .rebind(ProcessedEventStore) .toFactory((resolve) => new DrizzleProcessedEventStore(resolve(Database), { table: processedEvents })); builder.rebind(IntegrationEventPublisher).toClass(OutboxPublisher, [OutboxStore]); },});const app = createApplication({ modules: [kernelModule(), persistenceModule, contextModule('order-management', orderManagementDeclarations)] });Placez le module après kernelModule() : rebind remplace ses valeurs par défaut en mémoire.
Le bus de commandes du module du noyau exécute chaque commande dans le UnitOfWork lié ; les
gestionnaires n'en savent rien. contextModule de @ddd-ts-kit/di transforme les classes
déclarées d'un contexte en son module.
Un projet écrit par la CLI contient le même câblage en deux fichiers :
platform/database/persistence-over.ts construit l'unité de travail et les deux stores une
fois, et platform/composition/platform.module.ts les lie, le publisher de l'outbox étant passé à
kernelModule({ eventPublisher }).
Les fabriques passent les tables du schéma messaging. Avec les tables dans public, les
stores n'ont besoin d'aucune option et la classe se lie directement :
builder.bind(OutboxStore).toClass(DrizzleOutboxStore, [Database]),
builder.rebind(ProcessedEventStore).toClass(DrizzleProcessedEventStore, [Database]).
Le relais lit le même store et remet les enregistrements au broker :
const relay = new OutboxRelay({ store: app.resolve(OutboxStore), publisher: broker, clock: app.resolve(Clock) });relay.start({ intervalMs: 500 });unitOfWork.run(work) ouvre db.transaction et garde la transaction dans un
AsyncLocalStorage ; un run imbriqué rejoint la transaction englobante. Comme append
utilise la transaction courante, un événement publié par un gestionnaire qui échoue ensuite est
annulé avec l'écriture métier : c'est toute la raison d'être de l'outbox.
run repose sur withinUnitOfWork du noyau. Les événements du domaine des agrégats enregistrés
à l'intérieur attendent que work ait rendu la main, puis sont distribués dans la transaction,
avant la validation (commit) : leurs gestionnaires voient chaque enregistrement, et ce qu'ils
écrivent est validé ou annulé avec. Si work, un gestionnaire ou la validation échoue, il ne
reste rien : aucune ligne, aucun enregistrement d'outbox, aucun gestionnaire exécuté après la
validation. Les gestionnaires déclarés after-commit s'exécutent une fois la transaction
validée. Un run imbriqué rejoint l'unité de travail en cours : une seule distribution, à la fin
de la plus externe. Un run appelé directement (un consommateur, un script) suit le même
déroulé qu'une commande. unitOfWorkContract de @ddd-ts-kit/testing/contracts le prouve sur
PGlite, avec une contrainte différée pour la validation qui échoue. Le README de
@ddd-ts-kit/kernel dessine ce déroulé
(Événements du domaine et unité de travail).
Repository
Section intitulée « Repository »Le port vit dans le domaine, l'adaptateur dans l'infrastructure. Un repository reçoit la base,
jamais une transaction : executor() est la transaction de l'unité de travail s'il y en a une,
et db sinon.
// Au lieu de : une transaction transmise par l'appelant, que chaque port et chaque gestionnaire porteraient alorssave(order: Order, transaction: PgTransaction<PgQueryResultHKT>): Promise<void>;
// Écrivez : la base, dont l'executor() est la transaction de l'unité de travail en coursconstructor(private readonly database: Database) {}
Côté domaine, un agrégat qui ne sait rien des lignes, et son port :
import { AggregateRoot, DomainRefusal, Repository } from '@ddd-ts-kit/kernel';
export const OrderManagementCodes = {  OrderAlreadyPlaced: 'ORDER_ALREADY_PLACED',} as const;
// contexts/order-management/domain/errors/order-already-placed.error.tsexport class OrderAlreadyPlaced extends DomainRefusal {  readonly code = OrderManagementCodes.OrderAlreadyPlaced;
  static forOrder(orderId: string) {    return OrderAlreadyPlaced.refusal(`Order ${orderId} is already placed.`, { orderId });  }}
// contexts/order-management/domain/order.aggregate.tsexport type OrderStatus = 'open' | 'placed';
export class Order extends AggregateRoot {  private constructor(    id: string,    private status: OrderStatus,  ) {    super(id);  }
  static open(id: string): Order {    return new Order(id, 'open');  }
  /** Reconstruit une commande enregistrée : réservé au mapper. */  static rehydrate(id: string, status: OrderStatus): Order {    return new Order(id, status);  }
  get currentStatus(): OrderStatus {    return this.status;  }
  place(): void {    if (this.status === 'placed') {      throw OrderAlreadyPlaced.forOrder(this.id);    }
    this.status = 'placed';  }}
// contexts/order-management/domain/repositories/order.repository.ts : findById et save viennent de Repositoryexport abstract class OrderRepository extends Repository<Order> {}
Côté infrastructure, la table, le mapper et l'adaptateur :
import { and, eq } from 'drizzle-orm';import { integer, text, type PgQueryResultHKT } from 'drizzle-orm/pg-core';import { AggregateRoot } from '@ddd-ts-kit/kernel';import { Repository } from '@ddd-ts-kit/kernel/declarations';import { contextSchema, DrizzleContext, insertIgnoringConflict, optimisticUpdate } from '@ddd-ts-kit/drizzle/postgres';
// L'agrégat et son port de l'exemple précédent, réduits à leur forme.type OrderStatus = 'open' | 'placed';declare class Order extends AggregateRoot {  static rehydrate(id: string, status: OrderStatus): Order;  get currentStatus(): OrderStatus;}abstract class OrderRepository {  abstract findById(id: string): Promise<Order | undefined>;  abstract save(order: Order): Promise<void>;}
// platform/database/database.ts : le jeton d'injection de la baseabstract class Database extends DrizzleContext<PgQueryResultHKT> {}
// order-management.schema.ts : la table de l'exemple de schéma, avec un statut typéconst orders = contextSchema('order-management').table('orders', {  id: text('id').primaryKey(),  status: text('status').$type<OrderStatus>().notNull(),  version: integer('version').notNull(),});
type OrderRow = typeof orders.$inferSelect;
// order.mapper.ts : la ligne ne quitte jamais l'infrastructureconst OrderMapper = {  toDomain(row: OrderRow): Order {    const order = Order.rehydrate(row.id, row.status);
    order.version = row.version; // la version qu'optimisticUpdate attendra
    return order;  },
  toRow(order: Order, version: number): OrderRow {    return { id: order.id, status: order.currentStatus, version };  },};
@Repository(OrderRepository)export class DrizzleOrderRepository implements OrderRepository {  constructor(private readonly database: Database) {}
  async findById(id: string): Promise<Order | undefined> {    // executor() : la transaction de l'unité de travail en cours, ou la base hors d'une unité de travail    const [row] = await this.database.executor().select().from(orders).where(eq(orders.id, id));
    return row === undefined ? undefined : OrderMapper.toDomain(row);  }
  async save(order: Order): Promise<void> {    const db = this.database.executor();
    await optimisticUpdate(order, async ({ expected, next }) => {      const row = OrderMapper.toRow(order, next);
      if (expected === 0) {        return (await insertIgnoringConflict(() => db.insert(orders).values(row), orders)) ? 1 : 0;      }
      const written = await db        .update(orders)        .set(row)        .where(and(eq(orders.id, order.id), eq(orders.version, expected)))        .returning({ id: orders.id });
      return written.length; // 0 ligne : optimisticUpdate lève ConcurrencyError    });  }}
Dans le style explicite, sans le décorateur, la même liaison tient en une ligne de
<context>.module.ts :
builder.bind(OrderRepository).toClass(DrizzleOrderRepository, [Database]).
optimisticUpdate donne la version attendue et la version à écrire, lève une
ConcurrencyError (une DomainError de code CONCURRENCY_CONFLICT) quand l'instruction gardée
n'a écrit aucune ligne, et fait avancer order.version sinon. Si votre base a été créée avec un
schéma relationnel (drizzle(url, { schema })), déclarez Database comme
DrizzleContext<PgQueryResultHKT, typeof schema> pour garder executor().query.
expected |
Instruction | Aucune ligne écrite signifie |
|---|---|---|
0 : jamais enregistré |
insertIgnoringConflict : INSERT ... ON CONFLICT DO NOTHING, puis ON CONFLICT (id) DO NOTHING quand elle n'a rien écrit |
l'id est déjà pris |
n |
UPDATE ... SET version = n + 1 WHERE id = ... AND version = n |
une autre transaction l'a enregistré depuis sa lecture |
insertIgnoringConflict(() => db.insert(orders).values(row), orders) insère sauf si la clé
primaire existe, telle que la table la déclare (primaryKeyOf(orders), l'id, ou chaque colonne
d'une clé qui porte le tenant), et dit si elle l'a fait. Elle prend deux instructions au plus,
c'est pourquoi l'insertion est donnée comme une fonction. Aucune des deux clauses de conflit ne
suffit seule. Sans cible, PostgreSQL écarte aussi une ligne qui prend une valeur qu'une autre ligne
détient sous une contrainte d'unicité (un e-mail), et l'enregistrement se lit comme une mise à
jour perdue. Avec la clé pour cible, deux premiers enregistrements d'un même agrégat faits en même
temps (une requête livrée deux fois) se rencontrent d'abord sur l'autre index unique, et celui qui
a perdu est refusé pour une valeur qu'aucune autre ligne ne détient, là où il a perdu une mise à
jour. La première instruction ne nomme donc aucune cible, et seulement quand elle n'a rien écrit
la seconde nomme la clé : une clé tenue n'écrit aucune ligne, ce que optimisticUpdate lève comme
une ConcurrencyError, et une valeur que détient une autre ligne est refusée par la base, ce
qu'elle lève comme une UniqueViolationError (code CONFLICT, 409), comme pour une mise à jour
qui prend une telle valeur.
Un verrou sur une clé métier
Section intitulée « Un verrou sur une clé métier »La concurrence optimiste protège une ligne qui existe. Une décision prise sur des lignes qui
n'existent pas encore (compter les réservations d'un créneau puis en insérer une, donner le
numéro suivant d'une séquence par tenant) n'a pas de version à comparer : deux unités de travail
lisent le même compte et écrivent toutes les deux. advisoryLock(context, key, { tenant }) les
met en file : il attend qu'aucune autre transaction ne tienne le verrou sur key, puis le tient
jusqu'à ce que l'unité de travail valide ou annule (pg_advisory_xact_lock). Rien ne le relâche
à la main.
import { advisoryLock } from '@ddd-ts-kit/drizzle/postgres';
async next(): Promise<number> {  // First in the unit of work, before the read it protects.  await advisoryLock(this.database, 'invoice-number', { tenant: this.scope });
return (await this.lastNumber()) + 1;}- La clé est un texte, que PostgreSQL hache vers le nombre de 64 bits qu'il verrouille
(
hashtextextended(text, 0)). Avectenant, unExecutionScope, le texte esttenant:<id>:<key>(tenantKeydu kernel) : deux tenants ne s'attendent jamais, et un travail qui ne nomme aucun tenant est refusé. Deux textes de même hachage, environ une paire sur 2^64, s'attendent comme le ferait une seule clé : une attente, jamais une réponse fausse. - Dans une unité de travail seulement. Hors d'une unité de travail, le verrou serait relâché
à la fin de son instruction :
AdvisoryLockOutsideUnitOfWorkError. Garder l'isolation par défaut,read committed: la lecture qui suit le verrou voit alors ce que le détenteur précédent a validé, là oùrepeatable readetserializablelisent à l'instant où le verrou a été demandé. tryAdvisoryLock(context, key, { tenant })n'attend pas :truequand il a pris le verrou,falsequand une autre transaction le tient (pg_try_advisory_xact_lock).- Un cas d'usage n'importe aucun package d'ORM. Le verrou se place dans la méthode du
repository qui en a besoin, ou derrière un port du contexte (
InvoiceNumbering.reserve()) dont l'adaptateur est ce seul appel et dont le fake ne fait rien. - PostgreSQL seulement. Dans un projet multitenant,
tenancy/scoped-statementaccepte le helper et signale unpg_advisory_xact_lockécrit à la main, comme tout SQL brut. - Tenu au contrat
advisoryLockContractde@ddd-ts-kit/testing/contracts. L'attente d'une seconde unité de travail est prouvée sur un vrai serveur : PGlite est une seule session, où la seconde attend la connexion elle-même.
Colonnes d'audit, restriction au tenant et pages
Section intitulée « Colonnes d'audit, restriction au tenant et pages »Les formes de persistance standard du noyau, sur drizzle. auditColumns() et tenantColumn()
sont des helpers de colonnes à étaler dans une table : leurs clés sont celles des AuditStamp
et TenantScoped du noyau, si bien qu'un tampon s'étale tel quel dans une insertion, et les
colonnes portent les mêmes noms dans tous les projets (created_at, created_by,
updated_at, updated_by, tenant_id) : c'est ce qui permet d'écrire une seule fois un tableau
de bord, un export ou le package d'audit.
La table, puis le repository. Il lit par tenantCondition et écrit par ownTenantCondition,
les deux conditions de l'Isolation des tenants :
import { and, eq } from 'drizzle-orm';import { index, integer, text, type PgQueryResultHKT } from 'drizzle-orm/pg-core';import { AggregateRoot, Clock, ExecutionScope, stampCreation, stampUpdate, tenantScopeOf } from '@ddd-ts-kit/kernel';import { Repository } from '@ddd-ts-kit/kernel/declarations';import {  auditColumns,  contextSchema,  DrizzleContext,  insertIgnoringConflict,  optimisticUpdate,  ownTenantCondition,  tenantColumn,  tenantCondition,} from '@ddd-ts-kit/drizzle/postgres';
// L'agrégat, son port et la base, réduits à leur forme.type InvoiceStatus = 'draft' | 'issued';declare class Invoice extends AggregateRoot {  static rehydrate(id: string, amount: number, status: InvoiceStatus): Invoice;  get amount(): number;  get status(): InvoiceStatus;}abstract class InvoiceRepository {  abstract findById(id: string): Promise<Invoice | undefined>;  abstract save(invoice: Invoice): Promise<void>;}abstract class Database extends DrizzleContext<PgQueryResultHKT> {}
// contexts/billing-core/infrastructure/persistence/invoices.tsexport const invoices = contextSchema('billing-core').table(  'invoices',  {    id: text('id').primaryKey(),    amount: integer('amount').notNull(),    status: text('status').$type<InvoiceStatus>().notNull(),    version: integer('version').notNull(),    ...tenantColumn(),    ...auditColumns(),  },  // l'ordre des requêtes de liste, champ qui départage compris, pour qu'une page se lise dans l'index  (table) => [index('invoices_tenant_amount_idx').on(table.tenantId, table.amount, table.id)],);
/** Ce que l'agrégat dit de lui-même, plus la version à stocker : le reste de la ligne revient à l'adaptateur. */interface VersionedInvoice {  readonly id: string;  readonly amount: number;  readonly status: InvoiceStatus;  readonly version: number;}
@Repository(InvoiceRepository)export class DrizzleInvoiceRepository implements InvoiceRepository {  constructor(    private readonly database: Database,    private readonly scope: ExecutionScope,    private readonly clock: Clock,  ) {}
  async findById(id: string): Promise<Invoice | undefined> {    const [row] = await this.database      .executor()      .select()      .from(invoices)      .where(and(eq(invoices.id, id), tenantCondition(invoices.tenantId, this.scope)));
    if (row === undefined) {      return undefined;    }
    const invoice = Invoice.rehydrate(row.id, row.amount, row.status);
    invoice.version = row.version;
    return invoice;  }
  async save(invoice: Invoice): Promise<void> {    await optimisticUpdate(invoice, async ({ expected, next }) => {      const state = { id: invoice.id, amount: invoice.amount, status: invoice.status, version: next };
      return expected === 0 ? this.insert(state) : (await this.update(state, expected)).length;    });  }
  private async insert(state: VersionedInvoice): Promise<number> {    // tenant_id vient du travail en cours, created_* et updated_* de son acteur et de la Clock    const row = { ...state, ...tenantScopeOf(this.scope), ...stampCreation(this.scope, this.clock) };    const insertion = () => this.database.executor().insert(invoices).values(row);
    return (await insertIgnoringConflict(insertion, invoices)) ? 1 : 0;  }
  private update(state: VersionedInvoice, expected: number) {    return this.database      .executor()      .update(invoices)      .set({ ...state, ...stampUpdate(this.scope, this.clock) }) // laisse created_at et created_by intacts      .where(        and(          eq(invoices.id, state.id),          eq(invoices.version, expected),          ownTenantCondition(invoices.tenantId, this.scope),        ),      )      .returning({ id: invoices.id });  }}
Une requête de recherche prend la PageRequest du noyau et renvoie une Page, dans ses deux
variantes :
export abstract class InvoiceQueries { abstract search(request: PageRequest<'amount'>): Promise<Page<InvoiceSummary>>;}import { and, asc, desc, eq, gt, lt, or, type SQL } from 'drizzle-orm';import { index, integer, text, type PgQueryResultHKT } from 'drizzle-orm/pg-core';import { ExecutionScope, InvalidPageRequestError, decodeCursor, encodeCursor, pageOf, type CursorPageRequest, type OffsetPageRequest, type Page, type PageRequest, type SortDirection,} from '@ddd-ts-kit/kernel';import { Repository } from '@ddd-ts-kit/kernel/declarations';import { contextSchema, DrizzleContext, tenantColumn, tenantCondition } from '@ddd-ts-kit/drizzle/postgres';
// Le port de l'application, la base et la table des exemples précédents, réduits à leur forme.interface InvoiceSummary { readonly id: string; readonly amount: number;}abstract class InvoiceQueries { abstract search(request: PageRequest<'amount'>): Promise<Page<InvoiceSummary>>;}abstract class Database extends DrizzleContext<PgQueryResultHKT> {}const invoices = contextSchema('billing-core').table( 'invoices', { id: text('id').primaryKey(), amount: integer('amount').notNull(), ...tenantColumn() }, (table) => [index('invoices_tenant_amount_idx').on(table.tenantId, table.amount, table.id)],);
@Repository(InvoiceQueries)export class DrizzleInvoiceQueries implements InvoiceQueries { constructor( private readonly database: Database, private readonly scope: ExecutionScope, ) {}
search(request: PageRequest<'amount'>): Promise<Page<InvoiceSummary>> { return request.kind === 'offset' ? this.byOffset(request) : this.byCursor(request); }
private async byOffset(request: OffsetPageRequest<'amount'>): Promise<Page<InvoiceSummary>> { const db = this.database.executor(); const own = tenantCondition(invoices.tenantId, this.scope); const rows = await db .select() .from(invoices) .where(own) .orderBy(...totalOrder(directionOf(request))) .limit(request.limit) .offset(request.offset);
return pageOf(rows.map(toSummary), { total: await db.$count(invoices, own) }); }
private async byCursor(request: CursorPageRequest<'amount'>): Promise<Page<InvoiceSummary>> { const direction = directionOf(request); const after = request.cursor === undefined ? undefined : beyond(positionOf(request.cursor), direction); const rows = await this.database .executor() .select() .from(invoices) .where(and(tenantCondition(invoices.tenantId, this.scope), after)) .orderBy(...totalOrder(direction)) .limit(request.limit + 1); // une ligne de plus que demandé : elle dit si une page suit const items = rows.slice(0, request.limit); const last = items.at(-1); const more = rows.length > request.limit && last !== undefined;
return pageOf(items.map(toSummary), more ? { nextCursor: encodeCursor({ amount: last.amount, id: last.id }) } : {}); }}
const directionOf = (request: PageRequest<'amount'>): SortDirection => request.sort[0]?.direction ?? 'asc';
const toSummary = (row: typeof invoices.$inferSelect): InvoiceSummary => ({ id: row.id, amount: row.amount });
// La clé primaire suit le champ de tri, dans le même sens : l'ordre est total.function totalOrder(direction: SortDirection): SQL[] { const toward = direction === 'asc' ? asc : desc;
return [toward(invoices.amount), toward(invoices.id)];}
// Les lignes après une position, en comparaison de tuples : le champ qui départage tranche entre égaux.function beyond({ amount, id }: { amount: number; id: string }, direction: SortDirection): SQL | undefined { const past = direction === 'asc' ? gt : lt;
return or(past(invoices.amount, amount), and(eq(invoices.amount, amount), past(invoices.id, id)));}
// Un curseur revient d'un client : ce qu'il décode est vérifié avant d'atteindre une instruction.function positionOf(cursor: string): { amount: number; id: string } { const { amount, id } = decodeCursor(cursor);
if (typeof amount !== 'number' || typeof id !== 'string') { throw new InvalidPageRequestError('The cursor of a page is the nextCursor of a previous page'); }
return { amount, id };}Un adaptateur de lecture sur la base de données se déclare avec @Repository, comme ceux que
génère la CLI : sa nature est repository. Déclaré avec @Adapter, il serait external, et
une plateforme générée entoure chaque adaptateur external et gateway d'une nouvelle
tentative (retry) et d'une limite de temps, ce qu'une instruction de l'unité de travail ne doit
pas recevoir.
Ce que font les deux sortes de page quand une ligne est insérée entre deux lectures :
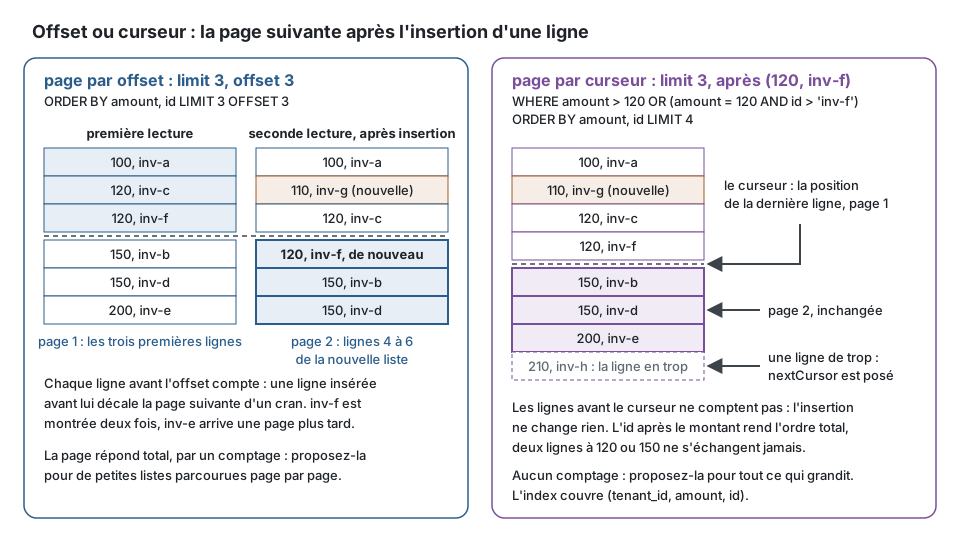
Les règles que tiennent ces exemples, et que les tests de ce package vérifient sur une vraie base de données :
- Les colonnes d'audit sont remplies par l'adaptateur, jamais par l'agrégat :
stampCreation(scope, clock)à l'insertion,stampUpdate(scope, clock)à la mise à jour, qui laissecreated_atetcreated_byintacts. L'acteur est celui de la portée d'exécution : l'utilisateur de la requête HTTP, ousystem:<consumer>pour un événement consommé. - Le tenant fait partie de chaque instruction : écrit à l'insertion, et dans la condition de
chaque lecture et de chaque mise à jour, garde de version comprise. Une ligne d'un autre
tenant n'est pas trouvée, et une mise à jour qui la vise n'écrit rien, ce que
optimisticUpdatesignale par uneConcurrencyError. Un travail qui ne nomme aucun tenant lèveNoCurrentTenantErroravant tout SQL. - Une liste a un ordre total. La clé primaire suit le champ de tri, dans le même sens, pour
départager : sans elle, des lignes égales sur le champ de tri n'ont pas d'ordre défini, et une
page pourrait en répéter ou en sauter une. L'index couvre
(tenant_id, <sort field>, id). - Un curseur est une position, pas un numéro de page : la valeur de tri et l'id de la
dernière ligne, écrits par
encodeCursor, comparés comme un tuple (amount > :amount OR (amount = :amount AND id > :id)). Une ligne de plus quelimitest lue pour savoir si une page suit, donc aucun comptage n'est nécessaire, et une ligne insérée avant le curseur ne décale pas la page suivante comme elle le fait avec un offset. Un curseur revient d'un client :decodeCursorrefuse ce qu'il n'a pas écrit, et l'adaptateur vérifie les types de la position avant qu'ils n'atteignent une instruction. - Une page par offset répond
total, une page par curseurnextCursor. Proposez la forme par offset pour de petites listes que l'on parcourt, et la forme par curseur pour tout ce qui grandit.
Isolation des tenants
Section intitulée « Isolation des tenants »Deux stratégies sur drizzle, toutes deux prouvées par tenantIsolationContract de
@ddd-ts-kit/testing/contracts ; le schéma par tenant et la base par tenant ne sont livrés
que pour knex (Multitenance en donne le tableau).
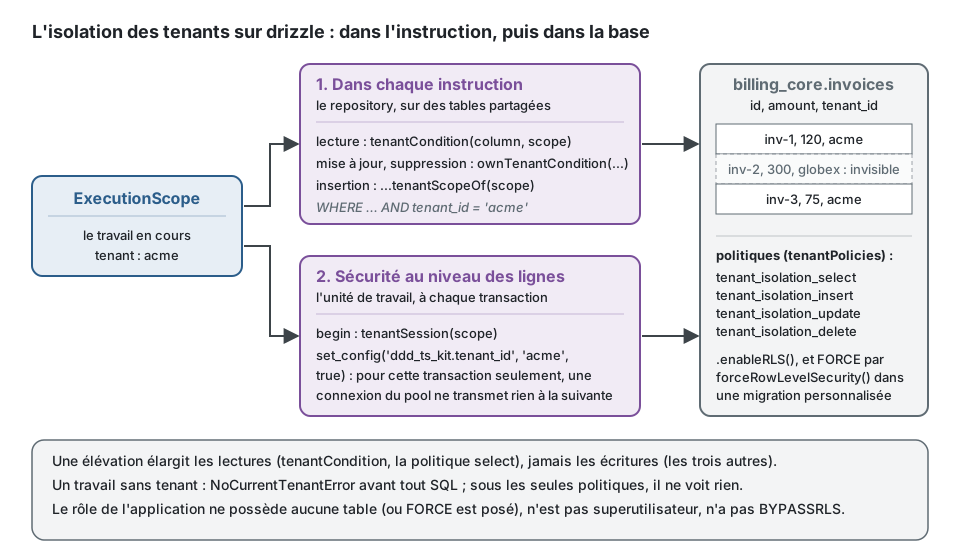
Tables partagées. Une colonne tenant_id (tenantColumn()) et la condition du kit dans
chaque instruction, au lieu d'une condition écrite à la main :
// Au lieu de : une condition écrite à la main, qu'une élévation du personnel de la plateforme ne peut pas élargir.where(and(eq(invoices.id, id), eq(invoices.tenantId, tenantScopeOf(this.scope).tenantId)))
// Écrivez, pour les lectures : le tenant du travail, ou les tenants d'une élévation.where(and(eq(invoices.id, id), tenantCondition(invoices.tenantId, this.scope)))// et pour les mises à jour et les suppressions : le seul tenant du travail, qu'une élévation n'élargit jamais.where(and(eq(invoices.id, state.id), eq(invoices.version, expected), ownTenantCondition(invoices.tenantId, this.scope)))
La condition reste un argument direct de where ou de and, un or à côté d'elle,
and(tenantCondition(...), or(a, b)) : sous un or, un not ou un gabarit sql, elle ne vaut
que pour une branche, et tenancy/scoped-statement de la CLI le signale. Les insertions étalent
tenantScopeOf(this.scope). Un modèle de lecture de données d'un tenant passe tenant: { scope, column: table.tenantId } à DrizzleReadModelTable et à
DrizzleReadModelStore.
Sécurité au niveau des lignes (row-level security), la seconde ligne : les politiques (une par commande SQL : un select voit la portée du travail, un insert, un update et un delete seulement son propre tenant) sont déclarées avec la table, si bien que drizzle-kit les génère, et l'unité de travail fixe le tenant de chaque transaction.
import { integer, text } from 'drizzle-orm/pg-core';import type { PgDatabase, PgQueryResultHKT } from 'drizzle-orm/pg-core';import type { ExecutionScope } from '@ddd-ts-kit/kernel';import {  contextSchema,  createDrizzleUnitOfWork,  forceRowLevelSecurity,  tenantColumn,  tenantPolicies,  tenantSession,} from '@ddd-ts-kit/drizzle/postgres';
export const invoices = contextSchema('billing-core')  .table(    'invoices',    {      id: text('id').primaryKey(),      amount: integer('amount').notNull(),      version: integer('version').notNull(),      ...tenantColumn(),    },    // tenant_isolation_select, _insert, _update et _delete : drizzle-kit les écrit dans la migration    (table) => [...tenantPolicies(table.tenantId)],  )  .enableRLS();
// platform/database/persistence-over.ts : chaque transaction commence par fixer le tenant du travaildeclare const db: PgDatabase<PgQueryResultHKT>;declare const executionScope: ExecutionScope;
export const unitOfWork = createDrizzleUnitOfWork(db, undefined, { begin: tenantSession(executionScope) });
// La seule instruction que drizzle-kit n'écrit pas, pour une migration personnalisée (drizzle-kit generate --custom) :// alter table "billing_core"."invoices" force row level security;export const forced = forceRowLevelSecurity(invoices);
drizzle-kit n'impose pas les politiques au propriétaire de la table :
forceRowLevelSecurity(invoices) est l'instruction d'une migration personnalisée
(drizzle-kit generate --custom), ou bien l'application se connecte avec un rôle qui ne possède
pas les tables. Dans tous les cas, ce rôle n'est pas superutilisateur et n'a pas BYPASSRLS, et
chaque instruction s'exécute dans l'unité de travail : une instruction hors d'une transaction ne
porte aucun réglage et ne voit rien.
Critères
Section intitulée « Critères »criteriaToDrizzle(plan, columns) transforme un plan de critères du noyau en morceaux de
requête : where (les filtres, le périmètre de l'acteur et le keyset d'une page par curseur),
counted (les filtres et le périmètre seuls, pour un total), orderBy (l'ordre total terminé
par le champ qui départage), limit et offset. predicateToDrizzle(predicate, columns) donne
une condition. columns associe chaque champ du modèle de lecture à sa colonne, et c'est la
seule source d'identifiants : chaque valeur est un paramètre encodé par sa colonne, une
recherche textuelle est like $1 escape $2, avec %, _ et \ échappés. containsIgnoringCase et startsWithIgnoringCase sont la même recherche en ILIKE, que PostgreSQL replie avec la locale de la base (la règle et ses limites sont dans le README du kernel, « Ce que signifient des critères ») ; aucun index b-tree ne la sert, un index GIN de pg_trgm sur la colonne le fait.
Un port de lecture déclare ce qu'un appelant peut demander avec defineCriteria ; une requête
à vous sur la table d'un modèle de lecture planifie les critères, puis remet le plan au
traducteur :
import { and, eq } from 'drizzle-orm';import { text, timestamp, type PgQueryResultHKT } from 'drizzle-orm/pg-core';import { defineCriteria, pageOfPlan, planCriteria, type Page, type ScopedCriteria } from '@ddd-ts-kit/kernel';import { contextSchema, criteriaToDrizzle, DrizzleContext, readModelColumns } from '@ddd-ts-kit/drizzle/postgres';
// application/ports/appointment-list.port.ts : la ligne, et ce par quoi un appelant peut filtrer et trierexport interface AppointmentRow {  readonly id: string;  readonly status: string;  readonly startsAt: Date;}
export const appointmentCriteria = defineCriteria<AppointmentRow>({  fields: {    id: { type: 'string' },    status: { type: 'string', filter: ['eq', 'in'], sortable: true },    startsAt: { type: 'instant', filter: ['gte', 'lt', 'between'], sortable: true },  },  defaultSort: [{ field: 'startsAt', direction: 'asc' }],  tieBreaker: 'id',});
abstract class Database extends DrizzleContext<PgQueryResultHKT> {}
// infrastructure/persistence/appointment-list.schema.tsexport const appointmentList = contextSchema('scheduling').table('appointment_list', {  id: text('id').primaryKey(),  status: text('status'), // NULL dans une ligne supprimée, comme chaque colonne de la ligne  startsAt: timestamp('starts_at', { withTimezone: true, mode: 'date' }),  ...readModelColumns(), // last_event_id, last_event_at, last_event_version, deleted});
// la seule source d'identifiants : un champ que la table de correspondance ne nomme pas n'atteint jamais une instructionconst COLUMNS = { id: appointmentList.id, status: appointmentList.status, startsAt: appointmentList.startsAt };
// infrastructure/persistence/drizzle-appointment-queries.reader.tsexport async function searchAppointments(  database: Database,  criteria: ScopedCriteria<AppointmentRow>,): Promise<Page<AppointmentRow>> {  const plan = planCriteria(appointmentCriteria, criteria); // refuse ce que la définition n'ouvre pas
  if (plan.empty) {    return pageOfPlan(plan, []); // le périmètre d'accès n'atteint aucune ligne : aucune instruction du tout  }
  const { where, counted, orderBy, limit, offset } = criteriaToDrizzle(plan, COLUMNS);  const live = eq(appointmentList.deleted, false); // une ligne supprimée reste dans la table, marquée  const db = database.executor();  const selected = await db    .select(COLUMNS)    .from(appointmentList)    .where(and(where, live))    .orderBy(...orderBy)    .limit(limit)    .offset(offset);
  // la contrainte de vérification tient ces colonnes pour une ligne vivante, ce que leurs types ne peuvent pas dire  const rows = selected.flatMap(({ id, status, startsAt }) =>    status === null || startsAt === null ? [] : [{ id, status, startsAt }],  );
  // Une page par offset compte son total ; une page par curseur sait ce qui suit grâce à la ligne en trop.  const total = plan.kind === 'offset' ? await db.$count(appointmentList, and(counted, live)) : undefined;
  return pageOfPlan(plan, rows, total);}
Une page par curseur est lue avec une ligne de plus que demandé : c'est ainsi que pageOfPlan
sait si une autre suit ; une page par offset prend son total de db.$count(table, counted),
passé en troisième argument de pageOfPlan. Un champ déclaré nullable est trié nulls last
en ordre croissant et nulls first en ordre décroissant.
Chaînes. Une colonne de texte est triée et comparée par intervalle selon la collation de la
colonne ; les critères trient les chaînes par point de code. Déclarez avec COLLATE "C" (un
customType dont le dataType est text collate "C", ou la migration) les colonnes de texte
triées ou comparées avec gt, lt ou between : l'index sert alors le tri, et l'ordre est le
même que dans le fake. Les décimaux sont une colonne numeric et une chaîne dans la ligne ;
ils reviennent à l'échelle de la colonne. Les instants sont timestamptz et une Date. Un
entier est integer : un bigint revient du pilote sous forme de chaîne.
Modèles de lecture
Section intitulée « Modèles de lecture »L'adaptateur d'un port de modèle de lecture étend DrizzleReadModelStore et n'ajoute rien : il
en reçoit get, upsertIfNewer, updateIfNewer, delete et search.
import { text, timestamp, type PgQueryResultHKT } from 'drizzle-orm/pg-core';import { ReadModelStore, type CriteriaDefinition } from '@ddd-ts-kit/kernel';import { Repository } from '@ddd-ts-kit/kernel/declarations';import { contextSchema, DrizzleContext, DrizzleReadModelStore, readModelColumns } from '@ddd-ts-kit/drizzle/postgres';
// La ligne, ses critères et la base des exemples précédents, réduits à leur forme.interface AppointmentRow {  readonly id: string;  readonly status: string;  readonly startsAt: Date;}declare const appointmentCriteria: CriteriaDefinition<AppointmentRow>;abstract class AppointmentList extends ReadModelStore<AppointmentRow> {}abstract class Database extends DrizzleContext<PgQueryResultHKT> {}
// infrastructure/persistence/appointment-list.schema.tsexport const appointmentList = contextSchema('scheduling').table('appointment_list', {  id: text('id').primaryKey(),  status: text('status'), // NULL dans une ligne supprimée, comme chaque colonne de la ligne  startsAt: timestamp('starts_at', { withTimezone: true, mode: 'date' }),  ...readModelColumns(), // last_event_id, last_event_at, last_event_version, deleted});
// infrastructure/persistence/drizzle-appointment-list.repository.ts@Repository(AppointmentList)export class DrizzleAppointmentList extends DrizzleReadModelStore<AppointmentRow, PgQueryResultHKT> implements AppointmentList {  constructor(database: Database) {    super(database, {      table: appointmentList,      key: appointmentList.id,      columns: { id: appointmentList.id, status: appointmentList.status, startsAt: appointmentList.startsAt },      definition: appointmentCriteria,    });  }}
Chaque écriture passe par TableReadModelStore du noyau : une ligne n'est écrite que si son
événement est plus récent que celui qu'elle porte, sur l'exécuteur de l'unité de travail, si
bien que la ligne et la marque d'événement traité sont validées ensemble. Une ligne supprimée
reste dans la table comme une trace, avec deleted positionné : sa clé et son tampon, et NULL
dans toutes les autres colonnes, ce pour quoi chaque colonne de la ligne accepte NULL. La
suppression d'une clé que la table ne tient pas encore laisse la même trace. Une contrainte de
vérification garde entières les lignes vivantes (check (deleted or (status is not null and starts_at is not null))), une requête à vous sur la table écarte les lignes supprimées
(deleted = false), et une table dont des colonnes refusent NULL est refusée par
ReadModelTableNotReadyError, à la construction du registre d'après sa définition et, avant
l'écriture de la première trace, par une lecture des colonnes que tient la base
(Ce que laisse une ligne supprimée). Une application n'attend pas cette première trace : tableState() d'un DrizzleReadModelStore lit sa table comme le registre le fait avant sa première trace, pour les colonnes qu'il associe et aucune autre, et ReadModelTables du noyau le demande à chaque registre que l'application liste, puis refuse avec ReadModelTablesNotReadyError, qui nomme chaque table qui n'est pas prête, ce qui l'en empêche et la migration à écrire en deux étapes, ainsi que chaque table qu'il n'a pas pu lire ; un projet généré garde la liste, vérifie à son démarrage les tables des contextes qu'il héberge, et npm run db:read-models la vérifie avant un déploiement (Chaque table vérifiée au démarrage, et avant un déploiement). store.table est ce que prend
ProjectionRebuild ; la reconstruction est réservée à PostgreSQL (une copie <table>__rebuild
faite LIKE ... INCLUDING ALL, les clés écrites entre-temps dans <table>__touched, l'échange
par renommage en une transaction) et ses garanties et limites sont dans le README de
@ddd-ts-kit/kernel (Reconstruction).
Le store passe criteriaContract et readModelStoreContract de
@ddd-ts-kit/testing/contracts, sur PGlite et sur PostgreSQL 18.
Effacement des données personnelles
Section intitulée « Effacement des données personnelles »L'effacement d'une personne concernée des tables d'un contexte, à partir des déclarations
personalFields écrites à côté de ses mappers (@ddd-ts-kit/kernel, « Données personnelles ») :
DrizzlePersonalDataErasure implémente le port PersonalDataErasure sur l'exécuteur de l'unité de travail. Le port du contexte étend celui du
kernel, et son adaptateur étend cette classe.
// infrastructure/persistence/person.personal-fields.ts : la table elle-même, les colonnes par les clés de sa définitionexport const personPersonalFields = personalFields<typeof persons.$inferSelect, PgTable>(persons, {  subject: 'id',  fields: ['displayName', 'email'],  erasure: 'row',});
// infrastructure/persistence/drizzle-identity-erasure.repository.ts@Repository(IdentityErasure)export class DrizzleIdentityErasure extends DrizzlePersonalDataErasure<NodePgQueryResultHKT> implements IdentityErasure {  constructor(database: Database, scope: ExecutionScope, files: FileStorage) {    super(database, { name: 'identity.persons', declarations: [personPersonalFields], tenant: { scope }, files });  }}
erase(subject) supprime d'abord du stockage les fichiers que les lignes nomment, puis supprime les
lignes de la personne (row) ou les pseudonymise (pseudonymise : une colonne texte lit [erased],
une colonne de tout autre type ne lit rien, une colonne de fichier rien), et répond combien de lignes
il a atteintes, aucune la seconde fois. Avec tenant, chaque instruction est confinée au tenant du
travail et jamais élargie par une élévation (la colonne nommée tenant_id, ou tenant.column) ; sans lui, la table tient les lignes de tous
les tenants. Un sujet qui n'est pas un identifiant opaque est refusé avant toute instruction, et une
déclaration qui nomme des colonnes de fichier sans stockage de fichiers est refusée à la construction
de l'adaptateur. Les types des colonnes viennent de la définition de la table, pour qu'un texte et un nombre soient pseudonymisés chacun à sa façon. Une colonne personnelle qui n'est pas un texte doit accepter null, sinon
les lignes s'effacent avec row : une déclaration qui en pseudonymiserait une qui ne l'accepte pas
est refusée avant qu'un fichier ou une ligne ne soit touché (NotNullablePersonalColumnError). L'adaptateur passe personalDataErasureContract de
@ddd-ts-kit/testing, comme celui en mémoire, sur PGlite et PostgreSQL. Ce qu'un effacement
n'atteint pas, et la chaîne entière (eraseDataSubject : la clé, chaque copie dans chaque tenant,
les reconstructions), sont dans le README du kernel (« Données personnelles »).
DrizzlePersonalDataExport répond au droit d'accès et à la portabilité à partir des mêmes déclarations :
exportOf(subject) remet un PersonalDataRecord par ligne sur la personne dans chaque table déclarée,
sous <name>.<table>, avec chaque colonne personnelle et chaque colonne de fichier (par sa clé) en
données simples, par les clés de la définition de la table, aucune autre colonne et rien de personne d'autre ; une ligne déjà
pseudonymisée répond ce qu'elle lit. La même option tenant confine chaque instruction au tenant du
travail, un sujet qui n'est pas un identifiant opaque est refusé avant toute instruction, et
l'adaptateur passe personalDataExportContract. Le port du contexte étend PersonalDataExport du
kernel et son adaptateur étend cette classe avec name, declarations et tenant
(DrizzlePersonalDataExportOptions) ; generate repository --personal écrit les deux adaptateurs, et
exportDataSubject du kernel rassemble chaque export en un document daté. Enveloppez l'adaptateur
avec auditedPersonalDataExport de @ddd-ts-kit/audit là où il est lié, pour que chaque remise
laisse une entrée.
Les mêmes déclarations donnent la limitation de la conservation (RGPD, article 5(1)(e)) : une
déclaration avec retention: { after: 'endedAt', months: 36 } dit combien de temps ses lignes gardent
la personne, compté depuis une colonne de date de la ligne, et purgeExpired(now) de l'adaptateur
d'effacement efface, comme la déclaration le dit, les lignes dont la date est plus ancienne que la
période ; une ligne dont la date est vide n'expire jamais, et un second passage n'atteint rien. Il
se confine au tenant du travail quand le travail en nomme un, et atteint chaque tenant quand il
n'en nomme aucun, comme le fait le job de nuit de la plateforme : un tenant oublié dans une liste
garderait ce qu'il ne doit pas. L'adaptateur implémente PersonalDataRetention du kernel et passe
personalDataRetentionContract ; purgeExpiredPersonalData du kernel lance chaque copie, et
auditedPersonalDataRetention de @ddd-ts-kit/audit enregistre chaque purge.
Outbox et idempotence
Section intitulée « Outbox et idempotence »DrizzleOutboxStore.claimBatchsélectionne les lignes duesFOR UPDATE SKIP LOCKEDet les prend à bail dans la même courte transaction en repoussantnext_attempt_at(leaseMs, 30 s par défaut) : plusieurs relais se partagent ainsi le travail sans s'attendre, et les enregistrements d'un relais mort reviennent quand le bail expire. La livraison est au moins une fois et, par défaut, sans ordre :ordering: 'per-key'deOutboxRelay, muni d'unkeyOf(en général l'identifiant de l'agrégat), garde dans l'ordre les enregistrements d'une même clé, avec un seul relais (L'ordre par clé).DrizzleProcessedEventStore.markProcessedest unINSERT ... ON CONFLICT DO NOTHING. Exécutez le consommateur dans l'unité de travail : la marque est alors validée avec les effets du gestionnaire, et disparaît avec eux s'il échoue.consumede@ddd-ts-kit/eventsfait exactement cela (Consommer de façon idempotente).- Un projet multitenant déclare
tenantOutboxTable('messaging')au lieu d'outboxTable: la même table plus untenant_idfacultatif, que le store, quand on lui donne cette table, remplit avec le tenant de chaque événement, pour que ses consommateurs s'exécutent dans ce tenant. Faire basculer un projet existant tient en une migration générée qui ajoute la colonne.
Event store
Section intitulée « Event store »import type { PgQueryResultHKT } from 'drizzle-orm/pg-core';import { createDrizzleEventSourcing, DrizzleContext, eventStoreTables } from '@ddd-ts-kit/drizzle/postgres';
// src/contexts/scheduling/shared/infrastructure/persistence/scheduling.schema.ts, lu par drizzle-kitexport const { events, head, snapshots, checkpoints, subjectKeys } = eventStoreTables('scheduling');
// la racine de composition : la base du projet, puis un store par portdeclare const database: DrizzleContext<PgQueryResultHKT>;
export const stores = createDrizzleEventSourcing(database, { schema: 'scheduling' });// stores.events, stores.snapshots, stores.checkpoints, stores.subjectKeyseventStoreTables déclare les tables que drizzle-kit crée dans une migration du projet, avec les
colonnes d'eventStoreTablesSql du noyau.
Chaque instruction s'exécute sur l'exécuteur du contexte : un ajout rejoint la transaction de
l'unité de travail, si bien que le flux et les enregistrements d'outbox que publient ses
événements sont validés ensemble (eventStoreUnitOfWorkContract). Les ajouts prennent la tête
du store, une ligne verrouillée jusqu'à la fin de leur transaction : les positions sont données
dans l'ordre des validations, sans trou, et deux ajouts ne s'exécutent jamais côte à côte, quels
que soient leurs flux. PostgreSQL seulement. Les stores sont ceux du noyau (PostgresEventStore
et ses compagnons), tenus ici à eventStoreContract ; comment un agrégat en event sourcing
les utilise : le README de @ddd-ts-kit/kernel, section
Event sourcing.
Jobs en arrière-plan
Section intitulée « Jobs en arrière-plan »DrizzleJobStore est le JobStore de @ddd-ts-kit/scheduling : les jobs en arrière-plan d'un
contexte dans jobsTable('scheduling'), que les fichiers de schéma de drizzle-kit incluent pour
qu'une migration la crée. add s'exécute sur l'exécuteur du contexte, dans la transaction de la
commande qui met en file ; les prises sélectionnent les lignes dues FOR UPDATE SKIP LOCKED et
les prennent à bail.
import type { PgDatabase, PgQueryResultHKT } from 'drizzle-orm/pg-core';import { kernelModule } from '@ddd-ts-kit/di';import { createDrizzleUnitOfWork, DrizzleJobStore, DrizzleProcessStore, jobsTable, processesTable } from '@ddd-ts-kit/drizzle/postgres';
// scheduling.schema.ts, lu par drizzle-kit : scheduling.background_jobs et scheduling.process_instancesexport const schedulingJobs = jobsTable('scheduling');export const schedulingProcesses = processesTable('scheduling');
// la racine de compositiondeclare const db: PgDatabase<PgQueryResultHKT>;const unitOfWork = createDrizzleUnitOfWork(db);
export const kernel = kernelModule({  unitOfWork,  jobStore: new DrizzleJobStore(unitOfWork, schedulingJobs),  processStore: new DrizzleProcessStore(unitOfWork, { table: schedulingProcesses }),});
Il passe jobStoreContract, sa suite d'unité de travail comprise, sur PGlite et, dans le job
d'intégration de la CI, sur PostgreSQL derrière un pool de cinq connexions, où les prises
concurrentes s'affrontent pour de bon. Ce que garantissent les jobs :
Jobs en arrière-plan.
Gestionnaires de processus
Section intitulée « Gestionnaires de processus »DrizzleProcessStore est le ProcessStore du noyau, sur processesTable(schema) : un premier
enregistrement insère, un suivant met à jour à la version précédente, et un enregistrement qui
ne change aucune ligne lève ConcurrencyError, dans la transaction de l'étape. Il passe
processStoreContract. L'exemple de Jobs en arrière-plan le lie avec
kernelModule({ processStore }).
Avec tenant (l'ExecutionScope), le store garde chaque instance dans le tenant du travail qui
l'enregistre : la table repère aussi une ligne par son tenant, le texte vide hors de tout tenant,
si bien que deux tenants peuvent utiliser la même clé de corrélation ; une instance d'un autre
tenant n'est ni trouvée ni modifiée, et un travail qui ne nomme aucun tenant est refusé par
NoCurrentTenantError.
Tester un adaptateur
Section intitulée « Tester un adaptateur »L'unité de travail de ce package passe unitOfWorkContract, et ses stores
outboxStoreContract, processedEventStoreContract et jobStoreContract, de
@ddd-ts-kit/testing/contracts sur PGlite (PostgreSQL dans le processus, sans conteneur).
Tenez vos repositories à repositoryContract de la même façon, à côté de leur fake en
mémoire.
Le traducteur de critères et le store de modèle de lecture tournent aussi sur un vrai serveur
quand DDD_TS_KIT_TEST_DATABASE_URL est définie, par drizzle-orm/node-postgres, chaque fichier
de spec dans sa propre base de données, qu'il supprime ensuite (dernière exécution :
PostgreSQL 18) :
DDD_TS_KIT_TEST_DATABASE_URL=postgresql://user:password@localhost:5432/postgres npx vitest run packages/drizzleVoir aussi
Section intitulée « Voir aussi »- Persistance : choisir un ORM, et ce que chaque package d'adaptateurs a vérifié
- Agrégats : la concurrence optimiste, vue depuis le domaine
- L'outbox transactionnelle : pourquoi l'enregistrement d'outbox est validé avec l'écriture métier
- Multitenance : les quatre stratégies d'isolation
@ddd-ts-kit/typeorm: les mêmes pièces sur TypeORM