
Persistance : Drizzle, Knex, Prisma, TypeORM, et quelle base de données
Résumé. Dans cette architecture, un ORM est un détail d'implémentation de
infrastructure/persistence/ : les lignes n'en sortent jamais, un mapper les transforme en
agrégats, et les transactions appartiennent à l'application par le port UnitOfWork. Le kit
livre les trois mêmes pièces pour quatre bibliothèques (une unité de travail avec une transaction
ambiante, un registre d'outbox, un registre des événements traités), toutes tenues aux mêmes
suites de contrat. Ce qui diffère, c'est la façon dont chaque bibliothèque gère les transactions,
les migrations, la sûreté des types et le SQL brut, et jusqu'où chaque adaptateur a réellement
été testé : PostgreSQL est couvert par les suites automatisées pour les quatre, SQLite par celles
des registres de Knex, MySQL 8 et SQLite ont été par ailleurs essayés à la main une fois pour
trois d'entre elles, et rien d'autre n'a été essayé du tout.
Ce que l'application demande à la persistance
Section intitulée « Ce que l'application demande à la persistance »Les exigences viennent du modèle, pas de la bibliothèque (agrégats, outbox transactionnelle) :
| Besoin | Pourquoi | Conséquence pour l'outil |
|---|---|---|
| charger et sauvegarder un agrégat entier | Appointment est une frontière de cohérence |
un mapper, pas une « entité » qui serait à la fois ligne et modèle |
| une transaction par commande, ouverte par un middleware du bus | le gestionnaire (handler) ne la voit jamais | une transaction ambiante que le repository récupère |
la concurrence optimiste sur version |
deux reports d'un même rendez-vous | « mettre à jour là où la version correspond », compter les lignes |
| la ligne d'outbox dans la même transaction | scheduling.appointment.booked existe si et seulement si la réservation existe |
le registre d'outbox rejoint l'unité de travail |
| la marque d'événement traité avec la modification du consommateur | notification ne traite qu'une fois un événement livré de nouveau |
idem |
| une contrainte que la base de données impose | pas de double réservation, quoi que croie n'importe quel processus | du SQL brut dans une migration (plus bas) |
| un schéma par contexte, aucune jointure entre contextes | context/extractable dans ARCHITECTURE.md |
des tables qualifiées par leur schéma |
L'invariant « pas de double réservation » montre ce que « SQL brut » veut dire en pratique. Sur
PostgreSQL, c'est une contrainte d'exclusion sur le calendrier et le créneau qu'occupe un
rendez-vous actif. Aucune des quatre bibliothèques ne l'exprime dans son langage de schéma, pour
autant que cette page ait pu l'établir : elle s'écrit à la main dans une migration, et
l'adaptateur du repository fait correspondre sa violation au refus SLOT_TAKEN du domaine
(SlotTaken.forCalendar). L'application d'exemple la déclare dans
create-scheduling-tables.schema.ts, après create extension if not exists btree_gist :
alter table scheduling.appointments add constraint appointments_slot_held_once exclude using gist (calendar_id with =, tstzrange(starts_at, held_until, '[)') with &&) where (status in ('requested', 'booked'));Deux transactions qui lisent toutes deux un créneau libre ne peuvent pas toutes deux l'écrire :
la seconde échoue sur la contrainte (SQLSTATE 23P01), quoi que chacune ait cru au moment de sa
vérification.
Les pièces, en une commande
Section intitulée « Les pièces, en une commande »Quatre pièces font le travail, et seule la dernière connaît la bibliothèque : le port repository du domaine, l'unité de travail que le bus ouvre autour de chaque commande, l'adaptateur du repository avec son mapper, et les registres de la messagerie (outbox, événements traités). La séquence ci-dessous suit une commande, « payer une facture », à travers elles. Chaque instruction s'exécute dans la transaction qu'a ouverte l'unité de travail, et le gestionnaire n'y touche jamais.
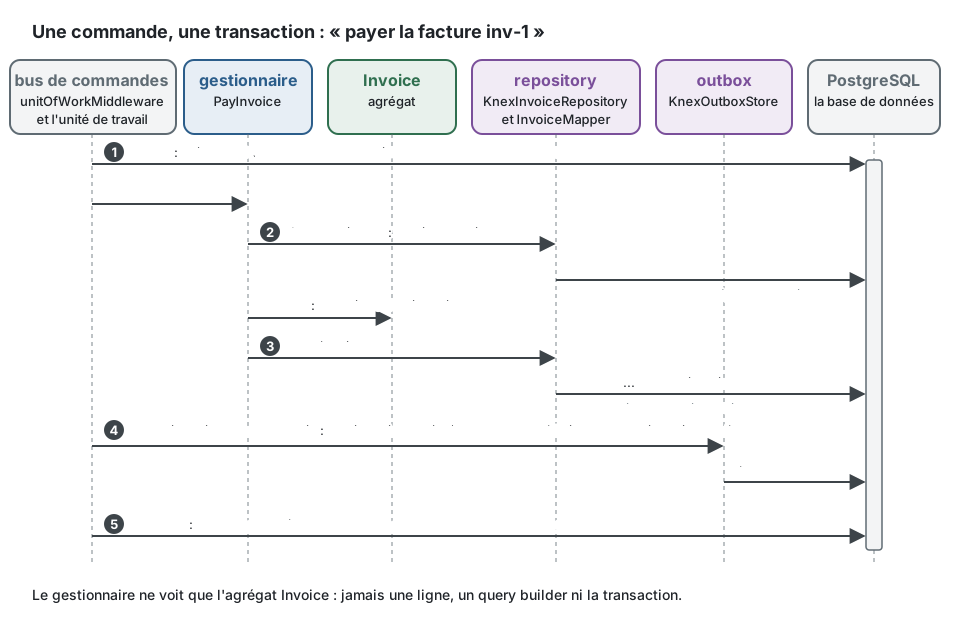
unitOfWorkMiddlewaredu noyau enveloppe chaque commande du bus dansunitOfWork.run. L'unité de travail Knex ouvreknex.transactionet la garde dans unAsyncLocalStorage.- L'adaptateur demande à
KnexContext.executor()son point d'accès aux requêtes : à l'intérieur d'unrun, c'est la transaction, en dehors, le pool. Aucune méthode ne prend une transaction en paramètre. - Le mapper transforme la ligne en
Invoiceet inversement. L'agrégat porte laversionà laquelle il a été lu ; l'UPDATEne correspond qu'à cette version. - Quand le gestionnaire a rendu la main, les événements du domaine qu'ont enregistrés les
sauvegardes sont distribués, toujours dans la transaction. Le gestionnaire de
InvoicePaidpublie un événement d'intégration ; l'OutboxPublisherde@ddd-ts-kit/eventsse contente de l'ajouter au registre d'outbox, qui écrit par le même exécuteur. Un relais l'envoie plus tard au broker. - La validation (commit) écrit ensemble la facture et la ligne d'outbox ; tout échec annule les deux (rollback).
Un adaptateur de repository
Section intitulée « Un adaptateur de repository »Le port est déclaré dans le domaine, l'adaptateur et son mapper dans
infrastructure/persistence/. L'exemple les réunit dans un seul module pour qu'il compile seul ;
dans un projet, chaque partie est un fichier à part, nommé dans les commentaires. Il suit le
KnexAppointmentRepository de l'application d'exemple.
import type { Knex } from 'knex';import { AggregateRoot, DomainRefusal, NamedDomainEvent, Repository } from '@ddd-ts-kit/kernel';import { type KnexContext, insertIgnoringConflict, optimisticUpdate } from '@ddd-ts-kit/knex';
// domain/events/invoice-paid.event.ts : le domaine ne connaît ni ligne, ni SQL, ni bibliothèque.export class InvoicePaid extends NamedDomainEvent('billing.invoice.paid') {  constructor(    readonly aggregateId: string,    readonly occurredAt: Date,  ) {    super();  }}
// billing.codes.tsexport const BillingCodes = { InvoiceAlreadyPaid: 'INVOICE_ALREADY_PAID' } as const;
// domain/errors/invoice-already-paid.error.tsexport class InvoiceAlreadyPaid extends DomainRefusal {  readonly code = BillingCodes.InvoiceAlreadyPaid;
  static forInvoice(invoiceId: string) {    return InvoiceAlreadyPaid.refusal(`Invoice ${invoiceId} is already paid.`, { invoiceId });  }}
// domain/aggregates/invoice.aggregate.tsexport class Invoice extends AggregateRoot {  private constructor(    id: string,    readonly amountInCents: number,    private paidOn: Date | null,  ) {    super(id);  }
  static issue(id: string, amountInCents: number): Invoice {    return new Invoice(id, amountInCents, null);  }
  /** Reconstruit une facture stockée : utilisé par le mapper seulement. */  static rehydrate(id: string, amountInCents: number, paidOn: Date | null): Invoice {    return new Invoice(id, amountInCents, paidOn);  }
  get paidAt(): Date | null {    return this.paidOn;  }
  pay(on: Date): void {    if (this.paidOn !== null) {      throw InvoiceAlreadyPaid.forInvoice(this.id);    }
    this.paidOn = on;    this.record(new InvoicePaid(this.id, on));  }}
// domain/repositories/invoice.repository.ts : le port, findById et save viennent de Repository.export abstract class InvoiceRepository extends Repository<Invoice> {}
// infrastructure/persistence/invoice-row.schema.ts : la ligne ne sort jamais de l'infrastructure.type InvoiceRow = {  readonly id: string;  readonly amount_in_cents: number;  readonly paid_at: Date | null;  readonly version: number;};
// infrastructure/persistence/invoice.mapper.tsconst InvoiceMapper = {  toDomain(row: InvoiceRow): Invoice {    const loaded = Invoice.rehydrate(row.id, row.amount_in_cents, row.paid_at);
    loaded.version = row.version;
    return loaded;  },
  toRow(saved: Invoice, version: number): InvoiceRow {    return { id: saved.id, amount_in_cents: saved.amountInCents, paid_at: saved.paidAt, version };  },};
// infrastructure/persistence/knex-invoice.repository.tsexport class KnexInvoiceRepository implements InvoiceRepository {  constructor(private readonly database: KnexContext) {}
  async findById(id: string): Promise<Invoice | undefined> {    const row = await invoicesOf(this.database).where({ id }).first();
    return row === undefined ? undefined : InvoiceMapper.toDomain(row);  }
  /** Aucune ligne écrite signifie qu'une autre transaction l'a sauvegardée d'abord : optimisticUpdate lève ConcurrencyError. */  async save(saved: Invoice): Promise<void> {    await optimisticUpdate(saved, async ({ expected, next }) => {      const row = InvoiceMapper.toRow(saved, next);
      if (expected === 0) {        const inserted = await insertIgnoringConflict(this.database.executor(), invoicesOf(this.database), {          row,          conflict: 'id',        });
        return inserted ? 1 : 0;      }
      return invoicesOf(this.database).where({ id: saved.id, version: expected }).update(row);    });  }}
/** La transaction de l'unité de travail en cours, ou le pool en dehors d'une unité de travail. */function invoicesOf(database: KnexContext): Knex.QueryBuilder<InvoiceRow, InvoiceRow[]> {  return database.executor()<InvoiceRow, InvoiceRow[]>('invoices').withSchema('billing');}
Ce que contient chaque partie :
| Partie | Contient | Ne contient jamais |
|---|---|---|
Invoice |
les règles, l'état, les événements qu'il enregistre, et version (venue d'AggregateRoot) |
un nom de colonne, une requête SQL |
InvoiceRepository |
ce que l'application peut demander : findById, save, les recherches que vous ajoutez |
un type de la bibliothèque |
InvoiceMapper |
la traduction entre la ligne et l'agrégat, dans les deux sens | une requête SQL, une règle |
KnexInvoiceRepository |
les requêtes SQL, le schéma, la vérification de concurrence, la correspondance entre une erreur de la base de données et un refus | la transaction elle-même (executor() la donne) |
Au lieu de donner des lignes au gestionnaire
Section intitulée « Au lieu de donner des lignes au gestionnaire »Le gestionnaire parle à l'agrégat par le port ; il ne voit jamais une ligne, un query builder ni une transaction.
// Au lieu de : le gestionnaire modifie une ligne, et la règle « une facture se paie une fois » ne vit nulle part.const row = await db('billing.invoices').where({ id }).first();await db('billing.invoices').where({ id }).update({ paid_at: new Date() });
// Écrivez : le gestionnaire charge l'agrégat, lui demande de payer (il refuse un second paiement), le sauvegarde.const invoice = await invoices.findById(id);if (invoice === undefined) throw new NotFoundError(`Invoice ${id} does not exist.`); // NotFoundError : @ddd-ts-kit/kernelinvoice.pay(clock.now());await invoices.save(invoice);
Composer l'unité de travail
Section intitulée « Composer l'unité de travail »Un seul objet répond aux deux ports : le bus fait passer les commandes par UnitOfWork, les
adaptateurs et les registres interrogent la base par KnexContext. L'application d'exemple le
compose de cette façon dans platform/database/persistence-over.ts.
import knex from 'knex';import { unitOfWorkMiddleware } from '@ddd-ts-kit/kernel';import { createKnexUnitOfWork, KnexOutboxStore, KnexProcessedEventStore } from '@ddd-ts-kit/knex';
const db = knex({ client: 'pg', connection: 'postgres://localhost:5432/app' });
// Lié à UnitOfWork (pour le bus) et à KnexContext (pour les adaptateurs).export const unitOfWork = createKnexUnitOfWork(db);
// Les registres écrivent par lui aussi : leurs lignes sont validées ou annulées avec la commande.export const outbox = new KnexOutboxStore(unitOfWork, { schema: 'messaging' });export const processedEvents = new KnexProcessedEventStore(unitOfWork, { schema: 'messaging' });
// Le bus exécute chaque commande dans unitOfWork.run ; une requête s'exécute hors de toute transaction.export const transactional = unitOfWorkMiddleware(unitOfWork);
await unitOfWork.run(async () => {  // Ici, unitOfWork.executor() est la transaction et unitOfWork.inTransaction() vaut true.  await unitOfWork.run(async () => {    // Un run imbriqué rejoint celui qui l'entoure : une seule validation, ou une seule annulation, pour les deux.  });});
Les mêmes pièces, sous le nom que leur donne chaque package :
| Knex | Drizzle (@ddd-ts-kit/drizzle/postgres) |
Prisma | TypeORM | |
|---|---|---|---|---|
| Unité de travail | createKnexUnitOfWork |
createDrizzleUnitOfWork |
createPrismaUnitOfWork |
createTypeOrmUnitOfWork |
| Ce par quoi les adaptateurs interrogent la base | KnexContext |
DrizzleContext |
PrismaContext |
TypeOrmContext |
| Registre d'outbox | KnexOutboxStore |
DrizzleOutboxStore |
PrismaOutboxStore |
TypeOrmOutboxStore |
| Registre des événements traités | KnexProcessedEventStore |
DrizzleProcessedEventStore |
PrismaProcessedEventStore |
TypeOrmProcessedEventStore |
La concurrence optimiste, et un seul contrat pour le fake et l'adaptateur
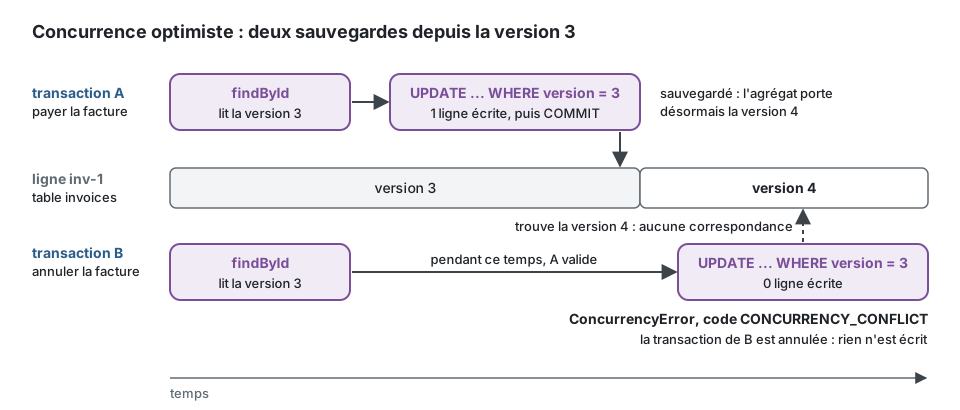
Section intitulée « La concurrence optimiste, et un seul contrat pour le fake et l'adaptateur »Deux commandes peuvent charger la même facture à la même version. La première sauvegarde
correspond à la version et la fait avancer ; la seconde ne correspond à aucune ligne, et
optimisticUpdate lève ConcurrencyError (code CONCURRENCY_CONFLICT), ce qui annule sa
transaction. Les quatre unités de travail répondent de même quand la base de données abandonne
leur transaction pour une transaction concurrente, sur un interblocage (40P01) ou un échec de
sérialisation (40001, P2034 de Prisma), quelle que soit l'instruction choisie :
TransactionConflictError, une ConcurrencyError dont la cause est l'erreur du pilote, jamais
une erreur inattendue.
Un enregistrement qui prend une valeur qu'une autre ligne détient sous une contrainte d'unicité
(un e-mail, un numéro) n'est pas une mise à jour perdue : le relancer est refusé de nouveau. Les
quatre ORM y répondent de même, sur une insertion comme sur une mise à jour :
UniqueViolationError, une ConflictError (code CONFLICT, 409) dont la cause est l'erreur
du pilote (23505, ER_DUP_ENTRY, SQLITE_CONSTRAINT_UNIQUE, SQLITE_CONSTRAINT_PRIMARYKEY, un SQLITE_CONSTRAINT brut dont le message nomme une clé unique, P2002), levée par
optimisticUpdate. Le premier enregistrement n'ignore qu'un conflit sur l'id :
insertIgnoringConflict de Drizzle, Knex et TypeORM ; sur Prisma, dont skipDuplicates ne nomme
aucune cible, rowsCreated cherche l'id quand rien n'a été écrit. Deux premiers enregistrements
d'un même agrégat faits en même temps (une requête livrée deux fois) sont une mise à jour perdue,
sur une table qui a une colonne unique aussi : l'un écrit la ligne et l'autre reçoit
ConcurrencyError, jamais une UniqueViolationError pour la valeur qu'ils écrivent tous les
deux. Sur PostgreSQL, une insertion dont la cible de conflit est l'id seul la lèverait, puisque
les deux insertions se rencontrent d'abord sur l'autre index unique : insertIgnoringConflict
insère donc par ON CONFLICT DO NOTHING, et seulement quand rien n'a été écrit par
ON CONFLICT (id) DO NOTHING, ce qui distingue un id pris d'une valeur prise. Un handler qui a une réponse métier pour
la valeur prise (EMAIL_TAKEN) attrape UniqueViolationError et lève son propre refus. Sur
MySQL, qui n'a pas de cible de conflit et dont INSERT IGNORE écarte aussi cette ligne,
insertIgnoringConflict de Knex et de TypeORM demande si une ligne détient l'id quand rien n'a
été écrit, et lève UniqueViolationError quand aucune ne le détient, comme rowsCreated sur
Prisma.
Une unité de travail que la base ne peut pas servir à temps reçoit un 503, pas un 500 : Prisma
borne l'attente d'une transaction (maxWait) et sa durée (timeout), Knex l'attente d'une
connexion (acquireConnectionTimeout, 60 secondes), et au-delà l'unité de travail est rejetée
par TransactionTimeoutError (code SERVICE_UNAVAILABLE), rien n'étant validé. Un projet
généré sur Prisma lit les deux limites dans DATABASE_TRANSACTION_WAIT_MS et
DATABASE_TRANSACTION_TIMEOUT_MS, 10 et 30 secondes par défaut (un appelant abandonne vers 30
secondes, et une connexion tenue plus longtemps ne déleste rien) ; Drizzle et TypeORM attendent
une connexion de leur pool et ne bornent aucune transaction, ils n'ont donc pas ce réglage.
Le fake (double de test) des specs unitaires et l'adaptateur réel tiennent cette promesse de
la même façon : le même repositoryContract s'exécute contre les deux, le fake en mémoire et
l'adaptateur sur PGlite ou sur un vrai serveur.
import { randomUUID } from 'node:crypto';import { afterEach, beforeEach, describe, expect, it } from 'vitest';import { AggregateRoot, type Repository } from '@ddd-ts-kit/kernel';import { InMemoryRepository } from '@ddd-ts-kit/testing';import { repositoryContract } from '@ddd-ts-kit/testing/contracts';
// Tirés de l'exemple ci-dessus, et de la base de données de test du projet.declare class Invoice extends AggregateRoot {  static issue(id: string, amountInCents: number): Invoice;  static rehydrate(id: string, amountInCents: number, paidOn: Date | null): Invoice;  readonly amountInCents: number;  readonly paidAt: Date | null;  pay(on: Date): void;}declare function knexInvoiceRepositoryOnAnEmptyDatabase(): Promise<Repository<Invoice>>;
const runner = { describe, it, expect, beforeEach, afterEach };
const expectations = {  createAggregate: () => Invoice.issue(randomUUID(), 12_000),  mutate: (invoice: Invoice) => invoice.pay(new Date('2026-10-01T09:00:00.000Z')),  idOf: (invoice: Invoice) => invoice.id,  stateOf: (invoice: Invoice) => ({ amountInCents: invoice.amountInCents, paidAt: invoice.paidAt }),};
// Le fake qu'utilisent les specs unitaires : une Map qui vérifie la version comme l'adaptateur.repositoryContract<Invoice>(runner, {  ...expectations,  name: 'InMemoryRepository<Invoice>',  createRepository: () =>    new InMemoryRepository<Invoice>({      clone: (invoice) => Invoice.rehydrate(invoice.id, invoice.amountInCents, invoice.paidAt),    }),});
// L'adaptateur, sur une base de données vidée avant chaque test.repositoryContract<Invoice>(runner, {  ...expectations,  name: 'KnexInvoiceRepository',  createRepository: knexInvoiceRepositoryOnAnEmptyDatabase,});
Le contrat vérifie qu'un agrégat sauvegardé est retrouvé avec son état, que deux agrégats restent
séparés, que les sauvegardes suivantes sont enregistrées, qu'une modification non sauvegardée ne
l'est pas, et qu'une sauvegarde par-dessus une version qu'elle n'a pas lue est refusée avec
CONCURRENCY_CONFLICT.
Le cas de la sauvegarde périmée demande un mutate qui enregistre un changement d'état : le
contrat change les deux copies, pour qu'un adaptateur de table comme un event store refusent la
périmée. Quand mutate n'enregistre rien, le cas échoue avec mutate changed nothing: give the contract a change of state au lieu d'attendre un conflit qui ne vient jamais. mutate est
facultatif : sans lui, le cas reste en attente (it.todo, avec la raison give the contract a mutate that records a change of state), ce qui est l'état de départ d'un spec de contrat tout juste
généré. Une sauvegarde sans changement n'est pas jugée : un adaptateur de table avance la version,
un event store n'ajoute rien.
Une décision qu'aucune version ne protège : un verrou sur une clé métier
Section intitulée « Une décision qu'aucune version ne protège : un verrou sur une clé métier »La concurrence optimiste compare la version d'une ligne qui existe. Compter les réservations
d'un créneau avant d'en insérer une, ou donner le numéro suivant d'une séquence par tenant,
décide sur des lignes qui ne sont pas encore là : deux unités de travail lisent le même compte
et écrivent toutes les deux. Les quatre packages d'ORM donnent pour cela les deux mêmes
helpers. advisoryLock(context, key, { tenant: scope }) attend qu'aucune autre transaction ne
tienne le verrou sur key, puis le tient jusqu'à ce que l'unité de travail valide ou annule
(pg_advisory_xact_lock) ; tryAdvisoryLock répond false au lieu d'attendre. La clé est un
texte que PostgreSQL hache sur 64 bits (hashtextextended), préfixé par le tenant du travail
quand tenant est donné, si bien que deux tenants ne s'attendent jamais ; deux clés de même
hachage s'attendent, et rien d'autre ne se passe. Hors d'une unité de travail, le verrou serait
relâché aussitôt, et le helper refuse (AdvisoryLockOutsideUnitOfWorkError).
Ce sont des fonctions de l'adaptateur, pas un port du kernel : un cas d'usage n'importe aucun
package d'ORM, donc le verrou se place dans la méthode du repository qui en a besoin, ou
derrière un port du contexte dont le fake ne fait rien. Le prendre en premier dans l'unité de
travail et garder l'isolation par défaut (read committed), sous laquelle la lecture qui suit
voit ce que le détenteur précédent a validé. tenancy/scoped-statement accepte le helper et
signale un pg_advisory_xact_lock écrit à la main. PostgreSQL seulement ;
advisoryLockContract y tient les quatre packages, l'attente elle-même sur un vrai serveur,
puisque PGlite est une seule session.
Comparaison
Section intitulée « Comparaison »Versions vérifiées le 2026-10-10 sur le registre npm.
| Drizzle | Knex | Prisma | TypeORM | |
|---|---|---|---|---|
| Ce que c'est | constructeur de SQL typé, schéma en TypeScript | constructeur de requêtes SQL | client généré à partir d'un fichier de schéma | ORM, data mapper ou active record |
| Version | 0.45.4 stable ; une release candidate 1.0 est publiée (étiquette rc) |
3.3.0 (juin 2026) | 7.10.0 est la dernière 7.x ; l'étiquette npm latest désignait 8.0.0-rc.22 le jour de la vérification |
1.1.2 (0.3.x conservée sous legacy) |
| Licence | Apache-2.0 | MIT | Apache-2.0 | MIT |
| Téléchargements hebdomadaires | environ 27 millions | environ 6 millions | environ 19 millions | environ 5 millions |
| Sûreté des types des requêtes | déduite des définitions de tables | faible : les types sont des annotations que vous écrivez | par le client généré | par les définitions d'entités ; les chaînes du query builder ne sont pas vérifiées |
| Transactions | callback ; savepoints | callback ou manuelle ; savepoints | transactions interactives, bornées dans le temps (5 s par défaut) et qui tiennent une connexion | QueryRunner ou callback |
| Verrouillage de lignes | dans le constructeur de requêtes | dans le constructeur de requêtes (forUpdate().skipLocked()) |
aucun dans le client : SQL brut | dans le query builder |
| Migrations | générées par drizzle-kit à partir de la différence de schéma, fichiers SQL | JavaScript écrit à la main, up et down | générées à partir de la différence de schéma, fichiers SQL | générées à partir des entités, ou écrites à la main |
| SQL brut | gabarit sql, objets de table interpolés |
de premier plan : c'est un constructeur de requêtes | $queryRaw, fichiers SQL typés |
query() |
| Poids à l'exécution | la bibliothèque seule | la bibliothèque seule | client généré plus un adaptateur de pilote | la bibliothèque, reflect-metadata avec des entités décorées |
| Décorateurs | aucun | aucun | aucun | facultatifs : le kit utilise EntitySchema, sans décorateur |
Lire le tableau pour cette architecture : les fonctions d'ORM qui comptent le moins sont celles que les ORM mettent le plus en avant. Relations paresseuses, identity maps, cascades et active records ne servent à rien quand un agrégat se charge en entier et se transpose à la main ; ce qui compte, c'est un SQL honnête, une transaction qui peut être rendue ambiante, des verrous de ligne pour le relais de l'outbox et des migrations que l'on peut lire.
Critères de choix
Section intitulée « Critères de choix »- Connaissances de l'équipe et schéma existant. Une application en service sur l'une des quatre la garde : le domaine n'en a que faire.
- La part de SQL brut que vous prévoyez. Contraintes, index partiels, modèles de lecture avec fonctions de fenêtrage : Knex et Drizzle restent les plus proches du SQL.
- Sûreté des types des modèles de lecture. Les gestionnaires de requêtes peuvent contourner les agrégats et lire des projections par un port ; c'est là que les requêtes typées rapportent.
- Durée des transactions. Les transactions interactives de Prisma sont bornées dans le temps par défaut.
- Ce que le kit génère pour elle. Le cloisonnement par tenant est généré sur les quatre ; le journal d'audit SQL n'est pas disponible pour les quatre (plus bas).
- Fraîcheur de la version. Préférez la ligne stable courante ; le jour de la vérification,
l'étiquette npm
latestde Prisma portait une release candidate : épinglez la version que vous avez testée.
Ce que ce kit prend en charge et a vérifié
Section intitulée « Ce que ce kit prend en charge et a vérifié »Commun aux quatre packages (drizzle,
knex, prisma,
typeorm) : une unité de travail dont les repositories ne
voient jamais la transaction, où un run imbriqué rejoint la transaction qui l'entoure et où les
événements du domaine sont distribués à la fin du run le plus extérieur, avant sa validation ;
un registre d'outbox dont claimBatch prend à bail les lignes échues, si bien que plusieurs
relais se partagent le travail et que les lignes d'un relais mort reviennent ; un registre des
événements traités dont la marque est validée avec les effets du gestionnaire ; les colonnes
d'audit standard et tenant_id ; les pages par curseur et par décalage. Les unités de travail
passent unitOfWorkContract, les registres outboxStoreContract et
processedEventStoreContract ; vos repositories sont tenus à repositoryContract à côté de
leur fake en mémoire. La livraison par l'outbox se fait au moins une fois et sans ordre.
L'isolation des tenants est inégale entre les quatre : les tables partagées sur chacun d'eux
(tenantTable, tenantCondition, tenantWhere, les modèles de lecture avec tenant, l'outbox
qui garde le tenant de chaque événement), et au-delà Knex livre les trois autres stratégies
(sécurité au niveau des lignes, schéma par tenant, base de données par tenant), Drizzle la
sécurité au niveau des lignes, Prisma et TypeORM rien de plus. Le tableau, et le
tenantIsolationContract que passe chaque stratégie, sont dans
Multitenance.
Pour le côté lecture, chacune des quatre livre aussi un traducteur des critères du noyau vers sa
requête (criteriaToDrizzle, criteriaToKnex, criteriaToPrisma, criteriaToTypeOrm) et un
registre de modèles de lecture pour les projections, tenus à criteriaContract et
readModelStoreContract sur PostgreSQL ; ni l'un ni l'autre n'a été essayé sur MySQL ou SQLite.
La CLI ne les génère pas encore : voir la
proposition sur le côté lecture pour l'état de chaque partie.
Pour les agrégats en event sourcing, chacune des quatre fait tourner l'event store
PostgreSQL du noyau (createKnexEventSourcing, createDrizzleEventSourcing,
createPrismaEventSourcing, createTypeOrmEventSourcing) : les flux, les snapshots, les
points de reprise des abonnements et les clés des personnes concernées, avec les tables déclarées
comme chaque ORM migre (createEventStoreTables, eventStoreTables, les modèles de
prisma/event-store.postgresql.prisma, eventStoreEntities). Chacun est tenu à
eventStoreContract et à eventStoreUnitOfWorkContract sur PGlite dans l'exécution unitaire ;
knex, Prisma et TypeORM les ont aussi passés sur PostgreSQL 17, à la main. Non fourni sur MySQL
ni sur SQLite. Quand le choisir : Event sourcing, par agrégat.
Par base de données
Section intitulée « Par base de données »| Drizzle | Knex | Prisma | TypeORM | |
|---|---|---|---|---|
| PostgreSQL | automatisé : suites de contrat sur PGlite (dans le processus) ; fonctionne avec les pilotes node-postgres, postgres-js, PGlite, Neon | automatisé sur PGlite par le protocole réseau, et sur un vrai serveur quand une URL est donnée (dernière exécution : PostgreSQL 18) : contrats, annulation, unité de travail imbriquée, prises en charge concurrentes | comme Knex, par @prisma/adapter-pg, les deux stratégies de prise en charge |
comme Knex |
| MySQL 8 | non fourni : le package est pour PostgreSQL seulement | à la main, une fois, contre 8.4 : contrats d'outbox et des événements traités, annulation d'append |
à la main, une fois, contre 8.4 par @prisma/adapter-mariadb |
à la main, une fois, contre 8.4 |
| SQLite | non fourni | automatisé, dans l'exécution unitaire : contrats de l'outbox et des événements traités sur une base en mémoire (better-sqlite3) ; pas de SKIP LOCKED, pas de schémas |
à la main, une fois, contrat d'outbox seulement ; le registre des événements traités a besoin d'un délégué sur mesure | à la main, une fois ; pas de SKIP LOCKED, pas de schémas |
| MariaDB, CockroachDB, SQL Server, Oracle | non fourni | jamais essayé | CockroachDB, SQL Server jamais essayés | jamais essayé |
| MongoDB | non fourni | sans objet | jamais essayé | jamais essayé |
| Version de la bibliothèque testée | non indiquée dans le README | non indiquée | Prisma 7.10 ; la plage de pairs admet la 6, sur laquelle rien n'a été essayé | TypeORM 1.1 ; la plage de pairs admet la 0.3, sur laquelle rien n'a été essayé |
« À la main, une fois » est la formule des README eux-mêmes : ces suites ne sont pas dans la CI, si bien qu'une régression sur MySQL, ou sur SQLite en dehors des registres de Knex, ne serait pas détectée par le kit.
Ce qu'ajoutent le générateur et les autres packages
Section intitulée « Ce qu'ajoutent le générateur et les autres packages »D'après packages/cli/README.fr.md et
packages/audit/README.fr.md :
- La persistance générée des quatre ORM est écrite pour PostgreSQL.
customdémarre sur des adaptateurs en mémoire tenus aux suites de contrat, que vous remplacez. generate repository --tenant-scoped, et chaque repository d'un projet initialisé avec--tenancy shared-table, est implémenté pour les quatre ORM ; aveccustomou sans ORM, l'adaptateur ordinaire est écrit et une note dit quoi ajouter, etinitrefuse la stratégie.- Le journal d'audit SQL existe pour les quatre ORM, sur PostgreSQL seulement ; le garde d'ajout
seul est créé par la première migration sur Knex, et sur Drizzle, Prisma et TypeORM
npm run db:generateajoute ses instructions à la migration qui crée les tables d'audit, ce que l'outil de l'ORM ne sait pas écrire (npm run db:audit-guardles affiche pour une migration écrite à la main). Aveccustomou sans ORM, le projet généré démarre sur un journal en mémoire derrière unTODO(platform). - Les specs rapides des adaptateurs s'exécutent sur PGlite ; Docker Compose fournit le vrai serveur.
- L'effacement d'une personne concernée des tables déclarées avec
personalFieldsexiste sur les quatre ORM (KnexPersonalDataErasure,DrizzlePersonalDataErasure,PrismaPersonalDataErasure,TypeOrmPersonalDataErasure), sous une seule suite de contrat ; le générateur n'écrit pas encore les déclarations (protection des données dès la conception).
PostgreSQL face aux autres
Section intitulée « PostgreSQL face aux autres »| Base de données | Place dans ce kit | Ce que vous perdez ou devez vérifier |
|---|---|---|
| PostgreSQL | la base par défaut, et la seule des suites automatisées de chaque adaptateur | rien |
| MySQL 8 | registres essayés à la main une fois (Knex, Prisma, TypeORM) | pas de persistance générée, pas de journal d'audit SQL ; DATETIME sans fuseau horaire sous Knex ; pas de SKIP LOCKED sur la 5.7 ; un schéma par contexte devient une base de données ou un préfixe de table |
| SQLite | registres de Knex automatisés dans l'exécution unitaire, les autres essayés à la main une fois | pas de schémas, prise en charge par comparaison et échange (compare-and-set), un seul écrivain : pour les tests et les outils, pas pour plusieurs instances |
| MongoDB, autres | pas d'adaptateur | stack.orm: custom : votre propre unité de travail (son run construit sur withinUnitOfWork du noyau), votre registre d'outbox et votre registre des événements traités, chacun passant les suites de contrat ; sans transactions multidocuments, la garantie de l'outbox n'est pas disponible |
stack.database accepte postgres, mysql, sqlite, mongodb et none
(CONFIG.md). init refuse toute autre valeur que postgres avec l'un des
quatre ORM : les autres valeurs vont avec --orm custom, où elles enregistrent un choix et ne
sélectionnent aucun package. init --database mongodb est accepté avec --orm custom bien que
la ligne d'usage de --help ne le mentionne pas.
Limites, et quand ne pas l'utiliser
Section intitulée « Limites, et quand ne pas l'utiliser »- Ordre. Aucun registre n'ordonne les événements, pas même par agrégat ; voir livraison et idempotence.
- Prisma. Pas de verrouillage de lignes dans le client (un
SELECT ... FOR UPDATE SKIP LOCKEDbrut, ou la prise en charge par comparaison et échange) ;claimdoit être choisi par vous, parce que le client ne révèle pas sa base de données ; les transactions interactives expirent ; pas d'index partiel dans le langage de schéma ;stats()fait trois requêtes SQL. - TypeORM. Un
EntitySchemaest statique : les types de colonnes suivent ledialectque vous passez.synchronize: trueest réservé aux tests. Un champjsonbdu typeColumnsestJsonDocumentde@ddd-ts-kit/typeormou une interface nommée :Record<string, unknown>ne compile pas dansinsertIgnoringConflictetupdategénérés, carQueryDeepPartialEntityde TypeORM le refuse. - Knex. Le contenu (payload) est sérialisé avec
JSON.stringify; MariaDB le rendrait sous forme de texte. Il en va de même d'une colonnejsonbdu projet :pgécrit un tableau JavaScript comme un littéral de tableau PostgreSQL et une chaîne telle quelle, donc un tableau ou une chaîne échoue avec22P02 invalid input syntax for type jsonlà où Drizzle, Prisma et TypeORM le sérialisent.jsonColumn(value)de@ddd-ts-kit/knexrépond le texte JSON que la colonne lit, quelle que soit la valeur : le mapper l'écrit pour une telle valeur (un objet passe dans les deux cas). - Drizzle. Ne nommez jamais une table dans du SQL brut : interpolez l'objet de table pour que la qualification par le schéma suive (skill persistence). Le package d'audit note que Drizzle imprime les paramètres d'une instruction échouée dans son message d'erreur : journalisez le code, pas le message.
- Toutes. Les migrations vont seulement vers l'avant et restent compatibles avec la version encore en service (étendre, migrer, contracter). Le kit fournit les définitions de tables pour l'outillage de migration propre à chaque outil ; il n'exécute aucune migration à lui.
Quand ne pas utiliser d'adaptateur d'ORM du tout : un contexte sans état (un pur traducteur), ou un modèle de lecture mieux servi par un moteur de recherche (plus bas) ou un cache, derrière un port à lui.
Un modèle de lecture dans un moteur de recherche : OpenSearch
Section intitulée « Un modèle de lecture dans un moteur de recherche : OpenSearch »Un modèle de lecture interrogé sur de nombreux critères et de nombreuses lignes, ou que plusieurs
services lisent, peut vivre dans OpenSearch plutôt que dans une table : @ddd-ts-kit/opensearch
implémente le même port ReadModelStore que les quatre ORM, si bien qu'un projecteur ne sait pas
dans lequel il écrit. Les critères du port de lecture deviennent le DSL de requête, une écriture
n'est appliquée que si son événement est plus récent et seulement sur le document qu'elle a lu, et
les locataires sont tenus à part par un index chacun (tenancy: { strategy: 'index' }) ou par un
champ de locataire et un alias par locataire qu'OpenSearch filtre lui-même
({ strategy: 'attribute' }). Il parle l'API REST sans bibliothèque cliente.
| Une table d'un ORM | OpenSearch | |
|---|---|---|
| Cohérence | la ligne se valide avec la marque d'événement traité | cohérent à terme : une recherche voit une écriture après le rafraîchissement suivant (une seconde par défaut), refresh: 'wait_for' l'attend ; l'écriture est hors de la transaction, et une nouvelle livraison est périmée |
| Locataires | une colonne de locataire, ou un schéma ou une base par locataire | un index par locataire, ou un index et un alias filtré par locataire |
| Reconstruction | ProjectionRebuild, sur PostgreSQL |
pas encore construite ; chaque index porte une génération et toute lecture passe par un alias, pour qu'une reconstruction puisse basculer |
| Recherche plein texte | celle de PostgreSQL, à la main | pas construite : une chaîne est un keyword, contains un wildcard sensible à la casse |
| Exploitation | la base que le projet fait déjà tourner | un cluster à faire tourner, dimensionner et mettre à jour |
init --search opensearch câble le paquet dans la plateforme : ce qui lui convient et ce qui ne
lui convient pas, comment un contexte écrit et teste son store et tient ses locataires à part sont
dans Modèles de lecture de recherche. Son
README montre la composition à la main, et
l'ADR-0008 consigne chaque choix et ce qui le
défait. Il n'a tourné que sur OpenSearch 3 ; les endpoints qu'il appelle sont ceux
qu'Elasticsearch partage, ce qu'aucune spec n'a prouvé.
Migrations : noms, fusions et ordre
Section intitulée « Migrations : noms, fusions et ordre »Plusieurs personnes ajoutent des migrations en même temps, sur un contexte ou sur plusieurs.
Chaque migration qu'écrit un projet généré est nommée <timestamp>_<what-it-does>, et
npm run db:generate refuse de s'exécuter sans la description : deux branches n'écrivent jamais
le même fichier. Elle refuse aussi une description qu'une migration du dossier porte déjà, et
nomme cette migration, avec les quatre outils : deux migrations du même nom se lisent comme une
seule dans une revue, et verify-merge reconnaît une migration à sa description.
| Outil | db:generate |
Écrit | Une migration fusionnée plus ancienne qu'une migration déjà appliquée |
|---|---|---|---|
| drizzle-kit 0.31 | ddd-ts-kit drizzle-generate --name, qui lance drizzle-kit generate --name (migrations.prefix: 'timestamp' dans drizzle.config.ts) |
migrations/20261012093000_add-invoices.sql, son snapshot meta/20261012093000_snapshot.json, une entrée de meta/_journal.json |
ignorée sans un mot : le migrateur applique les entrées plus récentes que la dernière enregistrée |
| knex 3 | npm run build, puis ddd-ts-kit knex-generate --name, qui nomme le fichier avec knex migrate:make et y écrit la différence entre createTables et les migrations |
migrations/20261012093000_add-invoices.js |
appliquée : knex exécute chaque fichier qu'il n'a pas enregistré |
| Prisma 7 | ddd-ts-kit prisma-generate --name, qui lance prisma migrate dev --create-only --name |
prisma/migrations/20261012093000_add_invoices/migration.sql (Prisma transforme - en _) |
appliquée par migrate deploy, qui exécute chaque migration qu'il n'a pas enregistrée (d'après sa documentation ; non mesuré ici) |
| TypeORM 1.1 | ddd-ts-kit typeorm-generate, qui lance typeorm migration:generate -d <data source>, à qui l'on donne le chemin : npm run db:generate migrations/add-invoices |
migrations/1791829645467-add-invoices.ts (des millisecondes, et un - : TypeORM fixe les deux) |
appliquée : TypeORM exécute chaque migration qu'il n'a pas enregistrée |
Sans DATABASE_URL dans l'environnement, Prisma et TypeORM n'ont besoin d'aucun serveur : la
commande démarre PostgreSQL en processus (PGlite sur @electric-sql/pglite-socket, comme
openTestDatabase()), y rejoue les migrations du projet (prisma migrate diff --from-migrations,
la base servant de base fantôme ; typeorm migration:run), compare le schéma et écrit la nouvelle
migration, garde d'audit comprise. Un agent dans le bac à sable génère donc ses propres
migrations. Avec DATABASE_URL, l'outil utilise ce serveur comme avant. Sous TypeORM,
npm run build passe d'abord (la source de données lit les migrations compilées), et db:migrate
le lance lui-même, pour ne jamais répondre que rien n'attend alors qu'une migration n'est pas
encore compilée ; un projet Prisma lit SHADOW_DATABASE_URL dans prisma.config.ts, que init
écrit.
Knex n'a pas de comparaison de schéma, et n'a jamais besoin d'un serveur pour générer :
ddd-ts-kit knex-generate démarre deux PostgreSQL en processus, exécute le createTables compilé
sur l'un et les migrations sur l'autre, puis chaque instruction de createTables du côté migré. Une
instruction qui répond que son objet existe est laissée de côté, les autres sont écrites dans la
migration, après un add column pour une colonne absente d'une table que les migrations ont créée.
La migration contient ce SQL et n'appelle rien de l'application : elle construit donc les mêmes
tables quoi que devienne createTables, et l'historique se rejoue sur une base neuve. Rien de
différent, rien n'est écrit, comme sur les trois autres. Une colonne modifiée ou supprimée, une table
supprimée, et un index, une contrainte, un déclencheur, une énumération, une fonction ou une vue
modifiés sous le même nom sont listés en TODO(domain) de la migration, à écrire à la main : les objets
sont comparés par la définition qu'en donne PostgreSQL. Une instruction de createTables qui change des
lignes ou retire quelque chose n'est jamais écrite, puisqu'une migration s'exécute sur une base qui
contient des données : c'est une ligne de la commande et un TODO(domain) de la migration suivante.
Toute autre instruction, la sécurité par ligne ou un commentaire, entre avec la table ou la colonne à
laquelle elle appartient. npm run db:generate -- <name> --custom (pnpm run db:generate <name> -- --custom aussi) écrit la migration vide de knex, pour un changement de données ou une instruction
écrite à la main.
db:migrate trouve DATABASE_URL dans le shell, sinon dans .env : knexfile.js,
prisma.config.ts et la source de données TypeORM chargent le fichier, puisque ces trois CLI ne le
font pas, et drizzle-kit le lit lui-même.
La commande prend la description après le script : npm run db:generate add-invoices
(npm run db:generate -- audit-guard --custom pour une migration drizzle-kit écrite à la main).
Avec un journal d'audit, les commandes du kit ajoutent les instructions de son garde d'ajout seul
à la migration qui crée les tables d'audit, une seule fois : un projet dont les migrations les
contiennent reste tel quel.
Deux migrations gardées séparées. Un outil qui génère depuis le schéma écrit, dans une
migration, la différence entre les fichiers du schéma et la dernière migration : deux changements
faits avant un seul db:generate donnent une seule migration. Quand elles doivent rester deux
(une nouvelle table, puis une contrainte une fois qu'elle est remplie ; une colonne ajoutée, puis
l'ancienne supprimée dans un déploiement suivant), changer le schéma en deux temps, avec un
db:generate après chacun : faire le premier changement, lancer
npm run db:generate add-due-dates, puis faire le second et lancer
npm run db:generate require-due-dates. Déjà générées en une seule et pas encore fusionnée : la
supprimer (sous drizzle-kit, son fichier .sql, son snapshot sous meta/ et son entrée du
journal), défaire le second changement, et procéder en deux temps.
Sans terminal. Quand un changement du schéma pourrait être un renommage (une colonne ou une
table disparaît et une autre apparaît), drizzle-kit demande sur un terminal s'il s'agit d'une
création ou d'un renommage. Mesuré avec drizzle-kit 0.31.11 (2026-10-15) : sans terminal, comme
le lance un agent ou un pipeline, il affiche Interactive prompts require a TTY terminal,
n'écrit rien et sort avec le code 0 ; sous un pseudo-terminal (script -qec), il pose la
question et attend une réponse que personne ne donne. Il n'a aucune option pour répondre
d'avance. Le script passe donc par ddd-ts-kit drizzle-generate : dans un terminal, c'est
drizzle-kit generate tel quel ; sans terminal, cette sortie, et le snapshot fourché décrit
plus bas, deviennent une erreur qui nomme la correction (code de sortie 2). La correction est un
changement qui ne se lit pas de deux façons : ajouter la nouvelle colonne dans une migration et
supprimer l'ancienne dans une suivante, ou écrire les instructions dans une migration
personnalisée. Prisma 7 n'attend pas non plus : là où prisma migrate dev poserait une question
(un avertissement de perte de données), il s'arrête sur une erreur dans un environnement non
interactif (lu dans son code, non mesuré) ; knex et TypeORM ne demandent rien.
Une clé primaire changée. drizzle-kit peut écrire l'instruction qui ajoute la nouvelle clé
primaire d'une table avant celle qui supprime l'ancienne, ce qui échoue sur la base (une table n'a
qu'une clé primaire), ou supprimer une colonne de l'ancienne clé avant l'instruction qui supprime
la clé, qui échoue alors parce que la colonne a emporté la clé avec elle ; non mesuré ici.
ddd-ts-kit drizzle-generate lit donc le SQL qu'il vient d'écrire et avertit, sans changer le
code de sortie, avec le fichier, les deux instructions et la correction : supprimer d'abord
l'ancienne clé, en remettant dans l'ordre les instructions de cette nouvelle migration, qui n'est
pas encore appliquée, ou écrire la migration avec --custom. Il lit les instructions
ALTER TABLE de PostgreSQL : une contrainte supprimée est une clé primaire quand le snapshot
d'avant la migration l'enregistre, ou quand son nom finit par _pkey (le nom que PostgreSQL donne
à une clé) ou _pk (celui que drizzle-kit donne à une clé composite) ; les colonnes d'une clé
viennent de ce snapshot, sinon du nom que drizzle-kit donne à une clé composite. Une clé d'un
autre nom que le snapshot n'enregistre pas, ou une instruction écrite sous une autre forme
(DROP d'une colonne sans COLUMN, un bloc DO), n'est pas vue : relire le SQL d'une telle
migration avant de la commiter.
L'avertissement défile avec la sortie ; la règle persistence/primary-key-order de
ddd-ts-kit check (un avertissement, comme toute nouvelle règle) lit les mêmes instructions dans
chaque fichier .sql du dossier des migrations et signale la migration, à la ligne de
l'instruction qui s'exécute trop tôt, avec la même correction, jusqu'à ce qu'elle soit corrigée
(ddd-ts-kit check --rule persistence/primary-key-order les liste).
Formaté comme le projet. drizzle-kit écrit le snapshot et le journal sous meta/ dans sa
propre mise en forme, que la porte de formatage d'un projet peut refuser. Une fois une migration
écrite, ddd-ts-kit drizzle-generate formate les fichiers JSON qu'il a écrits sous meta/ avec
le formateur que lance le script format de package.json, Biome ou Prettier, tel qu'installé
dans le projet, à qui il ne donne que ces chemins (le script lui-même formaterait tout le
projet) ; le SQL reste tel que drizzle-kit l'a écrit, et un chemin que la configuration du
formateur ignore est laissé de côté (le biome.json qu'écrit init ignore migrations/meta).
Il dit ce qu'il a formaté ; sans un tel script, ou quand le formateur échoue, il le dit, et la
migration reste écrite.
init n'écrit aucune migration knex : npm run db:generate initial écrit la première, comme sur
les trois autres. Un projet plus ancien garde son 00000000000000_initial.js (0001_initial.js
avant la 0.5), puisqu'une migration appliquée n'est jamais renommée, et son contenu passe en SQL :
le journal des versions dit comment.
Mesuré avec drizzle-kit 0.31.11 et drizzle-orm 0.45.4 (2026-10-12), deux copies d'un même projet générant chacune une migration, comme le feraient deux branches :
- avec l'ancien réglage par défaut (
prefix: 'index'), les deux écrivent0001_<random words>.sqletmeta/0001_snapshot.json: le snapshot entre en conflit comme un fichier ajouté deux fois ; - avec
prefix: 'timestamp', les fichiers et les snapshots n'entrent plus en collision, maismeta/_journal.jsonreste en conflit (chaque branche ajoute une entrée au même endroit), et une fois la fusion faite à la main, deux snapshots nomment le même parent :drizzle-kit checksort avec le code 1 etdrizzle-kit generateaffiche la collision et n'écrit rien (avec le code de sortie 0, dontddd-ts-kit drizzle-generatefait le code 2) ; - pire, une base de données qui a appliqué d'abord la migration la plus récente (l'autre branche a
été fusionnée et déployée avant) ignore définitivement la plus ancienne : le migrateur de
drizzle-orm n'applique que les entrées dont le
whenest plus récent que le dernier qu'il a enregistré. Mesuré sur PGlite : aprèsadd-payments, puis la fusion d'add-invoicesgénérée trois secondes avant elle, la base de données avaitaccounts, paymentset pasinvoices, sans erreur.
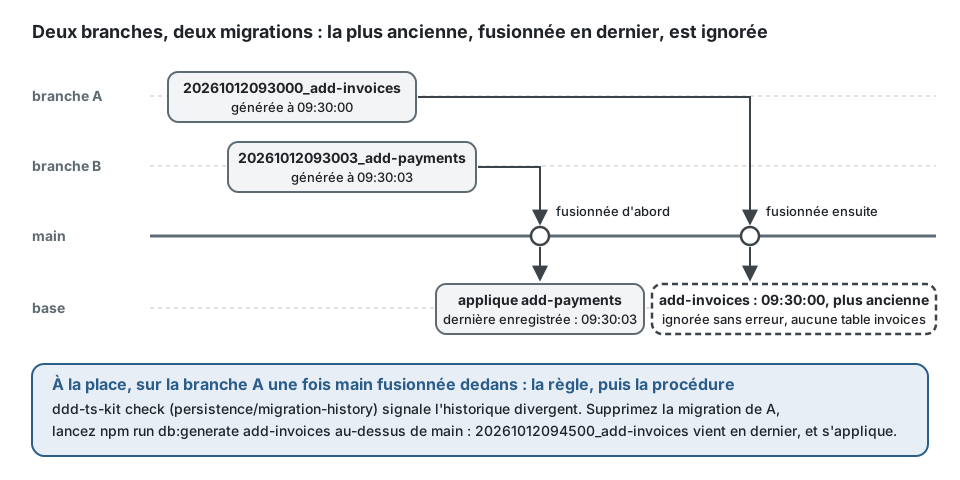
La réponse du kit est la règle persistence/migration-history de ddd-ts-kit check (donc de
npm run check:arch, de la garde du plugin et du pipeline) : chaque migration commence par
le nombre qui l'ordonne et deux migrations n'en partagent jamais un ; sous drizzle-kit, le
journal et les fichiers .sql concordent, les entrées gardent l'ordre dans lequel elles ont été
générées, et chaque snapshot suit celui qui le précède. Sur la fusion mesurée, elle signale le
snapshot divergent ; sur un journal fusionné dans l'ordre des branches, elle signale aussi
l'entrée hors d'ordre.
Après une fusion ou un rebase qui a apporté une migration de la branche principale, tant que la vôtre n'est pas encore fusionnée :
- prenez les migrations de la branche principale telles qu'elles sont (fichiers
.sql, snapshots, journal) ; - supprimez la vôtre : son fichier
.sql, son snapshot sousmeta/et son entrée du journal (drizzle-kit), ou son fichier ou son répertoire (les autres outils) ; - relancez
npm run db:generate <what-it-does>: elle est générée au-dessus de la branche principale, avec un horodatage plus récent ; npm run check:archne signale rien, et la branche est fusionnée avant qu'une autre migration n'arrive, sinon les étapes sont répétées.
npx ddd-ts-kit merge-trunk fait les étapes 2 et 3 en apportant la branche principale :
quand les deux côtés ont ajouté une migration depuis sa base, il prend le journal et les
snapshots de la branche principale et lance lui-même le replay ci-dessous ; un refus du
replay arrête la fusion avec son correctif. Avec --to-land, que le conductor lance juste
avant la fusion en squash, les migrations de la branche que la branche principale n'a pas
reçoivent leur vrai nom : rejouées sous drizzle-kit (le préfixe working- disparaît, dans le
worktree d'un worker aussi), renommées sous knex, Prisma et TypeORM (un numéro après le
dernier de la branche principale, sans working-, le contenu gardé ; la classe et le name de
TypeORM suivent, le dossier de Prisma aussi). Quand une migration reçue par la branche principale
depuis la base et une de la branche changent la même table, leur ordre est une décision : la
fusion s'arrête et dit de générer de nouveau celle de la branche sur la branche principale
(npm run db:generate <what-it-does>).
Sous drizzle-kit, ddd-ts-kit drizzle-generate --replay fait aussi seul les étapes 2 et 3, sur la
branche une fois la branche principale fusionnée dedans :
git merge origin/main # meta/_journal.json conflictsgit checkout origin/main -- migrations/meta/_journal.json # the journal of the main branchnpx ddd-ts-kit drizzle-generate --replay # --base <ref>, origin/main by defaultIl compare les fichiers .sql du dossier des migrations avec ceux de --base : ceux que la base
n'a pas sont ceux de la branche. Quand l'historique sur le disque ne fourche pas (le journal liste
chaque fichier dans l'ordre où ils ont été générés, chaque snapshot issu du précédent, donc ceux
de la branche suivent la dernière migration de la base), il ne génère rien : il renomme seulement
une migration dont le nom change (working- retiré, plus bas), son numéro, son snapshot et ses
instructions gardés, et le dit. Sinon il les supprime, avec leurs snapshots et leurs entrées du
journal (le journal devient celui de la base, dont le dernier snapshot est alors le parent de
ce qui suit), génère de nouveau chacune au-dessus, dans leur ordre et sous leur nom, et dit ce
qu'il a supprimé et généré. Une migration personnalisée (son snapshot répète celui qui le
précède) est générée de nouveau avec --custom et retrouve ses instructions. Il refuse, avec la
correction : un journal qui contient encore des marqueurs de conflit (prendre celui de la base,
comme ci-dessus : le replay trouve les migrations de la branche par leurs fichiers), une base
qui a des migrations que la branche n'a pas fusionnées, et deux migrations de la branche qui
changent le schéma : drizzle-kit génère la différence entre les fichiers du schéma et le dernier
snapshot, il ne peut donc pas redécouper les changements d'une branche en les étapes qu'ils
étaient, et une seule migration à leur place joindrait des étapes prévues séparées (une table,
puis une contrainte une fois qu'elle est remplie, échoue sur une base qui contient des lignes).
La correction les génère de nouveau à la main, une à la fois et dans leur ordre, comme le dit
« Deux migrations gardées séparées » plus haut : les supprimer, défaire
dans les fichiers du schéma tous les changements de la branche sauf celui de la première, lancer
npm run db:generate <son nom>, remettre le changement suivant et relancer (git show <commit>:<fichier du schéma> contient le schéma de chaque étape). Il
refuse aussi une migration générée dont drizzle-kit écrit maintenant les instructions autrement :
son SQL a été modifié à la main (une clé remise dans l'ordre, un index ajouté), ou la base a
changé ce qu'elle change. La générer de nouveau perdrait cela : il remet donc le dossier des
migrations tel qu'il l'a trouvé et dit quelle instruction diffère ; la correction est de générer
cette migration au-dessus de la base à la main et d'y réécrire les modifications
(git show HEAD:<file> les contient), après quoi un replay ne trouve plus rien de fourché. Le
replay est celui de Drizzle : sous knex, Prisma et TypeORM, qui ne tiennent pas de journal,
merge-trunk --to-land renomme les migrations, et en générer une de nouveau après un
recouvrement reste à la main.
Mesuré avec drizzle-kit 0.31.11, drizzle-orm 0.45.4 et PGlite 0.5.10 (2026-10-18), le vrai
drizzle-kit sur un schéma TypeScript : une branche ajoute une table pendant que la branche
principale en ajoute une autre, la branche la fusionne et prend son journal,
drizzle-generate --replay --base main génère de nouveau la migration de la branche au-dessus
avec les mêmes instructions, et drizzle-kit migrate applique les trois migrations à une base
vide ; de même quand chaque côté ajoute une colonne à une même table. Un second replay dit que
rien n'est fourché. Une migration de la branche à laquelle un index a été ajouté à la main est
refusée, et le dossier est comme avant le replay.
npx ddd-ts-kit verify-merge, lancé après la fusion, signale une migration de l'un ou l'autre
côté que le résultat a perdue. Elle reconnaît une migration à sa description, son nom sans son
numéro et sans working- : une migration générée de nouveau sous un autre numéro, ou sans le
préfixe, est gardée.
Une migration qui ne suit pas celles du tronc fait échouer verify-merge. Une branche qui vit
plus d'un jour porte une migration générée avant la dernière que le tronc a reçue entre-temps.
Sans <commit>, npx ddd-ts-kit verify-merge lit aussi les migrations de l'arbre de travail
face au tronc (la base du worker, sinon origin/HEAD, sinon origin/main, tels que git les
connaît : faites un git fetch d'abord) et échoue, en nommant la migration et la dernière du
tronc. --warn, que passe le hook de pre-push, adoucit ce qu'une fusion a perdu et jamais
ceci : le push s'arrête.
| Outil | Ce qu'elle signale | Ce qui remet l'ordre |
|---|---|---|
| drizzle-kit | une entrée que la branche ajoute au journal et dont le when n'est pas après la dernière entrée du journal du tronc, que le migrator sauterait ; un fichier .sql qu'aucune entrée du journal ne liste et que le tronc ne contient pas, comme après une fusion qui a gardé le journal d'un seul côté (celui que le tronc contient aussi revient au tronc) |
npx ddd-ts-kit merge-trunk, qui rejoue en ramenant le tronc. Une fois le tronc fusionné autrement : le meta/ du tronc, puis npx ddd-ts-kit drizzle-generate --replay --base <trunk> (ou merge-trunk --to-land, qui le fait à l'atterrissage). Le rejeu refuse une branche qui porte deux migrations changeant le schéma : elles sont générées de nouveau à la main, une à la fois, comme plus haut |
| knex, Prisma, TypeORM | une migration que la branche ajoute et dont le nom se trie avant la dernière migration du tronc : l'outil la jouerait après celle-ci là où elle est appliquée, et avant elle sur une base neuve | npx ddd-ts-kit merge-trunk --to-land, qui la renomme après la dernière du tronc en ramenant le tronc. Sur une branche qui contient déjà le tronc, il n'y a rien à fusionner : elle renomme quand même, seulement les migrations qui ne suivent pas déjà celles du tronc, dans leur ordre, et laisse le renommage à committer. Elle s'arrête, sans rien renommer, quand la migration et une migration plus récente du tronc changent la même table : supprimer d'abord cette migration (git show HEAD:<file> garde ce qui a été écrit à la main), puis npm run db:generate <what-it-does>, qui refuse un nom tant qu'une migration le porte |
Une migration de travail (working-<what-it-does>) est laissée de côté : sa place se décide quand
la branche atterrit, et persistence/migration-history la refuse déjà sur le tronc. Ce qui est
ordonné est ce que l'outil lui-même prend pour une migration, selon ce par quoi il l'ordonne :
sous knex chaque script de migrations/, par son nom (knex les charge tous, quel que soit leur
nom) ; sous Prisma les dossiers qui contiennent un migration.sql, par leur nom ; sous TypeORM
les classes dont le nom se termine par 13 chiffres, par ce nombre, quel que soit le nom du
fichier. verify-merge et merge-trunk --to-land lisent le même ordre. Rien n'est comparé pour
un commit nommé, sans la configuration du kit, ou quand aucune référence ne nomme un tronc.
Une base qui a déjà appliqué l'ancien nom. Une migration renommée ou générée de nouveau est une nouvelle migration pour l'outil, sur une base de développement, de prévisualisation ou partagée qui l'a appliquée sous son ancien nom. Réinitialiser cette base, ou corriger ce qu'elle a enregistré :
| Outil | Ce qui s'y passe | Ce qu'il faut corriger |
|---|---|---|
| drizzle-kit | le migrator joue la migration de nouveau | drizzle.__drizzle_migrations : ajouter une ligne dont le created_at est le when de la nouvelle entrée du journal, avec un hash quelconque (la colonne est obligatoire et jamais comparée) |
| knex | chaque migrate est refusé : The migration directory is corrupt, the following files are missing |
knex_migrations : mettre dans name de la ligne le nouveau nom du fichier, extension comprise |
| Prisma | il connaît encore la migration sous l'ancien nom | enregistrer le nouveau nom comme appliqué : npx prisma migrate resolve --applied <new name> |
| TypeORM | il joue la migration de nouveau | migrations : corriger timestamp, et name, la classe |
Les lignes de knex et de TypeORM sont lues dans le code des deux outils ; la commande de Prisma est celle que sa CLI documente, et ce que Prisma fait ensuite de l'ancienne ligne n'a pas été vérifié ici.
merge-trunk --to-land le dit chaque fois qu'elle renomme ou rejoue, et le correctif de
verify-merge aussi. --to-land --dry-run sur une branche qui contient déjà le tronc dit quelles
migrations bougeraient et n'en bouge aucune. Un atterrissage qui s'y arrête laisse le dossier des
migrations comme il l'a trouvé, sous drizzle-kit aussi, dont le rejeu supprime avant de générer :
la même commande se relance une fois la cause corrigée. Un renommage ne prend jamais un numéro
qu'un fichier du dossier porte déjà : il prend le suivant qui est libre, l'ordre gardé. Quand la
dernière migration du tronc ne porte aucun numéro qu'une migration puisse suivre (un helpers.js
dans le dossier de knex, que knex chargerait comme une migration et sur lequel il échouerait),
l'atterrissage s'arrête et dit de déplacer ce fichier : aucun renommage ne peut se trier après. Lu dans le code des quatre outils, et exécuté ici sur des dépôts git portant les fichiers
de chacun ; non mesuré face à une base de données.
Une migration déjà fusionnée sur la branche principale n'est jamais modifiée ni régénérée : une correction est une nouvelle migration.
Dans un travail en parallèle, un worker dont la slice change l'état stocké génère une
migration de travail dans son worktree, npm run db:generate working-<what-it-does>, pour que
les specs de sa branche tournent sur les tables dont elles ont besoin ; la garde lui refuse
toute autre migration. Le nom sert de marque parce que chaque outil ci-dessus le garde après son
numéro (20261015101500_working-add-claims.sql, 20261015101500_working_add_claims/ sous
Prisma, 1791829645467-working-add-claims.ts sous TypeORM) : le migrator l'applique comme les
autres, et rien ne change dans la configuration de l'outil. persistence/migration-history
l'admet là où existe le fichier de périmètre du worker, .ddd-ts-kit/worker.json, et le
signale partout ailleurs. Quand le conductor fusionne la branche sous drizzle-kit,
npx ddd-ts-kit drizzle-generate --replay (le tronc d'avant la fusion comme --base) supprime
la migration de travail, avec son snapshot et son entrée du journal, et la génère de nouveau sur
le tronc, après les branches fusionnées avant elle, sous son nom sans working- ; le conductor
commite la vraie migration avec la fusion. Dans le worktree d'un worker, qui fusionne le tronc
dans sa branche, le replay garde le préfixe. Avec des pull requests fusionnées en squash, le
conductor lance plutôt npx ddd-ts-kit merge-trunk --to-land --cwd <worktree> avant le
squash : la migration reçoit son vrai nom sur la branche, sous chaque outil (rejouée sous
drizzle-kit, renommée sous les autres), et arrive avec elle ; la garde refuse --to-land à un
sous-agent. Une migration de la branche et une reçue par le tronc sur la même table l'arrêtent :
le conductor génère celle-ci de nouveau sur le tronc par npm run db:generate <what-it-does>.
Écarté : un dossier de migrations par contexte. drizzle-kit peut faire tourner une
configuration par contexte (son propre schema, son out et sa table de migrations) : cela
fonctionnerait, mais cela résout la mauvaise moitié du problème. Deux personnes sur un même
contexte entrent toujours en collision, les tables de la plateforme (outbox, journal d'audit)
n'appartiennent à aucun contexte, et db:migrate deviendrait une liste ordonnée de commandes à
garder en phase avec la configuration. L'horodatage, la règle et la procédure ci-dessus couvrent
aussi bien un dossier unique qu'une équipe qui travaille sur un seul contexte. Un contexte extrait
en service emporte alors ses tables avec lui (generate service).
Ce qu'une migration a laissé de côté, avant un déploiement. L'ordre ci-dessus se lit dans les
fichiers ; ce que les migrations font des tables de modèle de lecture se lit dans une base.
npm run db:read-models lit, sur la base que nomme DATABASE_URL, les tables de modèle de lecture
que l'application liste, chacune par son propre registre (-- --context <contexte>, une fois par
contexte, pour les tables de ces seuls contextes, comme un contexte exécuté en service les vérifie
sur sa base) : il affiche la base qu'il a lue, celles de ses tables qui ne peuvent pas contenir la
trace d'une ligne supprimée, avec la migration qu'il faut à chacune, et sort avec le code 1 (2
sans base à lire, 3 quand aucune table n'a pu être lue, 4 quand --context nomme un contexte
auquel aucun modèle de lecture listé n'appartient). Une table n'est lue que si son registre est
listé : ddd-ts-kit check signale un registre écrit à la main dont la liste ne répond pas
(persistence/read-model-listed). L'application fait la même vérification à
son démarrage, des contextes qu'elle héberge, si bien qu'une table qu'une montée de version a
laissée telle quelle arrête le démarrage et non le premier événement qui l'atteint
(Chaque table vérifiée au démarrage, et avant un déploiement).
Une grande table de modèle de lecture : la seconde étape à part
Section intitulée « Une grande table de modèle de lecture : la seconde étape à part »La migration qu'écrit un refus a deux étapes. La première change la définition en une instruction
et prend ACCESS EXCLUSIVE sur la table, qui arrête ses lecteurs et ses écrivains jusqu'à la fin de
la transaction. La seconde valide la contrainte de vérification et vide les lignes supprimées
auparavant : elle lit toute la table. Dans la transaction de la première, elle s'exécute sous ce
verrou ; hors d'elle, sous SHARE UPDATE EXCLUSIVE et ROW EXCLUSIVE, qui n'arrêtent ni lecteurs ni
écrivains. Sur une petite table, écrivez les deux étapes dans une seule migration. Sur une
grande, la seconde étape va dans une migration à elle, et ce qui la met hors de la transaction de
la première diffère selon l'outil. Chaque ligne ci-dessous a été exécutée sur PostgreSQL 18 avec
les versions que le kit installe, les verrous lus dans pg_locks pendant la seconde étape :
| Outil | Ce qu'il fait des migrations en attente | La seconde étape hors de la transaction de la première |
|---|---|---|
knex 3 (knex migrate:latest) |
les exécute toutes dans une seule transaction : un second fichier tient encore ACCESS EXCLUSIVE | la seconde migration finit par export const config = { transaction: false }; (exports.config en CommonJS) : knex exécute alors les migrations une par une, et celle-ci instruction par instruction |
TypeORM (typeorm migration:run) |
une transaction pour toutes (migrationsTransactionMode: 'all', la valeur par défaut) |
migrationsTransactionMode: 'each' dans la source de données (data-source.ts) : chaque migration a sa transaction, et la seconde étape ne tient que SHARE UPDATE EXCLUSIVE et ROW EXCLUSIVE. transaction = false sur la classe de la migration est refusé sous 'all' (« override the transaction mode ») et fonctionne sous 'each' |
Drizzle (drizzle-kit migrate) |
une transaction pour tous les fichiers en attente, et aucun réglage ne le change (lu sur migrate() de drizzle-orm 0.45, que la commande appelle) |
le second fichier est appliqué par une exécution ultérieure : déployez la première migration, puis ajoutez la seconde et migrez de nouveau ; ou exécutez la seconde étape à la main (psql) une fois la première appliquée |
Prisma 7 (prisma migrate deploy) |
valide chaque instruction d'un fichier, sauf un fichier qui porte un bloc do, qu'il envoie d'un seul tenant : la première étape en porte un, si bien qu'un fichier avec les deux étapes est une seule transaction |
deux migrations : la seconde, des instructions simples, ne tient aucun verrou sur la table entre elles. Une instruction qui échoue dans un fichier d'instructions simples laisse appliquées celles qui la précèdent et la commande échoue : les instructions de la seconde étape peuvent être exécutées de nouveau |
Recommandation selon la situation
Section intitulée « Recommandation selon la situation »| Situation | Choix |
|---|---|
| Nouveau projet | Drizzle sur PostgreSQL : le choix par défaut, des requêtes typées, des migrations SQL, le cloisonnement par tenant et le journal d'audit SQL générés |
| Équipe tournée vers le SQL, beaucoup de requêtes écrites à la main, ou une base de code Knex existante | Knex sur PostgreSQL : la « stack de premier rang » éprouvée de bout en bout par la CLI l'utilise |
| Schéma Prisma existant | Prisma 7, les limites ci-dessus étant comprises ; prévoyez vous-même le registre du journal d'audit |
| Application TypeORM existante | TypeORM 1.x avec EntitySchema ; prévoyez vous-même le registre du journal d'audit |
| MySQL imposé | Knex ou TypeORM, et faites tourner les suites de contrat contre votre serveur dans votre propre CI |
| Un autre système de stockage | custom, derrière les mêmes ports, avec un enregistrement de décision |
| Un modèle de lecture interrogé sur de nombreux critères, ou lu par plusieurs services | @ddd-ts-kit/opensearch derrière le port du modèle de lecture, à côté de l'ORM du modèle d'écriture |
- Documentation de Drizzle ORM : https://orm.drizzle.team/docs/overview ; configuration de drizzle-kit,
migrations.prefix: https://orm.drizzle.team/docs/drizzle-config-file - drizzle-kit 0.31.11 (
prepareMigrationMetadata) et drizzle-orm 0.45.4 (PgDialect.migrate), knex 3.3.0 (MigrationGenerator,getNewMigrations), Prisma 7.10.0 (migrate dev --name), TypeORM 1.1.2 (MigrationGenerateCommand,MigrationExecutor) : lus dans leur code publié le 2026-10-12. - Documentation de Knex : https://knexjs.org/guide/
- Documentation de Prisma, transactions : https://www.prisma.io/docs/orm/prisma-client/queries/transactions
- Documentation de Prisma, migrations en développement et en production : https://www.prisma.io/docs/orm/prisma-migrate/workflows/development-and-production
- Documentation de TypeORM : https://typeorm.io
- Documentation de PostgreSQL,
SELECT ... FOR UPDATE SKIP LOCKEDet contraintes d'exclusion : https://www.postgresql.org/docs/current/sql-select.html , https://www.postgresql.org/docs/current/ddl-constraints.html - PGlite : https://pglite.dev
- Registre npm : versions, étiquettes de distribution, licences et téléchargements hebdomadaires lus le 2026-10-10.
- Martin Fowler, Patterns of Enterprise Application Architecture, Addison-Wesley, 2002 : Data Mapper, Unit of Work, Repository, Optimistic Offline Lock.
- Non vérifié : qu'aucune version des quatre bibliothèques ne puisse déclarer une contrainte d'exclusion PostgreSQL dans son langage de schéma ; la date de Drizzle 1.0 stable.