
Travailler en parallèle sans collisions
Résumé. Plusieurs personnes, ou plusieurs agents de code, peuvent construire un même projet en même temps si le travail est découpé le long des deux coutures que l'architecture a déjà : le contexte délimité (bounded context) et le cas d'usage vertical. Presque tout ce qui est à l'intérieur d'un contexte lui est privé et peut être écrit en parallèle sans risque. Une courte liste de fichiers est partagée par construction (la configuration, les barrels et les documents générés, la racine de composition, les migrations, le langage publié d'un amont) et doit être modifiée en séquence. Ce guide liste les deux, explique les worktrees, l'ordre de fusion et qui régénère quoi, et se termine par un plan concret : quatre contextes d'une application de prise de rendez-vous construits par quatre workers après un amorçage commun.
Deux façons de découper
Section intitulée « Deux façons de découper »Par contexte délimité. Un worker, un contexte. L'arborescence fermée met tout ce dont un
contexte a besoin sous src/contexts/<context>/, et les règles interdisent d'atteindre un autre
contexte autrement que par son langage publié. Deux workers dans deux contextes modifient donc
des répertoires disjoints.
Par cas d'usage vertical, à l'intérieur d'un contexte. Une commande ou une requête, de bout en
bout : son dossier sous application/commands/ ou application/queries/, sa route, ses specs.
Deux cas d'usage d'un même contexte partagent le fichier de l'agrégat et les déclarations
générées de leur couche (application/application.declarations.ts), ils entrent donc en conflit plus souvent que deux contextes. Ne parallélisez à
l'intérieur d'un contexte qu'une fois la forme de l'agrégat stabilisée.
Ne découpez pas par couche (« tu écris le domaine, j'écris les gestionnaires ») : chaque moitié est intestable tant que l'autre n'existe pas, et les deux se rencontrent dans chaque fichier.
Ce qui peut se faire en parallèle, et ce qui doit être séquencé
Section intitulée « Ce qui peut se faire en parallèle, et ce qui doit être séquencé »| Fichier ou zone | Écrit par | En parallèle ? | Comment s'y prendre |
|---|---|---|---|
src/contexts/<A>/** et src/contexts/<B>/** |
des workers différents | oui | disjoints par construction |
| deux dossiers de cas d'usage d'un même contexte | des workers différents | en grande partie | ils se rencontrent dans l'agrégat, les déclarations de leur couche et le fichier des routes : fusionnez souvent |
ddd-ts-kit.config.json |
init, generate context, generate service, generate worker, generate adr --deviation |
non | créez tous les contextes et toutes les relations à l'amorçage ; les changements ultérieurs un par un, par le propriétaire de la plateforme |
src/platform/composition/compose-application.ts, src/platform/composition/platform.module.ts, src/platform/composition/platform-test.module.ts |
generate context (la racine de composition), generate gateway (les deux modules, dans le style déclaré), des modifications à la main |
non | les régions d'enregistrement sont écrites entre des marqueurs ; deux branches qui ajoutent chacune un contexte les touchent toutes les deux |
les registres de la plateforme : src/platform/database/schema.ts (avec Prisma, la datasource de prisma/schema/schema.prisma), src/platform/auth/authorization/permissions.ts, src/platform/auth/authorization/role.ts, src/platform/auth/authorization/access-policies.ts (style explicite), src/platform/audit/audited-events.ts, src/platform/jobs/job-settings.ts, src/platform/database/read-model-tables.ts (les tables de modèle de lecture que l'application vérifie à son démarrage), les attributions sous src/platform/auth/, et l'utilitaire src/platform/resilience/own-policy.ts |
generate context, generate repository (le premier d'un contexte), generate command --aggregate sur un agrégat qui n'a pas encore de repository, generate route-group --role avec un nouveau rôle, generate policy (style explicite), generate integration-event, generate job, generate read-model (sur l'un des quatre ORM : il liste son registre), generate adapter (le premier d'un projet câblé sur tsyringe) |
non | lancez ces générateurs sur le tronc avant que les workers ne commencent ; generate --help --json dit quelles sortes écrivent des fichiers partagés (writesShared) et lesquels |
src/main.ts |
des modifications à la main | non | le propriétaire de la plateforme |
test/architecture/extractable.spec.ts, knip.json (le premier contexte) |
init, generate context |
non | de même : écrits avec chaque contexte |
<context>.declarations.ts et le <layer>.declarations.ts de chaque couche (ce qui est injecté dans chaque constructeur), <context>.dependencies.ts en mode découverte |
chaque generate dans ce contexte, docs, et npm run dev |
par contexte | dérivés : ne jamais fusionner à la main, régénérer (ci-dessous) |
docs/context-map.md, les listes générées de chaque CONTEXT.md |
ddd-ts-kit docs, chaque generate |
non, mais peu coûteux | dérivés : régénérer après la fusion |
openapi/*.yaml, docs/integration/asyncapi.yaml, docs/integration/event-catalog.md |
npm run docs:generate |
non, mais peu coûteux | dérivés et déterministes : régénérer après la fusion |
.dependency-cruiser.cjs |
depcruise-config --write, generate context |
non, mais peu coûteux | dérivé de la configuration : régénérer |
| les migrations de base de données | l'outillage de l'ORM | non | un schéma par contexte garde les tables séparées, mais la séquence des migrations est une seule liste : un worker génère une migration de travail, le chef d'orchestre la vraie au moment de la fusion |
le published-language/ d'un amont |
le propriétaire de l'amont, et generate gateway lancé pour un consommateur (le contrat de lecture) |
non pour ses consommateurs | fusionnez d'abord le contrat ; les consommateurs partent de lui |
src/shared-kernel/ |
les copropriétaires | non | rare par conception ; un changement à la fois |
package.json, le fichier de verrouillage |
quiconque ajoute une dépendance | non | ajoutez les dépendances à l'amorçage ou dans un changement dédié |
Le principe derrière ce tableau : un fichier est sûr quand un seul worker en est propriétaire, et un fichier dérivé n'est jamais un problème de fusion tant que personne n'essaie de le fusionner.
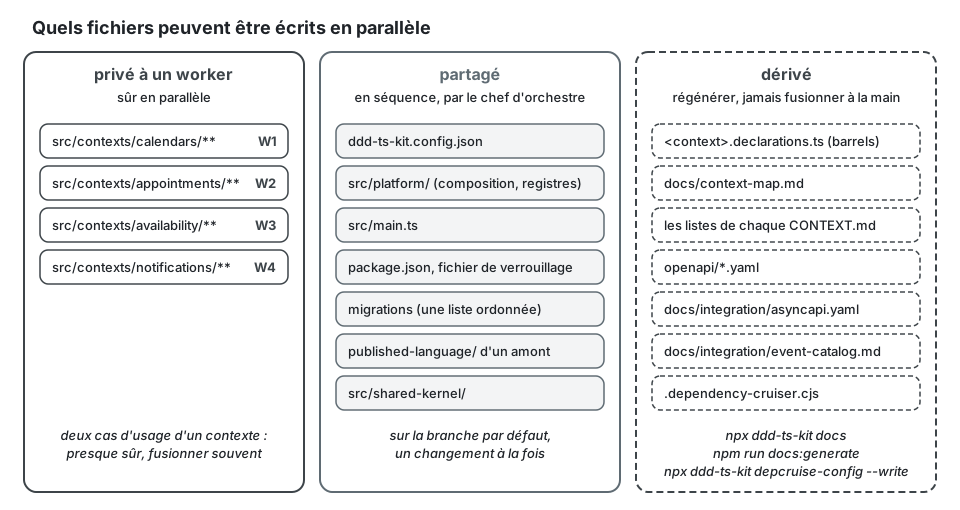
Les fichiers générés : régénérer, jamais résoudre à la main
Section intitulée « Les fichiers générés : régénérer, jamais résoudre à la main »Les déclarations de chaque contexte, la carte des contextes, les listes des CONTEXT.md, la configuration de
dependency-cruiser, le document OpenAPI, le document AsyncAPI et le catalogue des événements sont
tous des fonctions des sources. Quand deux branches ont modifié l'un d'eux, le conflit ne porte
aucune information. Prenez l'un ou l'autre côté, puis :
npm run regenerate # règles de dépendances, puis docs:generate : carte des contextes, listes des CONTEXT.md, barrels, OpenAPI, AsyncAPI, catalogue des événementsnpm run verifyEn entier, pour la branche qui arrive en second. Ici, le worker de notification a ajouté
GET /notifications/preferences pendant que la branche par défaut recevait
GET /people/invitations de identity. Le document OpenAPI trie ses chemins : les deux nouvelles
entrées tombent au même endroit, juste avant /people/me, et git ne sait pas les placer l'une
après l'autre. merge-trunk le règle :
git fetch originnpx ddd-ts-kit merge-trunk # la base du worker, sinon origin/HEAD, puis origin/main ; --trunk <ref> en nomme un autremerge-trunk build/notification <- origin/main (4be1d07)base 9c2e5a0: git merge-base (no commit of this branch found landed on the trunk)conflicts: plain git merge 1, own diff since base 1, automatic 1, for you 0automatic: openapi/openapi.yaml derived: trunk side, regenerated at the endregenerate: oklost lines: none lostcommitted 71d0c3a "Merge origin/main into build/notification"next: `npm run verify` in this worktree, then pushLe document régénéré porte les deux routes, /notifications/preferences de cette branche et
/people/invitations de la branche par défaut, parce que les deux sont désormais dans les
sources.
npx ddd-ts-kit merge-trunk apporte le tronc dans la branche en un seul commit de fusion et ne
rebase jamais. Il règle seul ce qu'un outil écrit : un fichier dérivé prend le côté du tronc et
est réécrit par npm run regenerate à la fin, le package.json d'un client prend le côté du
tronc à la plus haute des deux versions (la version est celle de l'équipe, et regenerate garde
celle qu'il trouve ; une version qui n'est pas une version sémantique vous est laissée), les
régions générées de CONTEXT.md et de la carte
des contextes prennent le côté du tronc, un conflit à l'intérieur d'un registre généré
(// ddd-ts-kit:<region>) garde les lignes des deux côtés (une ligne retirée par un côté reste
retirée), et la région est écrite avec ces lignes, comme avant, sauf dans trois cas. Dans les
deux premiers, la région d'un fichier TypeScript, JavaScript ou Prisma est fusionnée
déclaration par déclaration à partir des trois côtés : quand ces lignes n'apparieraient pas leurs
parenthèses (deux tables ajoutées au même endroit du fichier de tables d'un contexte sur Drizzle
ou sur TypeORM, deux fonctions qui les créent sur Knex, deux modèles de Prisma : git garde une
seule fois les lignes qu'elles partagent, leurs dernières), et quand deux instructions
différentes qui gardent chacune une parenthèse ouverte sur plusieurs lignes s'ouvrent ou se
ferment sur la même ligne dans un même conflit, ligne que l'union garderait une seule fois (une instruction que les deux côtés ont
ajoutée à l'identique est gardée une fois, comme avant, et ne compte pas). Le troisième cas est
recherché quand aucun des deux ne vaut, car les lignes des deux côtés peuvent apparier leurs
parenthèses et mélanger quand même les deux côtés. Chaque fois que le kit lit avec certitude les
trois côtés de la région, la région que donnent ces lignes est relue déclaration par déclaration,
un commentaire appartenant à la déclaration au-dessus de laquelle il se trouve. Elle est écrite,
comme avant et avec le même rapport, quand elle contient chaque déclaration entière et une seule
fois, telle que les trois côtés la fusionnent une à une (celle qu'un côté a ajoutée, modifiée ou
retirée alors que l'autre n'y a pas touché, celle que les deux ont écrite à l'identique, et pour
celle que les deux ont modifiée les lignes que le kit garde de cette déclaration fusionnée seule),
et quand une déclaration qui en lit une autre se trouve en dessous d'elle, comme du côté qui l'a
écrite ; l'ordre des lignes des deux côtés est gardé pour le reste. Sinon, la région est fusionnée
déclaration par déclaration comme dans les deux cas ci-dessus : la branche ajoute une colonne à une
table et stocke un agrégat en dessous, git met la colonne, la fin de la table et le début de la
suivante dans un seul bloc, et une colonne que le tronc a ajoutée à cet endroit atterrirait dans la
nouvelle table ; une table qu'un côté a retirée et que l'autre a déplacée reviendrait ; un
commentaire se retrouverait au-dessus d'une autre déclaration ; une constante se retrouverait
au-dessus de la table qu'elle lit. Rien n'est écrit dans la région, et ses blocs vous restent,
quand un côté a retiré une déclaration qu'une déclaration écrite ou modifiée par l'autre côté lit
désormais, ou quand la région fusionnée déclaration par déclaration mettrait elle-même une
déclaration au-dessus d'une autre qu'elle lit. Ce qu'une déclaration lit est trouvé par son nom,
sans lire aucune portée : une déclaration qui lie elle-même le nom (un paramètre, une constante
locale) est considérée comme ne lisant aucune autre déclaration de ce nom. Un arrêt est nouveau
là où les lignes des deux côtés étaient justes : un côté donne un autre nom à une table et
l'autre modifie cette table, et la table que l'autre a modifiée vous est laissée en un seul bloc,
le kit ne distinguant pas un renommage d'une suppression. Une région que le kit ne lit pas avec
certitude garde les lignes des deux côtés, comme avant, et de même une région dans laquelle un
côté contient des lignes qui ne terminent aucune instruction (les entrées d'une liste). La table que chaque
côté a ajoutée est alors gardée entière, celle que les deux ont ajoutée à l'identique est gardée
une fois, celle qu'un côté a modifiée ou retirée alors que l'autre n'y a pas touché suit ce côté,
celle que les deux ont modifiée prend la fusion de ses lignes quand elles fusionnent sans conflit
(une ligne retirée par un côté reste retirée), et celle que les deux côtés ont écrite différemment (deux tables du même nom, une table à
laquelle les deux ont ajouté une colonne au même endroit, une table modifiée
par un côté et retirée par l'autre) vous est laissée en un seul bloc de conflit qui contient
chaque version entière, le reste de la région étant fusionné ; les déclarations que les deux côtés
contiennent restent dans l'ordre du côté qui l'a seul changé, le nôtre quand aucun ne l'a fait, et
ce qu'un côté ajoute seul vient après la déclaration qu'il suit de ce côté (une région écrite avec
les lignes des deux côtés reste dans l'ordre de ces lignes). Ce que le kit ne fusionne pas ainsi garde les blocs que git
a écrits, pour vous, et le rapport dit pourquoi et de garder chaque déclaration entière, une
fois : une parenthèse sans sa paire, une expression régulière, une région écrite dans la région,
une instruction qui ne déclare aucun nom et qu'un côté a modifiée, des lignes qui ne terminent aucune instruction (les
entrées d'une liste, des instructions écrites sans ;) sur lesquelles les côtés diffèrent, deux instructions sans nom déclaré qui
s'ouvrent de la même façon, l'une contenant chaque ligne de l'autre, des déclarations que les deux
côtés rangent dans deux ordres différents, un export par défaut de chaque côté ; le rapport dit
the declarations of both sides kept, each one whole pour un fichier fusionné ainsi, suivi de
and the lines of both sides kept quand une autre région du fichier les a gardées ; l'index des schémas de Drizzle dont les deux côtés ont chacun stocké une table du même nom,
chacune dans le fichier de tables de son contexte, est réglé en entier comme le règlent les
générateurs quand les deux côtés sont lus avec certitude (la table que le tronc exporte sous un
nom le garde, quel que soit l'ordre de l'index et qu'un côté ait ou non découpé le contexte en
modules, chaque côté étant lu tel que son commit le dispose, et celle que la branche apporte est
listée sous le nom de son contexte, shippingOrders ; le rapport dit chacun sous automatic:,
en simulation aussi) ; sur TypeORM, la fusion n'écrit aucun nom de l'index, comme avant : elle ne
peut pas dire par le code si deux imports d'un même nom sont deux entités ou une, alors elle dit
chaque nom que la région des imports donne plus d'une fois, une fois, avec les fichiers d'où il
vient, en simulation comme à la fusion, et vous importez chaque entité sauf une sous son propre
nom et listez ce nom dans entities, ou retirez l'import en trop d'une même entité ;
init --force le dit de la même façon. Sur Drizzle, ce que le kit ne répare pas, il le dit, en simulation comme à la fusion : chaque table
qu'un côté avait à portée et que l'index fusionné n'exporte sous aucun nom, avec son fichier et
le nom qui la cache (une ligne écrite à la main, un module qui n'est pas le fichier de tables
d'un contexte), et chaque nom du tronc ou de la branche qui nomme une autre table après la
fusion, quand la table qu'il nommait est encore réexportée en entier par l'index fusionné. Une
ligne ou un import de l'index de Drizzle qui nomme la place où un côté tenait un fichier de tables que
l'autre côté a déplacé n'est pas réécrit : le rapport dit chacun, avec la place du fichier dans
l'arbre fusionné, et le kit n'écrit aucun nom dans cette fusion. Les lignes que le kit écrit dans
un index de Drizzle sont notées dans un trailer Kit-Written: et ne comptent jamais comme celles de la
fusion pour la vérification des lignes perdues : une ligne qu'une résolution négligente a perdue
arrête encore la fusion. Sur Drizzle, un
contexte pour lequel l'arbre fusionné tient deux fichiers de tables (un côté l'a découpé en
modules, l'autre a stocké une table à plat) ne reçoit aucune ligne, ni aucun autre nom de cette fusion, quand
les deux fichiers déclarent un nom en commun : le rapport le dit une fois, avec les noms que les
deux déclarent, lequel des deux fichiers garde chacun (celui dont l'index du tronc l'exporte,
sous ce nom ou un autre), et ce qui doit tenir une fois qu'une
personne en a fait l'unique fichier de shared/ (puis un commit et init --force), et nomme
encore chaque table cachée et chaque nom déplacé. Deux tels fichiers sans nom commun se fusionnent
comme les autres. Un fichier que le kit ne lit pas avec certitude
lui fait ne rien écrire et dire, une fois, quels noms peuvent être partagés et qui les garde,
sans ligne à copier ; un index qu'il ne peut pas écrire lui fait donner les lignes à écrire à la
main ; il n'en donne aucune quand il donnerait un nom du tronc à une autre table. Pour le reste, slices.md se fusionne ligne par ligne (chaque statut le plus avancé des deux côtés),
le verrou des événements stockés se fusionne par clé, le journal et les snapshots de
drizzle-kit prennent le côté du tronc avant le rejeu, le fichier de verrouillage prend le côté du
tronc et est réinstallé quand la branche a changé package.json.
Ce qui reste (un conflit dans un fichier source, dans un test, hors d'une région générée, une
cellule de slices.md changée par les deux côtés) demeure dans une fusion en cours que git
comprend (git status affiche UU), et la commande sort avec 1 en donnant, pour chaque fichier,
les lignes de chaque bloc, ce que cette branche et ses lignes du plan y ont fait, les commits
du tronc qui l'ont touché depuis la base et ce qu'ils y ont fait :
for you (a merge is in progress; `merge-trunk --abort` undoes it): src/contexts/billing/domain/invoice.ts hunks at lines 40-58 ours (build/billing-2, rows #M1.02): adds 4 lines: pay(amount: Money, at: Date): void { theirs (origin/main since 6d8be4b, 9a0c1f2 "feat(billing): cancel an invoice (#7)"): adds 3 lines: cancel(reason: CancelReason): void { both sides only add lines: keep both. Never take one side of the whole file.next: resolve each hunk, `git add <file>`, then `npx ddd-ts-kit merge-trunk --continue`Chaque bloc se résout en gardant ce que les deux côtés voulaient. git merge -X theirs,
-X ours ou git checkout --theirs <file> sur un fichier source règlent tous les conflits d'un
coup en jetant l'autre côté, et git annonce une fusion propre alors qu'une tranche entière de la
branche (sa méthode, sa route, sa spec, sa ligne marquée terminée) a disparu ; la garde du
plugin les refuse à un sous-agent. --continue refuse tant qu'un chemin n'est pas fusionné ou
garde un marqueur de conflit, puis pose les migrations, régénère, et lance verify-merge sur le
résultat non commité : une ligne ajoutée par un côté qui manque au résultat, une ligne de
slices.md qui n'est plus terminée, un test, un fichier de spec ou une migration disparu
l'arrête (sortie 1), avec file:line et le côté d'où la rétablir (git show ORIG_HEAD:<file>
pour cette branche). Ce que la branche principale a elle-même supprimé ou remplacé depuis la base,
dans un fichier que la branche n'a pas touché depuis qu'elle l'a quittée, est son changement, pas une
perte. Une suppression voulue : merge-trunk --continue --accept-lost, qui la
consigne dans le commit de fusion par un trailer Lost-Accepted: <file:line>,..., listé par
chaque passe suivante sans faire échouer. Le commit ne porte que les chemins de la fusion (les
chemins en conflit, les fichiers dérivés, les migrations, les décisions, le fichier de
verrouillage) ; tout autre chemin changé est listé et le bloque jusqu'à ce qu'il soit indexé ou
mis de côté. Le message porte Merge-Base: <commit>, Trunk: <commit> et, quand la branche a été
trouvée écrasée sur le tronc, Landed: <commit> : verify-merge juge ensuite la fusion sur cette
base. Une fusion terminée à la main par git commit garde ces trailers.
--dry-run donne l'aperçu (rien ne change), --abort défait la fusion en cours (un fichier que le kit régénère, comme une page de docs/behaviour/ ou un CONTEXT.md, et modifié après avoir été indexé par la fusion est restauré et nommé ; tout autre fichier changé à la main la fait refuser, code 2). --continue conclut le commit du tronc avec lequel la fusion a commencé : si le tronc a avancé depuis, il affiche trunk moved: ... et, une fois la fusion validée, npx ddd-ts-kit merge-trunk de nouveau apporte le reste. Avec Prisma, une fusion qui a changé un fichier de prisma/schema/ lance npm run db:client après regenerate, de sorte que generated/schema.sql, ignoré par git et lu par la base de test en processus, est à jour ; Drizzle, Knex et TypeORM ne dérivent aucun fichier de ce genre. L'arbre doit
être propre (les fichiers de périphérique que le sandbox monte sur les chemins qu'il interdit ne comptent pas) et aucune autre fusion, aucun rebase ni cherry-pick en cours (sortie 2 sinon) ;
le tronc n'est jamais récupéré, le commit qu'il nomme est affiché. Sans --trunk, le tronc est la base de .ddd-ts-kit/worker.json dans le worktree d'un worker (la référence d'où worker-scope a coupé sa branche), puis origin/HEAD, puis origin/main. merge-trunk demande
git 2.40 ; un git plus ancien ne fusionne qu'à partir de la base que git calcule
(--since <merge base>), avec git merge lui-même.
Sous le sandbox de Claude Code, la fusion d'un tronc qui change un chemin que la session ne peut
pas écrire (.claude/settings.json, que le sandbox monte toujours en lecture seule, un dossier
sous une règle de refus d'édition) revient au propriétaire. Avant d'écrire quoi que ce soit,
merge-trunk sonde chaque chemin que le tronc change (ou son dossier, pour un nouveau chemin) ;
quand l'un n'est pas inscriptible, il s'arrête sans rien changer, nomme les chemins et sort avec le
code 3, comme init. Le propriétaire lance la même commande depuis un terminal hors du sandbox.
verify-merge seul ne lit que git et liste, fusion par fusion, ce qu'une fusion a perdu ; il se
tait sans fusion : le hook de pre-push d'init le lance à chaque push, et verify-slice
le lance aussi ; tous deux ne font qu'avertir dans cette version, et une version mineure
ultérieure les fera bloquer.
Les générateurs sont déterministes (sortie triée, indépendante de l'ordre d'enregistrement), si
bien que deux personnes qui régénèrent à partir des mêmes sources obtiennent les mêmes octets.
docs --check et declarations/barrel-current font échouer le pipeline si quelqu'un a oublié.
Qui régénère : chacun, puis celui qui fusionne en second. Un worker lance
npm run regenerate après chaque slice et commite les fichiers dérivés avec elle, pour que sa
branche passe docs:check seule et ne s'arrête jamais sur « régénérer » comme besoin. La première
branche à arriver est cohérente par elle-même ; la seconde lance npx ddd-ts-kit merge-trunk,
qui prend le côté du tronc de chaque fichier dérivé, régénère et commite le résultat. La garde le
sait : verify-slice lance regenerate dans le worktree, ce qui réécrit les fichiers dérivés
hors du contexte du worker (clients/, docs/behaviour/, docs/context-map.md, openapi/,
docs/integration/, .dependency-cruiser.cjs), et un worker dont du code a tourné entre-temps
(verify-slice lui-même, ou sa sortie passée à node -e ...) n'est pas arrêté pour eux ; tout autre fichier
hors de son périmètre l'arrête encore.
Les migrations
Section intitulée « Les migrations »Chaque contexte possède ses tables dans son propre schéma de base de données, si bien que deux
contextes ne modifient jamais la même table, et les déclare dans un fichier à lui, celui de son
worker : le fichier des tables de son infrastructure/persistence/ (Drizzle, Knex, TypeORM) ou,
sur Prisma, prisma/schema/<context>.prisma, à côté du fichier principal partagé
prisma/schema/schema.prisma (le client, la datasource, les tables de la plateforme). Un champ
stocké change sa colonne et le mapper dans un même commit sur la branche du worker : une
colonne écrite seule sur le tronc y casse la vérification de types du mapper. Ce que les
contextes partagent, c'est la liste ordonnée des fichiers de migration. Générez la migration en dernier, juste avant la fusion, au-dessus de la
branche par défaut à jour ; si deux branches ont chacune ajouté « la prochaine » migration, la
seconde régénère la sienne. Ne modifiez jamais une migration qui a été exécutée quelque part.
Un worker dont la slice change l'état stocké a quand même besoin de la table pour ses
specs : il génère une migration de travail, npm run db:generate working-<what-it-does>, la
seule migration que la garde le laisse écrire. persistence/migration-history l'admet dans le
worktree et la signale sur le tronc : le chef d'orchestre la remplace donc à la fusion par la
vraie, générée sur le tronc (persistance).
Sous drizzle-kit, personne ne supprime ni ne régénère à la main : quand les deux côtés ont
ajouté une migration depuis la base, merge-trunk prend le journal et les snapshots du tronc
et génère de nouveau au-dessus les migrations de la branche que le tronc n'a pas
(drizzle-generate --replay), dans leur ordre et sous leur nom. Dans le worktree d'un
worker, elles restent des migrations de travail. Juste avant la fusion en squash, le chef
d'orchestre lance npx ddd-ts-kit merge-trunk --to-land --cwd <worktree> : le préfixe working-
disparaît, dans le worktree d'un worker aussi, et la vraie migration arrive avec la branche.
Un refus du rejeu (deux migrations de la branche qui changent le schéma) arrête la fusion avec
son correctif. Sous knex, Prisma et TypeORM, --to-land renomme chaque migration de la branche
que le tronc n'a pas : un numéro après le dernier du tronc, sans working- (TypeORM : la classe
et son name suivent, Prisma : le dossier), le contenu gardé. Quand une migration reçue par le
tronc depuis la base change une table qu'une migration de la branche change aussi, leur ordre
est une décision : la fusion s'arrête et dit de la générer de nouveau sur le tronc
(npm run db:generate <what-it-does>). drizzle-generate --replay reste pour une fusion faite
sans merge-trunk. Une migration de la branche qui se trie avant la dernière du tronc est une
erreur de verify-merge, --warn compris, donc le hook de pre-push l'arrête : le rapport nomme
les deux migrations et la commande ci-dessus qui remet l'ordre, et une migration de travail est
laissée de côté jusqu'à son atterrissage
(persistance). Sur une branche
qui contient déjà le tronc, merge-trunk --to-land n'a rien à fusionner et fait quand même
atterrir les migrations, laissées à committer. Un enregistrement de décision de la branche dont le tronc a pris le numéro
entre-temps reçoit le prochain numéro libre (son fichier, son titre # ADR-NNNN, les liens de
ses traductions).
Une décision prise pendant la construction d'une slice (comment s'arrondit une pénalité de
retard, à partir de quelle date court un délai) est enregistrée par le worker
lui-même : generate adr "<title>" écrit un nouveau fichier de docs/adr/, que la garde le
laisse remplir jusqu'à ce qu'il soit commité avec la slice. Une dérogation à une règle,
generate adr --deviation, écrit aussi la configuration : elle reste un besoin pour le chef
d'orchestre et une décision du propriétaire du projet. Deux branches qui ont pris le même
numéro se rencontrent à la fusion, où l'enregistrement le plus tardif prend le suivant libre.
Le langage publié d'un amont
Section intitulée « Le langage publié d'un amont »Un consommateur ne peut pas être construit contre un contrat qui bouge encore. Fusionnez d'abord la déclaration de l'amont (l'événement, son publisher, le catalogue régénéré), dans sa propre petite pull request, puis laissez les consommateurs commencer. Voir « Les contrats d'abord » dans Travailler en équipe.
Les worktrees de git
Section intitulée « Les worktrees de git »Un worktree est un second répertoire de travail du même dépôt, sur une autre branche. Il permet à plusieurs workers de tourner à la fois sur une même machine sans stash ni changement de branche :
git worktree add .worktrees/appointments -b feat/appointments-bookgit worktree add .worktrees/calendars -b feat/calendars-working-hoursLes worktrees d'un projet vivent dans son dossier .worktrees/, qu'init inscrit dans
.gitignore et que tous les outils du projet laissent de côté (Biome, ESLint, le checker,
Docker) : un seul endroit, jamais un dossier voisin perdu à côté du projet, jamais un worktree
imbriqué dans un autre, quel que soit le worktree d'où part la commande.
npx ddd-ts-kit worktree <name> en ouvre un pour n'importe quel travail, sur work/<name> coupé
de origin/main, installé. Dans un projet créé par init, la garde du plugin refuse le code
d'un contexte dans le checkout principal du tronc ("worktrees": "required", voir la
configuration) : le chef d'orchestre écrit lui aussi les contrats et les
squelettes dans un worktree à lui, les fait atterrir par une pull request, puis coupe les
workers de origin/main. Un projet démarré avant garde "advised" tant que son responsable ne
le pose pas : la garde dit seulement où va le code, et tant que son .gitignore ne contient pas
.worktrees/, les worktrees s'ouvrent à côté de lui, comme avant. Un worktree de
.worktrees/ sans son propre node_modules tournerait sur les paquets du checkout principal
au-dessus de lui, les versions du tronc : les commandes l'installent, et la garde refuse son code
tant qu'il ne l'est pas.
Pour un worker par contexte, la CLI le fait en une commande :
npx ddd-ts-kit worker-scope appointments --base origin/main --rows M1.12Elle ajoute un worktree sur la branche build/appointments (par défaut dans
.worktrees/appointments ; --worktree <path> et --branch <name> changent l'un et l'autre ;
un --worktree relatif sous .worktrees/ est celui du checkout principal, donc les lignes de
plan-waves valent depuis n'importe quel worktree, et tout autre chemin relatif part du projet
d'où l'on lance),
à partir de --base (par défaut la branche courante), y écrit .ddd-ts-kit/worker.json qui
nomme le contexte, avec les lignes de la consigne, la base et la branche, et affiche la consigne de ce worker : le répertoire qu'il peut écrire, les
générateurs qu'il peut lancer, ses lignes de docs/architecture/slices.md avec les règles écrites
sous les tableaux (- #M1.12: refuses a booking outside working hours), les contrats qu'il consomme,
et la base comme tronc de ses vérifications. --rows réduit la consigne à ces lignes, dans cet
ordre, avec une note au-delà de deux ; sans lui, la consigne tient le premier lot que
plan-waves découpe pour le contexte (une ou deux lignes encore à faire sur un agrégat : le
travail d'un agent), et une note nomme le --rows du lot suivant. --dry-run affiche la même chose sans rien toucher. Elle a besoin d'un dépôt
avec au moins un commit. Un worktree, ou une branche, qui existe déjà est conservé quand il
contient la base, et refusé sinon : un worker ne part jamais d'un tronc périmé. Sans --base,
lancée depuis le worktree d'un worker, elle refuse aussi, car la branche de ce worker
deviendrait le tronc. Quand elle conserve un worktree, seul le fichier est réécrit. Dans un worktree qu'elle
crée, elle lance ensuite l'installation propre du gestionnaire de paquets du projet (npm ci,
pnpm install --frozen-lockfile), sans bruit, et ses notes disent combien de temps elle a pris ;
quand l'installation échoue, ou que --no-install l'écarte, une note dit quoi lancer avant que
le worker ne démarre. init liste .ddd-ts-kit/ dans .gitignore, si bien que
le fichier n'est jamais commité. La garde du plugin en lit le context ; le reste est ce
qu'affiche status --workers :
{ "context": "appointments", "rows": ["M1.12"], "base": "origin/main", "branch": "build/appointments"}Depuis le checkout du tronc, npx ddd-ts-kit status --workers (--json pour des données) lit
chaque worktree du dépôt qui porte ce fichier et affiche, pour chaque worker : son
worktree, sa branche, son contexte, ses lignes, sa base, le nombre de commits qu'il a
d'avance sur la base, dependencies not installed quand sa copie du projet n'a pas de
node_modules (installed en JSON), les fichiers qu'il a changés (commités depuis la base de
fusion avec la base, modifiés, et non suivis mais non ignorés), et s'il a écrit
.ddd-ts-kit/report.md, avec sa date et s'il est à jour. Une fois sa branche fusionnée en squash dans la base, le
commit qui l'a reçue est affiché (landed), et ses commits d'avance et ses fichiers sont
comptés à partir de là : une branche réutilisée sans rien de neuf ne compte rien, et ce qui est
déjà arrivé n'est pas un recouvrement. Suivent ses commits de retard sur la base et ce que
merge-trunk laisserait en conflit maintenant (behind, mergePreview).
Une ligne state: dit où en sont ses
lignes et quoi faire ensuite (progress en JSON, décrit sous
Quand un agent s'arrête) :
state: stopped mid-row #M1.14 (6 files uncommitted, 3 TODO(domain), last verify-slice failed: tests); resume: npx ddd-ts-kit worker-scope billing --resumePuis les recouvrements : un contexte construit par deux workers, et chaque fichier changé par plus d'un worker, avec les workers qui l'ont changé. Un tel fichier entre en conflit à la fusion de la seconde branche quand les deux ont changé les mêmes lignes : lancez-la avant de confier une consigne à un second worker dans un contexte, pour lui donner d'autres fichiers, et avant chaque fusion, pour savoir quelles branches se rencontreront dans quels fichiers. Un fichier écrit par une version plus ancienne du kit ne porte que le contexte : le worker est affiché sans ses lignes ni sa base, et ses fichiers sont les seuls fichiers non commités. Sans worker, elle le dit en une ligne.
La consigne est remplie à partir du projet. Dans l'application d'exemple, un extrait de ce
qu'affiche npx ddd-ts-kit worker-scope notification --rows M1.31,M1.32,M1.33,M1.34 --dry-run (le chemin raccourci, main
comme tronc, et les générateurs, les étapes et le compte rendu omis) :
You build the bounded context notification of scheduling.
Worktree: .worktrees/notification/   Branch: build/notification   Trunk: mainRun every command from the worktree (`cd .worktrees/notification/ && ...` or `--cwd .worktrees/notification/`).Without node_modules: `npm ci`, never an install that names a package.
Scope- You may write: src/contexts/notification/**, test/e2e/<use-case>.e2e.spec.ts of your slices (split by behaviour into  test/e2e/<use-case>-<behaviour>.e2e.spec.ts when one grows long), and their helpers and worlds in  test/e2e/support/notification/.- You may not write anything else. Shared files (config, src/platform, src/main.ts,  package.json, lockfile, migrations, docs/) and other contexts are refused by the guard:  report the need, do not work around it. The shell writes inside your scope only, as the editor tools do:  a write outside it is refused, and the code you run that the guard cannot read (inline code, a script, your tests) is checked after it ran: a shared file it changed stops you until you put it back as the guard says. A slice that changes the stored state generates a  working migration only, one per branch (regenerate it): `npm run db:generate working-<what-it-does>`. A decision taken in a slice is  recorded by `generate adr` (without --deviation), and committed with it. The derived files (generated  documents, barrels, context map, dependency rules) are written by `npm run regenerate`, never by hand.
Slices, in this order (rows of docs/architecture/slices.md)- #M1.31 Contacts known from identity (projection): `@Projection` over `identity.person.registered` ; ...- #M1.32 Send a notification for a fact of an appointment: `port notification Mailer`; ...- #M1.33 Plan, withdraw and send reminders: `command notification PlanReminder --aggregate Reminder --permission reminder.plan`; ...- #M1.34 Sent notifications of a person: `query notification SearchNotifications --permission notification.read --search` (`GET /notifications`) ; ...
Contracts you consume (read-only): src/contexts/scheduling/published-language/, src/contexts/identity/published-language/
La conception d'une ligne, vérifiée contre le tronc
Section intitulée « La conception d'une ligne, vérifiée contre le tronc »Une ligne est souvent conçue avant d'être construite : dans ses cellules Slice et Start with,
dans sa ligne de règles, et dans une revue de conception de docs/architecture/ (par convention
docs/architecture/reviews/<sujet>.md, un titre ## #M2.03 <tranche> par ligne, les noms entre
accents graves). Le tronc avance pendant ce temps : un service devient un port, une commande est
retirée. Sous chaque ligne dont la conception vit dans un tel document, la consigne le nomme :
- #M2.03 Compute the refund: `command billing ComputeRefund ...` ; rules: ... design: docs/architecture/reviews/refunds.md (section "#M2.03 Compute the refund")worker-scope lit alors les noms que cette conception cite comme du code (chemins, classes,
Classe.membre) contre la base, dans l'historique du dépôt, sans l'extraire. Il ne signale que ce
qui a une preuve : un nom que l'historique de la base a retiré (avec le commit, et ce qui l'a
remplacé : le fichier vers lequel il a été renommé, ou un fichier que le même commit a ajouté avec
les mêmes mots), un emplacement que l'arborescence canonique refuse, et un nom que la base n'a
jamais eu quand un nom proche de même rôle (un port pour un service) est arrivé après l'écriture de
la ligne qui le cite. Un nom encore à construire reste muet, comme un nom dont la phrase dit qu'il
a été retiré. Quand quelque chose est signalé, la consigne porte un bloc de huit lignes au plus :
Names of the design that origin/main does not have (checked at 1a2b3c4): build on what origin/main has,and put each line in your report as a note for the conductor, who corrects the document.- docs/architecture/reviews/refunds.md:14 `RefundBasisService`: removed by 9f3e2d1 (2026-10-16, "fix(billing): read the refund basis through a port"); now `RefundBasisReader`, src/contexts/billing/application/ports/refund-basis-reader.port.ts (added with the removal)et le chef d'orchestre reçoit une note qui nomme les lignes : les corriger sur le tronc avant que
le worker démarre, ou le lancer tel quel, puisque sa consigne les liste. Un worker ne modifie
jamais docs/. Une base locale en retard sur sa branche amont, ou un clone superficiel, est notée
aussi : les noms ont été vérifiés contre ce qu'elle contient. --json porte la même chose sous
citations.
Sans workers, npx ddd-ts-kit cited --rows <id> --base origin/main vérifie de la même façon la
conception d'une ligne, et cited seul celle de chaque ligne non terminée ; le chef d'orchestre
le lance avant de committer une revue de conception. Après un changement, verify-slice liste les
noms que la tranche retire et que la conception d'une ligne non terminée cite encore, les lignes
du worker lui-même mises à part ; il n'échoue jamais pour eux, et le worker les transmet en
notes. Le relecteur lance cited --removed-since <base> pour une branche entière.
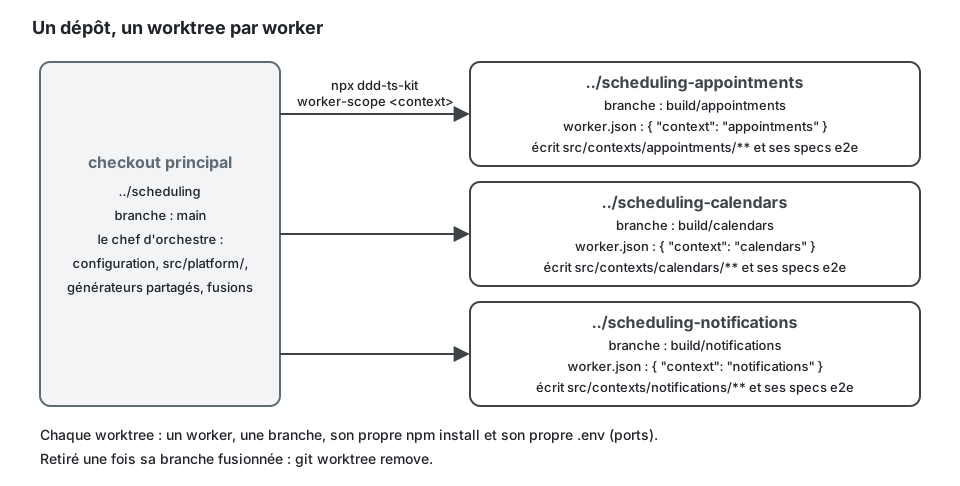
Chaque worktree a ses propres dépendances (elles ne sont pas partagées entre worktrees :
worker-scope les installe) et ses propres ports si deux d'entre eux lancent npm run dev ou les tests
de bout en bout en même temps : le docker-compose.yml généré prend ses ports dans .env, donnez
donc à chaque worktree son propre .env. Les tests rapides n'ont besoin d'aucun serveur (les
specs d'adaptateurs peuvent tourner sur un PostgreSQL dans le processus), et c'est ce qui rend
praticables quatre workers sur un seul ordinateur portable.
Un dépôt à sous-modules les clone de nouveau dans chaque nouveau worktree, ce qui peut prendre
des minutes. Empruntez les objets d'un checkout qui les a, et copiez-les aussitôt :
git submodule update --init --reference <checkout>/<chemin du sous-module> --dissociate <chemin du sous-module>.
Sans --dissociate, le nouveau worktree continue de pointer vers les objets de la référence, et
supprimer ce checkout le casse.
Les hooks git sont partagés par tous les worktrees du dépôt, et le lefthook.yml généré
lance le lefthook du worktree où ils se déclenchent (lefthook: node_modules/.bin/lefthook) :
un worktree sans ses dépendances fait échouer le commit, bruyamment, au lieu de sauter les
vérifications ou d'emprunter le lefthook d'un checkout qui a peut-être disparu.
npx ddd-ts-kit doctor signale un lefthook.yml sans cette ligne ou un clone sans le hook
(npm run hooks:install).
Un nouveau worktree part de rien, et ce qui s'y passe mal est son environnement, pas son code.
npx ddd-ts-kit doctor dans ce worktree dit, en une seconde et sans réseau, ce qui lui manque
pour faire tourner le projet : un Node qu'engines.node refuse ou que .nvmrc ne nomme pas, un
node_modules absent ou installé avant la dernière modification du lockfile, un paquet du kit
installé à une autre version que la CLI, un sous-module non initialisé ; chacun avec son
correctif. --strict échoue tant que le worktree ne peut pas faire tourner le projet.
Les règles qui empêchent les worktrees de faire du tort :
- un worker par worktree, une branche par worktree ; un worktree n'est pas un lieu de partage ;
- indexez fichier par fichier, et relisez le diff indexé avant de commiter : un
git addlarge dans un répertoire où écrit un autre processus commite le travail à moitié fini de quelqu'un d'autre ; - retirez le worktree quand sa branche est fusionnée (
git worktree remove) ; - un agent
context-builderrend son rapport comme dernier message (Claude Code refuse à un sous-agent l'écriture d'un fichier de rapport) ; un hookSubagentStopdu plugin écrit ce message dans.ddd-ts-kit/report.mdde son worktree (ignoré par git) : quand il s'arrête,worker-scope --resumele lit là avec le reste du worktree. Si le fichier manque, le chef d'orchestre l'écrit depuis le dernier message de l'agent.
Pour les agents de code en particulier : un agent à qui l'on dit de travailler « dans le contexte
appointments » et qui est lancé dans le checkout principal lira quand même, et pourra modifier,
n'importe quoi. Donnez-lui un worktree et nommez le répertoire dont il est propriétaire. Le
hook du plugin refuse un fichier écrit à la main là où un générateur existe et toute
modification d'un fichier généré (les trois contrats, le barrel, .dependency-cruiser.cjs), et
demande confirmation avant un changement des fichiers gouvernés (la configuration, celle du lint,
des tests, du compilateur et du pipeline). Pour son agent context-builder, il va plus loin :
avec un .ddd-ts-kit/worker.json dans le worktree, une écriture hors de
src/contexts/<context>/, des specs de bout en bout et de leur support dans
test/e2e/support/<context>/ est refusée (dans la spec d'acceptation
d'une story, tout sauf retirer pending(...) autour d'un scénario ; la verrouiller est refusé
aussi), de même qu'un générateur
qui écrit des fichiers partagés et un changement de dépendance, où que se trouvent ses options
(npm i -D zod) ; l'installation propre reste libre. Le même périmètre vaut pour le shell :
une édition en place comme sed -i, une redirection ou tee, et cp, mv, rm, touch,
git checkout -- <path> ou git restore passent dans le périmètre et sont refusés hors de lui,
ou sur un chemin que seul le shell connaît ("$FILE"). Le code que la garde ne peut pas lire
(du code en ligne donné à un interpréteur, un script, un shell nourri par son entrée, un script
de test ou de paquet) ne se lit pas d'avance : il s'exécute, la garde note l'état hors du
périmètre avant chaque telle commande (ses fichiers et HEAD) et le compare à la commande
suivante du worker, et un fichier qu'il y a changé, supprimé ou commité compris, arrête le
worker jusqu'à ce qu'il soit remis en état par la commande que la garde nomme
(git checkout HEAD -- <path>, le contenu gardé d'un fichier déjà modifié, git mv en retour, ou
rm d'un nouveau fichier, permis pour ces fichiers). Ce qu'une fusion du tronc apporte est au
tronc, pas un changement du worker : le tronc est la base que son fichier de périmètre
enregistre (une branche d'intégration comme work/<plan> aussi bien que la principale), la
branche que nomme origin/HEAD, main ou master, telles qu'elles étaient avant la commande
qui a fusionné (un worker fusionne avec merge-trunk, ou fait son fetch dans une commande à
part). Une fusion de toute autre branche est
retenue, et la garde ne nomme alors aucune commande : le worker ne défait rien et signale la
fusion au chef d'orchestre. Le périmètre est fixé au premier appel du
worker, par la commande qui nomme son worktree (cd <worktree> && ...) là où plusieurs
workers en ont un, et cette marque suit le worker : un appel qui part d'un autre checkout est
jugé d'après le worktree fixé. Un fichier de périmètre supprimé ou changé l'arrête. npx prettier dans un projet dont format lance
Biome et un npx biome nu sont refusés. Une sortie vers
/dev/null ou le répertoire temporaire du système reste libre, de même qu'un verrou que flock prend sous $XDG_RUNTIME_DIR (un seul verrou pour les exécutions lourdes de tous les checkouts d'une machine), et le chef d'orchestre n'est
tenu à rien de tout cela. La garde lit $TMPDIR, $XDG_RUNTIME_DIR et $HOME par leur valeur au début de la session et refuse un worker qui en affecte une ; une ligne qui en change une sous une forme qu'elle ne lit pas est jugée sur l'ancienne valeur. Elle arrête les erreurs d'un worker, pas un worker qui la contourne : c'est le rôle d'un bac à sable. Un worker passe --local-only
à generate : la commande refuse alors, et n'écrit rien, quand la sorte écrirait hors de son
contexte :
$ npx ddd-ts-kit generate job notification SendDueConfirmations --every 15m --command SendNotification --local-onlyError: --local-only: this command would write 2 shared files: src/platform/auth/relationships/relate-system-actors.ts, src/platform/jobs/job-settings.ts. fix: Nothing was written. A job of a row is a step of the conductor, before the row of the worker: on the trunk, run `ddd-ts-kit generate job notification SendDueConfirmations --every 15m --command SendNotification`, commit it there, merge the trunk into the worker's branch (`ddd-ts-kit merge-trunk`), then fill its TODOs. Have it run on the trunk without --local-only (the conductor of a parallel build does it), merge the trunk, then go on; a generated document listed alone means the trunk is stale: run `ddd-ts-kit docs` there first.Le refus d'un job ou d'un integration-event affiche la commande exacte (la même, sans
--local-only). Un job ou un événement d'intégration de la ligne d'un worker est une étape du
chef d'orchestre sur le tronc, avant la ligne du worker (les contrats d'abord) : le plan la tient
pour une ligne skeleton ou contract dont dépend la ligne du worker, qui fusionne le tronc
puis remplit les TODO. Un modèle de lecture gardé dans une table (generate read-model sur
Drizzle, Knex, Prisma ou TypeORM) est aussi une telle étape, à chaque fois : le générateur ajoute
son registre à src/platform/database/read-model-tables.ts, la liste qu'une application vérifie
à son démarrage.
Quand un agent s'arrête
Section intitulée « Quand un agent s'arrête »Un agent s'arrête avant la fin de ses lignes pour bien des raisons : sa limite de tours
(maxTurns: 150 pour le context-builder), un contexte plein (Prompt is too long), une limite
de débit, une personne. Il ne peut pas compter ses propres tours, on ne le lui demande donc pas :
le garde compte et l'avertit, et ce qu'il laisse se lit dans git et dans des fichiers que le kit
écrit, jamais dans ce qu'il dit.
Deux avertissements avant la limite. Le garde compte les appels d'outils d'un
context-builder dans les hooks qui tournent déjà sur ses commandes shell et ses écritures
(aucun hook n'est ajouté sur chaque appel d'outil), et ajoute un avertissement à l'appel qui
franchit chaque seuil, une fois par exécution : « your turn limit is near » (finir la tranche en
cours, n'en commencer aucune autre) et « your turn limit is close » (ne plus changer de code,
commiter ce que verify-slice a validé, finir par le rapport). Les lectures (Read,
Grep, Glob) ne sont pas vues, et les seuils supposent donc un quart des appels non comptés :
sur les exécutions mesurées, où presque chaque appel passait par le shell, les avertissements
sont arrivés à 90 et 117 appels sur 150, tôt plutôt que tard. S'arrêter tôt coûte un message ;
s'arrêter tard perd le rapport. Un agent repris reçoit un nouveau budget de tours, et son compte
repart de zéro.
Ce que tient le worktree, tout sous .ddd-ts-kit/, ignoré par git :
- les commits de la branche, chacun fermant une ligne avec le trailer
Slice: <id>: dans le worktree d'un worker,verify-sliceaffiche la commande de commit exacte,git commit -m "feat(billing): pay an invoice" -m "Slice: M1.14"(un commit sans trailer, d'un kit plus ancien, est apparié dans l'ordre aux commitsfeat(<contexte>)et affiché(by order); sur une branche gardée pour ses lignes suivantes, les commits faits avant qu'elle n'apporte la base enregistrée parworker-scopesont ceux des lignes déjà arrivées, et ne sont pas lus) ; verification.json, écrit parverify-slicedans le worktree d'un worker : quand il a tourné, à quel commit, pour quelle ligne, les étapes en échec et les chemins qu'il a listés à indexer ;agent.json, écrit par le garde : l'identifiant de l'agent, son exécution (1 au lancement, une de plus à chaque reprise), quand elle a commencé et à quel commit, quand il a été vu pour la dernière fois, les appels comptés, les appels de chaque ligne commitée, et son dernier arrêt quand il a fini de lui-même, avec ce que le garde a trouvé laissé hors de son périmètre (status --workerset--resumele disent aussi) ;report.md, écrit par le hookSubagentStopdepuis le dernier message de l'agent, suivi de ce que le garde a trouvé laissé hors du périmètre à cet arrêt, dont la fraîcheur se lit à l'heure du dernier commit et du dernier changement d'un fichier de la tranche.
Une commande pour le chef d'orchestre. Sur une notification d'arrêt, depuis le tronc :
$ npx ddd-ts-kit worker-scope billing --resumeworker build/billing  .worktrees/billing  (base origin/main)rows: #M1.07 committed a1b2c3d, #M1.12 committed d4e5f6a, #M1.14 in progress, #M1.15 to do#M1.14: 6 files uncommitted (src/contexts/billing/...), 3 TODO(domain), 2 it.todo; last verify-slice 2026-10-17T19:02Z failed: tests (2 files changed since)report: written 2026-10-17T19:05Z (current)agent: a389e09, run 1, 104 tool calls counted, last tool call 2026-10-17T19:06Z, stopped without ending (a limit or an error) with a current report
next: SendMessage to a389e09:---Continue row #M1.14 (Pay an invoice) in .worktrees/billing; do not start #M1.15.Committed: #M1.07, #M1.12. Left modified by you: src/contexts/billing/... 3 TODO(domain) and 2 it.todo remain; your last verify-slice failed at tests.Next: finish #M1.14, `npx ddd-ts-kit verify-slice billing --since origin/main` until it passes, commit with the command it prints, end with your report as your final message.---If SendMessage is refused, or the agent stops again without progress: launch a new context-builder with this briefing:---<the briefing of #M1.14 only, then: Resume: row #M1.14 was started by an earlier agent. These files exist and are yoursto continue: never regenerate, delete or reset them: ... Start with `npx ddd-ts-kit todo billing` and `verify-slice`, notwith the generators. Its report: (quoted, 200 words at most)>---
Elle ne fait que lire : elle ne crée ni worktree ni branche et ne réécrit aucun fichier, un
sous-agent peut donc la lancer aussi. next vaut SendMessage quand l'agent s'est arrêté au
milieu d'une ligne après un progrès, dans une exécution qui n'est pas sa troisième (il garde son
historique) ; un nouvel agent entre deux lignes, sans agent enregistré, après trois exécutions,
après une exécution sans progrès, ou avec --fresh (un contexte plein) ; la fusion quand chaque
ligne est commitée et que rien ne reste. Plusieurs worktrees d'un même contexte demandent
--worktree <chemin> ou --branch <nom>. --json donne { progress, next, sendMessage, briefing }. Dans une nouvelle session du chef d'orchestre, le démarrage de session nomme chaque
worker à reprendre avec cette commande ; sans worktree de worker, il ne lance aucun
processus pour cela.
Ce que les hooks vérifient, et ce qu'ils ne peuvent pas. Vérifié par des exécutions sans
interface de Claude Code : un avertissement ajouté par le garde atteint le modèle de l'agent, qui
le suit ; SubagentStart se déclenche au lancement et à une reprise par SendMessage ;
SubagentStop se déclenche quand l'agent finit de lui-même et honore un block, et le garde le
relance alors une fois quand il laisserait non commitée une tranche que verify-slice a validée,
et il écrit le rapport depuis son dernier message. Un arrêt à la limite de tours ne déclenche aucun hook : les
avertissements sont le mécanisme principal, et --resume lit le reste dans le worktree.
La compétence parallel-work dit au chef d'orchestre quoi faire à chaque sorte d'arrêt : lancer
--resume, envoyer le message tel quel sans demander, lancer la consigne d'un nouvel agent,
attendre la fin d'une limite de débit, et après deux arrêts sur une même ligne sans nouveau
commit, découper la ligne ou demander au responsable.
Vagues et lots
Section intitulée « Vagues et lots »Quand plusieurs histoires se construisent en même temps dans un contexte, quelles lignes peuvent
commencer, comment les grouper pour les agents, quels groupes peuvent tourner côte à côte et dans
quel ordre fusionner se calcule à partir de docs/architecture/slices.md, sans le déduire à la
main :
npx ddd-ts-kit plan-waves # the whole plan; plan-waves <context> for one context; --json for dataLa commande prend les lignes qui ne sont pas done. La vague 1 porte les lignes dont toutes les
dépendances sont faites ; la vague n les lignes dont les dépendances sont faites ou dans des
vagues antérieures : les lignes d'une vague ne s'attendent jamais entre elles. Chaque vague est
découpée en lots : un propriétaire et un contexte par lot (le worker d'un contexte, le chef
d'orchestre ou une personne), deux lignes au plus, puisqu'un agent en tient deux avant que ses
tours ou son contexte s'épuisent, et deux lignes dans un même lot seulement quand leur
Start with nomme le même agrégat (--aggregate Invoice, aggregate billing Invoice,
repository billing Invoice). Deux lots d'un contexte dans une vague qui nomment le même agrégat
risquent de toucher les mêmes fichiers : lancez-les l'un après l'autre. Quand un lot ne nomme
aucun agrégat, la commande dit que le chevauchement est inconnu au lieu de le deviner. Chaque lot
d'un worker vient avec sa commande worker-scope, avec un worktree et une branche à lui quand
sa vague porte un autre lot de ce contexte ; un lot du chef d'orchestre se construit sur le
tronc. Chaque ligne nomme les lignes qu'elle attend avec leur statut, et avec leur contexte et
leur histoire quand elles appartiennent à une autre histoire ou à un contexte qui n'est pas
montré. Les lignes d'une histoire qu'une autre histoire attend sont listées à nouveau après les
vagues, avec leur propriétaire, leur statut et le lot qui les porte : avant de lancer une vague,
vérifiez que quelqu'un les porte, sinon la vague attend un travail que personne ne fait. Suit
l'ordre des fusions : par vague, et dans une vague d'abord le lot que le plus de lignes
attendent. Pour deux histoires dans billing, un extrait :
Waves (docs/architecture/slices.md): 7 rows not done, 2 waves, 6 batchesWave 1 W1.1 billing (aggregate Invoice) #US1.02 slice "Issue invoice" #US1.03 slice "Cancel invoice" npx ddd-ts-kit worker-scope billing --base origin/main --rows US1.02,US1.03 --worktree .worktrees/billing-w1.1 --branch build/billing-w1.1 likely to touch the same files as W1.3 W1.2 conductor, billing (aggregate Customer) #US2.01 skeleton "Customer" on the trunk, by the conductor, in the worktree of the plan (`npx ddd-ts-kit worktree <plan>`) ...Wave 2 W2.3 billing (aggregate unknown) #US2.03 slice "Overdue invoices", after #US1.02 (todo, billing, story US1) npx ddd-ts-kit worker-scope billing --base origin/main --rows US2.03 --worktree .worktrees/billing-w2.3 --branch build/billing-w2.3 unknown whether it touches the files of W2.1, W2.2: no aggregate namedRows another story waits for, not done #US1.02 billing slice "Issue invoice" (story US1, owner billing, todo): in W1.1, waited for by #US2.03Merge order: W1.1, W1.2, W1.3, W2.1, W2.2, W2.3Before each merge: `npx ddd-ts-kit merge-trunk --to-land --cwd <worktree>`, then the squash mergeUn plan qui ne peut pas être ordonné n'a pas de vague : un cycle dans Depends on, une
dépendance vers un identifiant qu'aucune ligne ne porte, une ligne sans propriétaire ou un
identifiant que portent deux lignes est signalé seul, et la commande sort avec 1.
Entre deux fusions, npx ddd-ts-kit status dit de chaque ligne non faite si elle est prête sur
le tronc (toutes ses dépendances faites), prête sur une branche (chaque dépendance non faite est
une ligne confiée à un worker dont le worktree a des commits d'avance sur sa base, lue dans
son .ddd-ts-kit/worker.json), ou en attente, avec les identifiants qu'elle attend :
#US1.04 billing slice "Pay invoice" (owner billing, depends on US1.02): ready on a branch, once #US1.02 merges #US2.02 billing slice "Register customer" (owner billing, depends on US2.01): waits for #US2.01Une story ou un jalon est clos quand npx ddd-ts-kit story-check <code> sort avec 0 : ses lignes
sont faites et il ne reste aucun marqueur qui lui appartient. Quand plusieurs stories construisent
un même contexte à la fois, un marqueur est attribué avant de bloquer : à la ligne que son texte
nomme (TODO(review): #US1.04 <remarque>, la forme qu'écrit la relecture), sinon à la ligne que
nomme le commit qui a écrit sa ligne (son trailer Slice: <id>, sinon son message), sinon,
non commité dans le worktree d'un worker, aux lignes de ce worker. Un marqueur qui
n'appartient à aucune ligne ne bloque que si aucune autre story ouverte n'a de ligne dans son
contexte ; sinon il est listé sans bloquer, pour que le chef d'orchestre le règle ou l'attribue en
nommant sa ligne. --strict bloque sur chaque marqueur des contextes de la story. status nomme
une story dont toutes les lignes sont faites mais que des marqueurs qui lui appartiennent gardent
ouverte :
story US1: every row done, 2 markers left: npx ddd-ts-kit story-check US1Une ligne arrivée sur le tronc avec la branche d'un worker alors que le fichier des tranches du tronc ne la marque pas terminée est nommée, pour que le chef d'orchestre la marque :
#US1.02 landed on the trunk (d8d281b) but is not marked done: mark it done in docs/architecture/slices.mdL'ordre de fusion
Section intitulée « L'ordre de fusion »- L'amorçage, seul, en premier.
- Les contrats, l'amont avant l'aval : suivez les flèches de la carte des contextes.
- Les tranches à l'intérieur de chaque contexte, dans n'importe quel ordre d'un contexte à l'autre.
- Les consommateurs d'un événement, après la fusion de la déclaration de l'événement (ils n'ont pas besoin que le comportement du producteur existe : un gestionnaire est testé avec des événements construits à partir de la déclaration).
- Les specs de bout en bout qui traversent plusieurs contextes, en dernier, quand les deux côtés sont en place.
Fusionnez petit et souvent. Deux branches qui ont vécu chacune une semaine entreront en conflit dans l'agrégat et dans chaque fichier dérivé ; le même travail en dix pull requests n'entre en conflit nulle part.
Avant chaque fusion en squash, le chef d'orchestre apporte le tronc dans la branche et pose ses
migrations : npx ddd-ts-kit merge-trunk --to-land --cwd <worktree>, npm run verify dans le
worktree, push, puis la fusion en squash. --to-land revient au chef d'orchestre : la garde
le refuse à un sous-agent, qui lance merge-trunk seul. Un squash fait hors de GitHub ou de
GitLab se vérifie par npx ddd-ts-kit verify-merge <squash commit> --theirs <head of the branch>.
Une branche coupée d'une autre branche non fusionnée est empilée, et une branche réutilisée pour
sa ligne suivante après la fusion en squash de sa première ligne est dans la même situation :
ses premiers commits sont sur la branche par défaut sous la forme d'un seul nouveau commit,
et un simple git merge les rejoue en conflits (et garde une migration de travail à côté de la
vraie que le tronc a générée). merge-trunk calcule plutôt la fusion à partir du commit le plus
récent de la branche que le tronc porte déjà : le commit dont le patch entier, sans les
fichiers que les outils réécrivent, est un commit du tronc (trouvé sur cette branche, sur la
branche enregistrée comme sa base dans .ddd-ts-kit/worker.json, ou sur une branche locale qui
partage des commits avec elle), sinon la base que worker-scope a enregistrée quand toutes ses
lignes sont sur le tronc, sinon la base de fusion de git. Aucun appel à GitHub ou GitLab : des
patch ids seulement.
merge-trunk build/billing-2 <- origin/main (d8d281b)base 6d8be4b: build/billing-1 landed as d8d281b "feat(billing): issue and cancel (#1)"conflicts: plain git merge 3, own diff since base 1, automatic 1, for you 0Une base trouvée trop ancienne se voit en conflits de plus, jamais en perte silencieuse : quand la
première branche a été supprimée et que rien ne prouve où elle est arrivée, le rapport nomme
chaque branche qui partage des commits et n'a pas été trouvée, avec le --since <commit> à
passer une fois qu'une personne a vérifié. Un --since trop récent est la seule façon de perdre
du travail : la fusion laisse tomber ce que la branche a ajouté avant lui. --since à la tête de
la branche est refusé, et verify-merge arrête la fusion sur chaque fichier ajouté par la branche
que le résultat n'a pas alors que le tronc n'a jamais touché son chemin. Le worker d'une branche
empilée a cette autre branche pour base : une fois celle-ci arrivée, nommez le tronc,
merge-trunk --trunk origin/main. status --workers en donne l'aperçu pour chaque
worker : où sa branche est arrivée, ses commits d'avance et ses fichiers changés comptés à
partir de là (plus de faux recouvrements avec ce qui est déjà arrivé), ses commits de retard, et
ce que merge-trunk laisserait en conflit maintenant.
Un plan concret : quatre contextes, quatre workers
Section intitulée « Un plan concret : quatre contextes, quatre workers »Une application de prise de rendez-vous avec quatre contextes : calendars, appointments,
availability, notifications (analytics est ajouté plus tard de la même façon ; l'identité
est achetée, pas construite). L'application d'exemple de ce dépôt a suivi le même genre de plan
sur ses propres quatre contextes (identity, scheduling, notification, analytics), avec
scheduling partagé entre deux workers sur deux agrégats : son tableau est
examples/scheduling/docs/architecture/slices.fr.md.
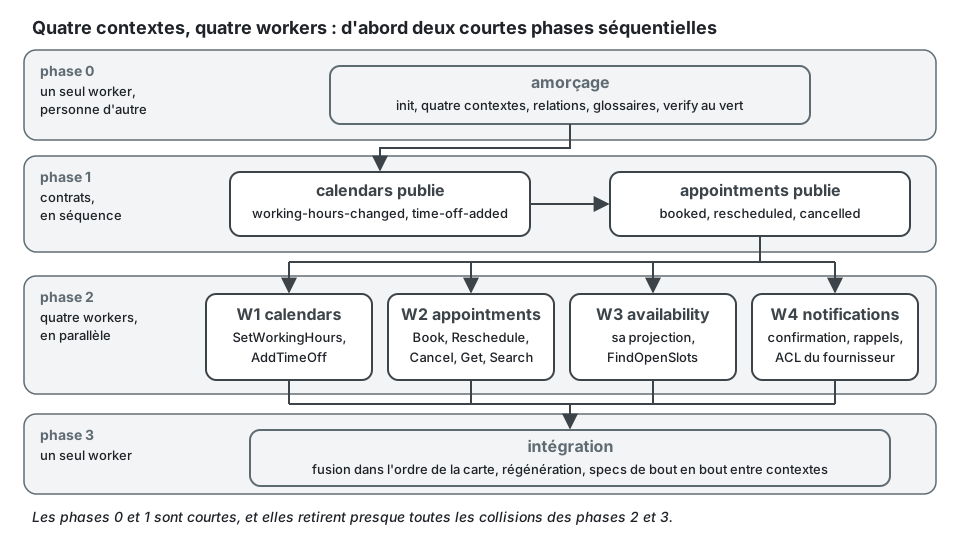
Phase 0, amorçage commun (un worker, personne d'autre ne commence).
npx ddd-ts-kit init --context calendars:supporting --context appointments:core \ --context availability:supporting --context notifications:supportingpnpm install && pnpm run verify # npm install && npm run verify avec --package-manager npmEnsuite, toujours en séquence, parce que chacun de ces changements modifie la configuration ou un
enregistrement partagé : les amonts de chaque contexte (appointments nomme calendars ;
availability nomme calendars et appointments ; notifications nomme appointments), les
premiers termes de chaque glossaire, et toute dépendance dont la stack a besoin. Fusionnez. À
partir de là, la configuration est gelée pour la durée de la phase.
Phase 1, contrats (en séquence, chacun dans une petite pull request). Les deux amonts
déclarent leurs événements d'intégration avec generate integration-event. Les agrégats
derrière eux peuvent être des coquilles vides : ce qui compte, ce sont le type, la version et le
contenu déclarés. Régénérez le catalogue. Fusionnez calendars d'abord, puis appointments.
Phase 2, quatre workers, chacun dans un worktree, chacun propriétaire d'un répertoire.
| Worker | Possède | Construit | Dépend de (déjà fusionné) |
|---|---|---|---|
| W1 | src/contexts/calendars/ |
l'agrégat Calendar, SetWorkingHours, AddTimeOff, leurs routes ; émet les deux événements |
rien |
| W2 | src/contexts/appointments/ |
l'agrégat Appointment, les commandes et requêtes de réservation, la contrainte d'absence de double réservation ; émet les trois événements |
les événements déclarés de calendars, s'il garde une copie locale des horaires de travail |
| W3 | src/contexts/availability/ |
les gestionnaires d'intégration qui alimentent sa projection, FindOpenSlots |
les événements déclarés des deux amonts |
| W4 | src/contexts/notifications/ |
le gestionnaire sous le nom de consommateur notifications.appointments-appointment-booked (la forme générée, <context>.<reaction>), le job notifications.send-reminders, la couche anticorruption du fournisseur |
les événements déclarés d'appointments |
La consigne de chaque worker dit : le seul répertoire qu'il peut écrire, les fichiers qu'il ne
doit pas toucher (la configuration, src/platform/, src/main.ts, un autre contexte, tout
document généré), qu'il ne doit pas régénérer les documents partagés, et qu'il s'arrête et rend
compte si sa tranche semble exiger un changement hors de son répertoire, en marquant chaque
besoin bloquant (la tranche ne peut pas être finie sans lui) ou note pour la fusion. worker-scope affiche
cette consigne. W3 et W4 testent leurs gestionnaires avec des événements construits à partir des
déclarations ; ils n'attendent pas que W1 et W2 aient fini.
Phase 3, intégration (un worker). Fusionnez dans l'ordre de la carte (calendars,
appointments, availability, notifications), régénérez les fichiers dérivés après chaque
fusion, écrivez les migrations en séquence, puis ajoutez les specs de bout en bout qui
traversent plusieurs contextes (réserver un rendez-vous, observer la confirmation et la
disparition du créneau) et lancez npm run verify.
Le plugin consigne le même plan sous forme de tableau : la skill plan-slices produit
docs/architecture/slices.md, où chaque ligne est un contract, un skeleton (un agrégat et
son repository, dont les générateurs écrivent aussi des fichiers partagés) ou une slice, avec
un propriétaire et les lignes dont elle dépend. Les contrats et les squelettes appartiennent au
chef d'orchestre, les tranches au worker de leur contexte, et seul le chef d'orchestre modifie
le fichier. npx ddd-ts-kit status le relit : les tranches par statut et par propriétaire, et
les TODO(domain), TODO(platform), it.todo et TODO(review) restants dans chaque contexte ;
npx ddd-ts-kit todo <context> les liste sous la forme file:line.
Quatre lignes de ce tableau dans l'application d'exemple, telles que status et worker-scope
les lisent :
| # | Contexte | Sorte | Tranche | Commencer par | Dépend de | Propriétaire | Statut |
|---|---|---|---|---|---|---|---|
| M1.03 | notification | skeleton | Notification, Reminder | aggregate notification <Name> puis repository notification <Name>, deux fois |
conductor | done | |
| M1.31 | notification | slice | Contacts known from identity (projection) | @Projection sur identity.person.registered |
M1.04 | notification | todo |
| M1.32 | notification | slice | Send a notification for a fact of an appointment | port notification Mailer ; adapter notification Mailer --kind external --decorators ; command notification SendNotification --aggregate Notification --permission notification.send ; integration-handler notification scheduling scheduling.appointment.booked, .confirmed, .rescheduled, .cancelled |
M1.03, M1.05, M1.31 | notification | todo |
| M1.34 | notification | slice | Sent notifications of a person | query notification SearchNotifications --permission notification.read --search (GET /notifications) |
M1.32 | notification | todo |
La ligne M1.03 est un squelette : ses générateurs écrivent l'index des schémas de la plateforme, le
chef d'orchestre la lance donc sur le tronc. Les lignes M1.31, M1.32 et M1.34 appartiennent au worker
notification, comme la ligne M1.33, laissée hors de cet extrait ; le worker commence chacune
une fois fusionnées les lignes dont elle dépend.
Ce qui fait fonctionner le plan, c'est que les phases 0 et 1 ne sont délibérément pas parallèles. Elles prennent une petite fraction du temps total et retirent presque toutes les collisions du reste.
Faire tourner le conducteur sans personne
Section intitulée « Faire tourner le conducteur sans personne »Un conducteur lancé par claude -p (tâche planifiée, script) n'a personne pour répondre. Le
brief le dit, nomme la vague à construire et indique si le projet a un dépôt distant ; Claude Code
n'expose rien d'autre. Le skill tient alors le
conducteur à cinq règles :
- garder le tour tant qu'un worker tourne.
claude -pn'attend les agents en arrière-plan que 10 minutes d'inactivité au plus (CLAUDE_CODE_PRINT_BG_WAIT_CEILING_MS), et pas du tout avec--bare; le reste s'arrête, son travail non commité dans le worktree ; - ne jamais reprendre un worker par
SendMessage: fusionner le tronc dans sa branche et lancer un nouveaucontext-buildersur le même worktree avec les lignes restantes (worker-scope --resume --fresh) ; - après deux arrêts sur une même ligne sans nouveau commit, finir la ligne soi-même ;
- quand le propriétaire l'autorise à pousser, pousser la branche d'intégration (
work/<plan>) après chaque fusion d'un worker, jamais la branche principale : un redémarrage perd un worker, pas toute l'exécution ; - s'arrêter à la fin de la vague de
plan-wavesreçue, avec un rapport.
Limites et quand ne pas s'en servir
Section intitulée « Limites et quand ne pas s'en servir »- Le parallélisme n'aide pas la découverte. Tant que les frontières et le langage bougent encore, quatre workers produisent quatre hypothèses incompatibles. Ne découpez qu'une fois l'amorçage et les contrats fusionnés.
- À l'intérieur d'un contexte, le gain est faible. Les cas d'usage partagent l'agrégat ; au-delà de deux workers, les fusions coûtent plus que ce que le parallélisme rapporte.
- Un contexte dont le contrat de l'amont n'est pas stable ne peut pas commencer. Séquencez-le.
- Un agent tient une ligne, deux au plus. Avec une douzaine, un agent de code épuise ses
tours ou son contexte au milieu de l'une d'elles, et laisse un worktree à moitié modifié,
sans rapport. Donnez une ligne par agent (
--rows), lancez-les en séquence dans le worktree du contexte, chacun commitant sa ligne, puis apportez le tronc dans la branche (npx ddd-ts-kit merge-trunk), relisez le lot une fois, lanceznpm run verifysur la branche fusionnée, et ouvrez la pull request :check --changed-sincene voit que les fichiers de la branche, et ce que le tronc a reçu entre-temps peut casser l'ensemble. Le garde avertit deux fois l'agentcontext-builderdu plugin avant sa limite de tours, pour qu'il garde ses derniers tours pour un commit et son rapport, etworker-scope --resumefait de ce qu'il a laissé le message ou la consigne qui le reprend (Quand un agent s'arrête). - Les agents multiplient le coût autant que la vitesse. Chacun porte sa propre fenêtre de contexte ; quatre workers dépensent environ quatre fois les tokens d'un seul, voir Économie de tokens. Sur une même machine, ils partagent aussi la mémoire, le processeur, les ports et le démon Docker : lancez autant de workers que la machine en tient, et plafonnez-les (Isoler les agents de code).
- Rien ne verrouille un fichier entre des personnes. Les règles interdisent les imports entre
contextes ; elles n'empêchent pas deux branches de modifier la configuration. Le séquencement
ci-dessus est une discipline, tenue par la revue et par la consigne que reçoit chaque worker.
Le confinement par
.ddd-ts-kit/worker.jsondécrit plus haut ne s'applique qu'à l'agentcontext-builderdu plugin, dans une session Claude Code, et laisse passer en cas d'échec comme le reste du hook ;--local-onlyvaut pour tout le monde, mais seulement pour ce qu'écritgenerate. - Le plan suppose le style déclaré avec un barrel par contexte. Dans le style explicite,
<context>.module.tsest un fichier d'enregistrement maintenu à la main à l'intérieur de chaque contexte : toujours privé au contexte, mais un point de conflit entre deux cas d'usage de ce contexte.
- Documentation de Git,
git-worktree, https://git-scm.com/docs/git-worktree - Matthew Skelton et Manuel Pais, Team Topologies, IT Revolution, 2019.
- Sam Newman, Building Microservices, 2e édition, O'Reilly, 2021, chapitre 5 (contrats et conception partant du consommateur).
- Ce dépôt : le README de la CLI (ce qu'écrit chaque
générateur, les régions entre marqueurs, les barrels dérivés,
worker-scope), les skillsparallel-worketplan-slices.
Voir aussi
Section intitulée « Voir aussi »- Parcours d'une story : une session par user story, une story par terminal
- Isoler les agents de code : la charge de plusieurs workers sur une machine, et leur isolation
- Travailler en équipe
- La discipline des commits
- Méthodologie
- Économie de tokens
- La carte des contextes : un exemple détaillé
- Monolithe modulaire