
@ddd-ts-kit/knex
Les adaptateurs knex des ports du noyau et des événements : une unité de travail que les
repositories ne voient jamais, le store de l'outbox transactionnelle, le store des événements
traités, un helper de migration pour leurs tables, et un schéma de base de données par
contexte délimité (bounded context). Les mêmes pièces que @ddd-ts-kit/drizzle, pour les projets
qui écrivent leur SQL avec knex. Autour d'elles : les helpers d'un repository (concurrence
optimiste, colonnes d'audit et de tenant, pages), les quatre stratégies d'isolation des
tenants, les critères et les modèles de lecture, et les stores de l'event store, des jobs en
arrière-plan et des gestionnaires de processus.
npm i @ddd-ts-kit/knex knex pgPostgreSQL d'abord. MySQL 8 et SQLite fonctionnent avec le même code ; voir Couverture des dialectes pour ce qui est testé, et comment.
Sa place dans une application
Section intitulée « Sa place dans une application »Rien d'ici n'est importé depuis domain/ ni application/. Le domaine déclare ses ports de
repository et l'application ses ports de requête ; les adaptateurs écrits avec ce package
vivent dans l'infrastructure/ de chaque contexte, et l'unité de travail est construite dans
platform/. Un seul objet fait charnière : createKnexUnitOfWork(db) répond à la fois au
UnitOfWork dans lequel le bus de commandes exécute chaque commande, et au KnexContext par
lequel chaque adaptateur atteint la base de données.
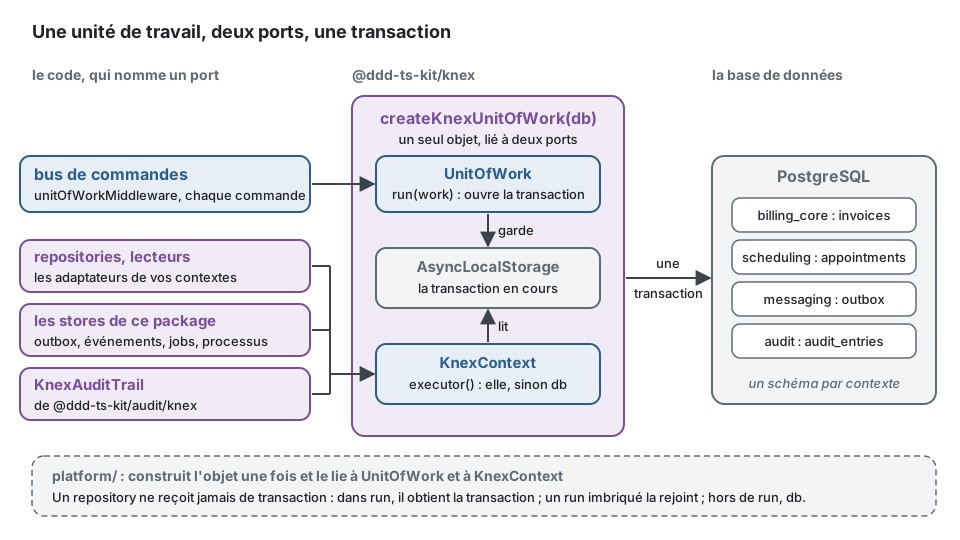
Plutôt que de faire descendre une transaction le long des appels, ce qui met un type knex dans chaque signature, du gestionnaire (handler) à l'adaptateur, et fait de son oubli un bogue silencieux, l'adaptateur demande au contexte où son instruction s'exécute :
import { knex, type Knex } from 'knex';import { createKnexUnitOfWork, KnexContext } from '@ddd-ts-kit/knex';
declare const config: { readonly databaseUrl: string };
interface InvoiceRow {  id: string;  status: 'draft' | 'issued';}
// Au lieu de `issue(id: string, transaction: Knex.Transaction)`, transmis depuis le gestionnaire :export class KnexInvoiceIssuer {  constructor(private readonly context: KnexContext) {}
  async issue(id: string): Promise<void> {    await invoicesOf(this.context).where({ id }).update({ status: 'issued' });  }}
function invoicesOf(context: KnexContext): Knex.QueryBuilder<InvoiceRow, InvoiceRow[]> {  return context.executor()<InvoiceRow, InvoiceRow[]>('invoices').withSchema('billing_core');}
const db = knex({ client: 'pg', connection: config.databaseUrl });const unitOfWork = createKnexUnitOfWork(db);const issuer = new KnexInvoiceIssuer(unitOfWork); // l'unité de travail est aussi le KnexContext
// Les deux mises à jour s'exécutent dans la transaction ouverte par `run` : elles sont validées, ou annulées, ensemble.await unitOfWork.run(async () => {  await issuer.issue('inv-1');  await issuer.issue('inv-2');});
// Hors de `run`, `executor()` renvoie `db` : la mise à jour s'exécute seule.await issuer.issue('inv-3');
Dans une application, le bus de commandes appelle run pour vous, et les consommateurs de
@ddd-ts-kit/di aussi : un gestionnaire ne le voit donc jamais ; un script, ou un consommateur
câblé à la main, l'appelle lui-même. Avec la CLI, init --orm knex écrit ce câblage ; voir
Racine de composition.
Le projet consommateur possède ses migrations. createOutboxTables est un helper à appeler
depuis l'une d'elles :
import type { Knex } from 'knex';import { createOutboxTables, dropOutboxTables } from '@ddd-ts-kit/knex';
export const up = (knex: Knex) => createOutboxTables(knex, { schema: 'messaging' });export const down = (knex: Knex) => dropOutboxTables(knex, { schema: 'messaging' });
Sans schema, les tables vivent dans le schéma par défaut de la connexion. outboxTable et
processedEventsTable les renomment. Si vous préférez ne pas appeler une bibliothèque depuis une
migration, voici l'équivalent sur PostgreSQL :
export async function up(knex: Knex): Promise<void> {  await knex.raw(`    create schema if not exists "messaging";
    create table "messaging"."outbox" (      "id" varchar(191) primary key,      "sequence" bigserial,      "type" text not null,      "version" integer not null,      "occurred_at" text not null,      "payload" jsonb,      "traceparent" text,      "correlation_id" text,      "status" varchar(16) not null default 'pending',      "attempts" integer not null default 0,      "next_attempt_at" timestamptz(3) not null,      "last_error_code" text,      "published_at" timestamptz(3),      "created_at" timestamptz(3) not null default current_timestamp(3)    );    create index "outbox_pending_idx" on "messaging"."outbox" ("next_attempt_at", "sequence")      where status = 'pending';
    create table "messaging"."processed_events" (      "consumer" varchar(191) not null,      "event_id" varchar(191) not null,      "processed_at" timestamptz(3) not null default current_timestamp(3),      primary key ("consumer", "event_id")    );  `);}
outbox est indexée pour le relais (les enregistrements en attente par prochaine tentative,
index partiel) ; processed_events a (consumer, event_id) pour clé primaire. occurred_at est
du texte à dessein : l'enveloppe revient exactement telle qu'elle a été publiée, décalage horaire
compris.
Un projet multitenant garde le tenant de chaque événement, pour que ses consommateurs
s'exécutent dans ce tenant : createOutboxTables(knex, { schema: 'messaging', tenant: true })
ajoute une colonne tenant_id nullable
(addOutboxTenantColumn(knex, { schema: 'messaging', tenantOfUnpublished: 'acme' }) est la
migration d'un projet qui devient multitenant : les événements pas encore publiés vont au tenant
que la base servait, ou n'en gardent aucun et sont refusés par les consommateurs restreints à un
tenant si on l'omet), et
new KnexOutboxStore(context, { schema: 'messaging', tenant: true }) l'écrit. Une table qui a la
colonne est relue dans les deux cas.
Une colonne jsonb du projet prend jsonColumn(value) : pg écrit un tableau JavaScript comme un littéral de
tableau PostgreSQL et une chaîne telle quelle, donc une liste ou une chaîne échoue avec 22P02 là où Drizzle,
Prisma et TypeORM la sérialisent. jsonColumn répond le texte JSON de n'importe quelle valeur (un objet, une
liste, une chaîne ; null pour une valeur absente), si bien que la ligne de mapper
details: jsonColumn(state.details) donne le même résultat sur les quatre ORM.
Un schéma par contexte délimité : schemaNameOf('order-management') donne order_management, à
passer à knex.schema.createSchemaIfNotExists, à knex.schema.withSchema et à
.withSchema(...) sur les requêtes SQL. Les contextes ne font jamais de jointure sur les tables
des autres.
Racine de composition
Section intitulée « Racine de composition »createKnexUnitOfWork(db) donne un objet qui est deux ports : le UnitOfWork du noyau, et
KnexContext, la poignée sur laquelle les repositories et les stores exécutent leurs requêtes
SQL. Liez-le aux deux :
import knex from 'knex';import { defineContextModule } from '@ddd-ts-kit/di';import { IntegrationEventPublisher, ProcessedEventStore, UnitOfWork } from '@ddd-ts-kit/kernel';import { OutboxPublisher, OutboxStore } from '@ddd-ts-kit/events';import {  createKnexUnitOfWork,  KnexContext,  KnexOutboxStore,  KnexProcessedEventStore,} from '@ddd-ts-kit/knex';
declare const config: { readonly databaseUrl: string }; // la configuration de la plateforme
const db = knex({ client: 'pg', connection: config.databaseUrl });const unitOfWork = createKnexUnitOfWork(db);
export const persistenceModule = defineContextModule({ name: 'persistence', register(builder) { builder.rebind(UnitOfWork).toValue(unitOfWork); builder.bind(KnexContext).toValue(unitOfWork); builder.bind(OutboxStore).toClass(KnexOutboxStore, [KnexContext]); builder.rebind(ProcessedEventStore).toClass(KnexProcessedEventStore, [KnexContext]); builder.rebind(IntegrationEventPublisher).toClass(OutboxPublisher, [OutboxStore]); },});const app = createApplication({ modules: [kernelModule(), persistenceModule, contextModule('billing', billingDeclarations)] });Listez le module après kernelModule() : rebind remplace ses valeurs par défaut en mémoire. Le
bus de commandes du module du noyau exécute chaque commande dans le UnitOfWork lié ; les
gestionnaires ne le savent pas. contextModule de @ddd-ts-kit/di transforme les classes
déclarées d'un contexte en son module.
Un projet écrit par la CLI tient le même câblage en deux fichiers :
platform/database/persistence-over.ts construit une fois l'unité de travail et ses stores, et
platform/composition/platform.module.ts les lie, le publisher de l'outbox étant donné à
kernelModule({ eventPublisher }).
toClass construit les stores avec leurs options par défaut (les tables outbox et
processed_events dans le schéma par défaut de la connexion). Un store avec des options est
construit par une fabrique (factory) :
builder .bind(OutboxStore) .toFactory((resolve) => new KnexOutboxStore(resolve(KnexContext), { schema: 'messaging' }));builder .rebind(ProcessedEventStore) .toFactory((resolve) => new KnexProcessedEventStore(resolve(KnexContext), { schema: 'messaging' }));Le relais lit le même store et remet les enregistrements au broker :
const relay = new OutboxRelay({ store: app.resolve(OutboxStore), publisher: broker, clock: app.resolve(Clock) });relay.start({ intervalMs: 500 });unitOfWork.run(work) ouvre knex.transaction et garde la transaction dans un
AsyncLocalStorage ; un run imbriqué rejoint la transaction englobante (pas de point de
sauvegarde). Comme append utilise la transaction courante, un événement publié par un
gestionnaire qui échoue ensuite est annulé avec l'écriture métier : c'est toute la raison d'être
de l'outbox. createKnexUnitOfWork(db, { isolationLevel: 'repeatable read' }) transmet la
configuration de transaction de knex.
run repose sur withinUnitOfWork du noyau. Les événements du domaine des agrégats sauvegardés
à l'intérieur attendent que work ait rendu la main, puis sont distribués dans la transaction,
avant la validation (commit) : leurs gestionnaires voient chaque sauvegarde, et ce qu'ils
écrivent est validé ou annulé avec elle. Si work, un gestionnaire ou la validation échoue, il
ne reste rien : aucune ligne, aucun enregistrement d'outbox, aucun gestionnaire exécuté après la
validation. Les gestionnaires déclarés after-commit s'exécutent une fois la transaction
validée. Un run imbriqué rejoint l'unité de travail en cours : une seule distribution, à la fin
du plus externe. Un run appelé directement (un consommateur, un script) a le même déroulement
qu'une commande. unitOfWorkContract de @ddd-ts-kit/testing/contracts le prouve, avec une
contrainte différée pour la validation qui échoue ; sur un vrai PostgreSQL
(DDD_TS_KIT_TEST_DATABASE_URL), il prouve aussi que les lignes d'un gestionnaire
before-commit sont invisibles depuis une autre connexion et visibles des gestionnaires
after-commit.
KnexContext est une classe abstraite : elle est donc son propre jeton d'injection. Un projet
à deux bases de données donne à chacune sa propre classe
(export abstract class Ledger extends KnexContext {} dans platform/database/) et lie chacune
à son unité de travail.
Repository
Section intitulée « Repository »Le port vit dans le domaine, l'adaptateur dans l'infrastructure. Un repository reçoit le
contexte, jamais une transaction : executor() est la transaction de l'unité de travail quand
il y en a une, et l'instance knex racine sinon.
import { Repository } from '@ddd-ts-kit/kernel';
export abstract class InvoiceRepository extends Repository<Invoice> {}import type { Knex } from 'knex';import { AggregateRoot } from '@ddd-ts-kit/kernel';import { Repository } from '@ddd-ts-kit/kernel/declarations';import { insertIgnoringConflict, KnexContext, optimisticUpdate, schemaNameOf } from '@ddd-ts-kit/knex';
const BILLING = schemaNameOf('billing-core'); // billing_core
interface InvoiceRow { id: string; amount: number; status: 'draft' | 'issued'; version: number;}
// Ce que tient le domaine du contexte, déclaré pour que ce fichier se lise seul.type InvoiceState = Omit<InvoiceRow, 'version'>;
declare class Invoice extends AggregateRoot { static rehydrate(state: InvoiceState): Invoice; readonly state: InvoiceState;}
declare abstract class InvoiceRepository { abstract findById(id: string): Promise<Invoice | undefined>; abstract save(invoice: Invoice): Promise<void>;}
@Repository(InvoiceRepository)export class KnexInvoiceRepository implements InvoiceRepository { constructor(private readonly context: KnexContext) {}
async findById(id: string): Promise<Invoice | undefined> { const row = await invoicesOf(this.context).where({ id }).first();
if (row === undefined) { return undefined; }
const invoice = Invoice.rehydrate(row); invoice.version = row.version;
return invoice; }
async save(invoice: Invoice): Promise<void> { await optimisticUpdate(invoice, async ({ expected, next }) => { const row = { ...invoice.state, version: next };
if (expected === 0) { const inserted = await insertIgnoringConflict(this.context.executor(), invoicesOf(this.context), { row, conflict: 'id' });
return inserted ? 1 : 0; }
return invoicesOf(this.context).where({ id: invoice.id, version: expected }).update(row); }); }}
// Une fonction, pas une méthode : voir plus bas.function invoicesOf(context: KnexContext): Knex.QueryBuilder<InvoiceRow, InvoiceRow[]> { return context.executor()<InvoiceRow, InvoiceRow[]>('invoices').withSchema(BILLING);}Aucune méthode d'un adaptateur ne renvoie un query builder. Un builder knex est
« thenable », et ce qui enveloppe un adaptateur de l'extérieur (les spans de
@ddd-ts-kit/tracing, un aspect) prend une méthode qui a renvoyé un thenable pour une méthode
asynchrone : dès son deuxième appel, la méthode renvoie une promesse des lignes, et .where(...)
sur celle-ci échoue. La table est donc atteinte par une fonction du module, comme le fait le
repository que génère la CLI, et une méthode privée qui exécute une instruction est déclarée
async :
import type { Knex } from 'knex';import { KnexContext } from '@ddd-ts-kit/knex';
interface InvoiceRow {  id: string;  amount: number;}
// Au lieu d'une méthode qui renvoie le builder : une fois qu'un span enveloppe l'adaptateur, le// deuxième appel de `invoices()` renvoie une promesse des lignes, et `.where(...)` sur celle-ci lève une erreur.export class FragileInvoiceTotals {  constructor(private readonly context: KnexContext) {}
  async totalOf(id: string): Promise<number | undefined> {    return (await this.invoices().where({ id }).first())?.amount;  }
  private invoices(): Knex.QueryBuilder<InvoiceRow, InvoiceRow[]> {    return this.context.executor()<InvoiceRow, InvoiceRow[]>('invoices');  }}
// Écrivez : la table est atteinte par une fonction du module, et chaque méthode est async.export class KnexInvoiceTotals {  constructor(private readonly context: KnexContext) {}
  async totalOf(id: string): Promise<number | undefined> {    return (await invoicesOf(this.context).where({ id }).first())?.amount;  }}
function invoicesOf(context: KnexContext): Knex.QueryBuilder<InvoiceRow, InvoiceRow[]> {  return context.executor()<InvoiceRow, InvoiceRow[]>('invoices');}
Dans le style explicite, sans le décorateur, la même liaison tient en une ligne de
<context>.module.ts :
builder.bind(InvoiceRepository).toClass(KnexInvoiceRepository, [KnexContext]).
optimisticUpdate donne la version à attendre et la version à écrire, lève une
ConcurrencyError (une DomainError de code CONCURRENCY_CONFLICT) quand l'instruction gardée
n'a écrit aucune ligne, et fait avancer invoice.version sinon. insertIgnoringConflict insère
sauf si la clé existe, et dit s'il l'a fait ; contrairement à une violation d'unicité attrapée, il
laisse utilisable la transaction PostgreSQL englobante, et il cache le seul endroit où les
dialectes diffèrent (RETURNING sur PostgreSQL et SQLite, le nombre de lignes affectées sur
MySQL). Il n'ignore qu'un conflit sur conflict (l'id) : une ligne qui prend une valeur qu'une
autre ligne détient sous une contrainte d'unicité (un e-mail) est refusée par la base, et
optimisticUpdate lève UniqueViolationError (code CONFLICT, 409), pas une mise à jour
perdue ; sur MySQL, qui n'a pas de cible de conflit et dont INSERT IGNORE écarte aussi cette ligne, l'utilitaire demande si une ligne détient la clé quand rien n'a été écrit, et lève UniqueViolationError quand aucune ne la détient. Deux premiers enregistrements d'un même agrégat faits en même temps (une requête livrée deux fois) ne sont pas refusés pour la valeur unique qu'ils écrivent tous les deux : sur PostgreSQL, une cible de conflit sur la clé seule les laisse se rencontrer d'abord sur l'autre index unique, si bien que l'utilitaire insère par une instruction qui passe sur toute valeur unique, et seulement quand elle n'a rien écrit par une seconde qui nomme la clé. Celui qui a perdu n'écrit aucune ligne, une ConcurrencyError.
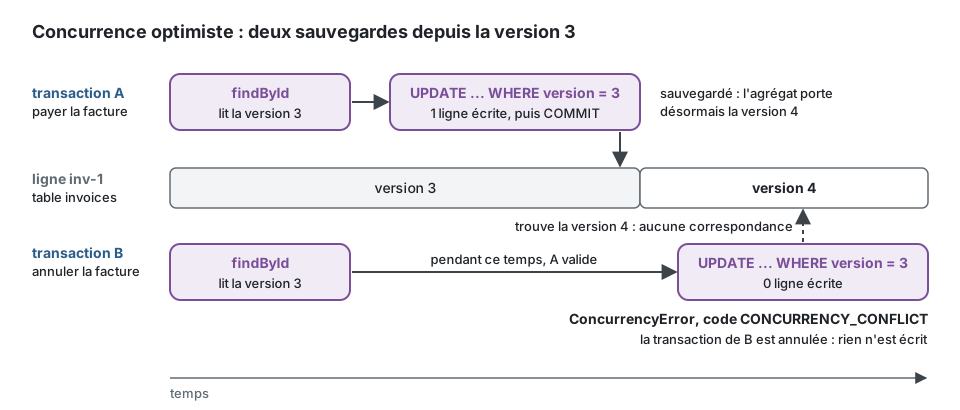
Le second écrivain est refusé au lieu d'écraser le premier en silence. Rien ne le retente pour
vous : l'appelant reçoit la ConcurrencyError et décide s'il recharge la facture.
Un verrou sur une clé métier
Section intitulée « Un verrou sur une clé métier »La concurrence optimiste protège une ligne qui existe. Une décision prise sur des lignes qui
n'existent pas encore (compter les réservations d'un créneau puis en insérer une, donner le
numéro suivant d'une séquence par tenant) n'a pas de version à comparer : deux unités de travail
lisent le même compte et écrivent toutes les deux. advisoryLock(context, key, { tenant }) les
met en file : il attend qu'aucune autre transaction ne tienne le verrou sur key, puis le tient
jusqu'à ce que l'unité de travail valide ou annule (pg_advisory_xact_lock). Rien ne le relâche
à la main.
import { advisoryLock } from '@ddd-ts-kit/knex';
async next(): Promise<number> {  // First in the unit of work, before the read it protects.  await advisoryLock(this.context, 'invoice-number', { tenant: this.scope });
return (await this.lastNumber()) + 1;}- La clé est un texte, que PostgreSQL hache vers le nombre de 64 bits qu'il verrouille
(
hashtextextended(text, 0)). Avectenant, unExecutionScope, le texte esttenant:<id>:<key>(tenantKeydu kernel) : deux tenants ne s'attendent jamais, et un travail qui ne nomme aucun tenant est refusé. Deux textes de même hachage, environ une paire sur 2^64, s'attendent comme le ferait une seule clé : une attente, jamais une réponse fausse. - Dans une unité de travail seulement. Hors d'une unité de travail, le verrou serait relâché
à la fin de son instruction :
AdvisoryLockOutsideUnitOfWorkError. Garder l'isolation par défaut,read committed: la lecture qui suit le verrou voit alors ce que le détenteur précédent a validé, là oùrepeatable readetserializablelisent à l'instant où le verrou a été demandé. tryAdvisoryLock(context, key, { tenant })n'attend pas :truequand il a pris le verrou,falsequand une autre transaction le tient (pg_try_advisory_xact_lock).- Un cas d'usage n'importe aucun package d'ORM. Le verrou se place dans la méthode du
repository qui en a besoin, ou derrière un port du contexte (
InvoiceNumbering.reserve()) dont l'adaptateur est ce seul appel et dont le fake ne fait rien. - PostgreSQL seulement. Dans un projet multitenant,
tenancy/scoped-statementaccepte le helper et signale unpg_advisory_xact_lockécrit à la main, comme tout SQL brut. - Tenu au contrat
advisoryLockContractde@ddd-ts-kit/testing/contracts. L'attente d'une seconde unité de travail est prouvée sur un vrai serveur : PGlite est une seule session, où la seconde attend la connexion elle-même.
Colonnes d'audit, restriction au tenant et pages
Section intitulée « Colonnes d'audit, restriction au tenant et pages »Les formes de persistance standard du noyau, sur knex. Quatre petits helpers, pour que les
colonnes portent le même nom dans chaque projet (created_at, created_by, updated_at,
updated_by, tenant_id), ce qui permet d'écrire une seule fois un tableau de bord, un export
ou le package d'audit : auditColumns(table) et tenantColumn(table) pour la migration,
auditRow(stamp) et tenantRow(scoped) pour traduire l'AuditStamp et le TenantScoped du
noyau en ces noms de colonnes, puisqu'une ligne knex est indexée par colonne.
import { auditColumns, tenantColumn } from '@ddd-ts-kit/knex';
export async function up(knex: Knex): Promise<void> {  await knex.schema.withSchema(BILLING).createTable('invoices', (table) => {    table.text('id').primary();    table.integer('amount').notNullable();    table.text('status').notNullable();    table.integer('version').notNullable();    tenantColumn(table);    auditColumns(table);    table.index(['tenant_id', 'amount', 'id'], 'invoices_tenant_amount_idx');  });}
import { Clock, ExecutionScope, stampCreation, stampUpdate, tenantScopeOf } from '@ddd-ts-kit/kernel';import { auditRow, tenantRow, type AuditRow, type TenantRow } from '@ddd-ts-kit/knex';
interface InvoiceRow extends VersionedInvoice, TenantRow, AuditRow {}
@Repository(InvoiceRepository)export class KnexInvoiceRepository implements InvoiceRepository { constructor( private readonly context: KnexContext, private readonly scope: ExecutionScope, private readonly clock: Clock, ) {}
async findById(id: string): Promise<Invoice | undefined> { const row = await invoicesOf(this.context).where({ id, ...this.ownTenant() }).first();
return row === undefined ? undefined : InvoiceMapper.toDomain(row); }
async save(invoice: Invoice): Promise<void> { await optimisticUpdate(invoice, async ({ expected, next }) => { const state = { ...InvoiceMapper.toRow(invoice), version: next };
return expected === 0 ? this.insert(state) : this.update(state, expected); }); }
private async insert(state: VersionedInvoice): Promise<number> { const row = { ...state, ...this.ownTenant(), ...auditRow(stampCreation(this.scope, this.clock)) }; const inserted = await insertIgnoringConflict(this.context.executor(), invoicesOf(this.context), { row, conflict: 'id' });
return inserted ? 1 : 0; }
private async update(state: VersionedInvoice, expected: number): Promise<number> { return invoicesOf(this.context) .where({ id: state.id, version: expected, ...this.ownTenant() }) .update({ ...state, ...auditRow(stampUpdate(this.scope, this.clock)) }); }
private ownTenant(): TenantRow { return tenantRow(tenantScopeOf(this.scope)); }}Une requête de recherche prend la PageRequest du noyau et renvoie une Page, dans les deux
variantes :
export abstract class InvoiceQueries { abstract search(request: PageRequest<'amount'>): Promise<Page<InvoiceSummary>>;}import { ExecutionScope, encodeCursor, pageOf, tenantScopeOf } from '@ddd-ts-kit/kernel';import { Repository } from '@ddd-ts-kit/kernel/declarations';
@Repository(InvoiceQueries)export class KnexInvoiceQueries implements InvoiceQueries { constructor( private readonly context: KnexContext, private readonly scope: ExecutionScope, ) {}
async search(request: PageRequest<'amount'>): Promise<Page<InvoiceSummary>> { return request.kind === 'offset' ? this.byOffset(request) : this.byCursor(request); }
private async byOffset(request: OffsetPageRequest<'amount'>): Promise<Page<InvoiceSummary>> { const rows = await ownInvoices(this.context, this.scope) .orderBy(totalOrder(directionOf(request))) .limit(request.limit) .offset(request.offset); const counted = await ownInvoices(this.context, this.scope).count<{ total: string | number }[]>({ total: '*' }).first();
return pageOf(rows.map(toSummary), { total: Number(counted?.total ?? 0) }); }
private async byCursor(request: CursorPageRequest<'amount'>): Promise<Page<InvoiceSummary>> { const direction = directionOf(request); const query = ownInvoices(this.context, this.scope).orderBy(totalOrder(direction)).limit(request.limit + 1); const rows = await (request.cursor === undefined ? query : beyond(query, positionOf(request.cursor), direction)); const items = rows.slice(0, request.limit); const last = items.at(-1); const more = rows.length > request.limit && last !== undefined;
return pageOf(items.map(toSummary), more ? { nextCursor: encodeCursor({ amount: last.amount, id: last.id }) } : {}); }}
function ownInvoices(context: KnexContext, scope: ExecutionScope) { return invoicesOf(context).where(tenantRow(tenantScopeOf(scope)));}
const directionOf = (request: PageRequest<'amount'>) => request.sort[0]?.direction ?? 'asc';
// La clé primaire suit le champ de tri, dans le même sens : l'ordre est total.const totalOrder = (direction: SortDirection) => [ { column: 'amount', order: direction }, { column: 'id', order: direction },];
// Les lignes après une position, par comparaison de tuples : le départage tranche entre égaux.function beyond(query: Knex.QueryBuilder, { amount, id }: { amount: number; id: string }, direction: SortDirection) { const past = direction === 'asc' ? '>' : '<';
return query.where((after) => { void after.where('amount', past, amount).orWhere((tied) => { void tied.where('amount', amount).where('id', past, id); }); });}positionOf(cursor) décode avec decodeCursor et vérifie que amount est un nombre et id une
chaîne, et lève InvalidPageRequestError sinon.
Un adaptateur de lecture sur la base de données est déclaré avec @Repository, comme ceux que
génère la CLI : son genre est repository. Déclaré avec @Adapter, il serait external, et une
plateforme générée met une nouvelle tentative (retry) et une limite de temps autour de chaque
adaptateur external et gateway, ce qu'une instruction de l'unité de travail ne doit pas
recevoir.
Les règles que tiennent ces exemples, et que les tests de ce package vérifient sur une vraie base de données :
- Les colonnes d'audit sont remplies par l'adaptateur, jamais par l'agrégat :
stampCreation(scope, clock)à l'insertion,stampUpdate(scope, clock)à la mise à jour, qui laissecreated_atetcreated_byintactes. L'acteur est celui de la portée d'exécution : l'utilisateur de la requête HTTP, ousystem:<consumer>pour un événement consommé. - Le tenant fait partie de chaque instruction : écrit à l'insertion, et dans la condition
de chaque lecture et de chaque mise à jour, garde de version comprise. Une ligne d'un autre
tenant n'est pas trouvée, et une mise à jour qui la vise n'écrit rien, ce
qu'
optimisticUpdatesignale par uneConcurrencyError. Un travail qui ne nomme aucun tenant lèveNoCurrentTenantErroravant tout SQL. - Une liste a un ordre total. La clé primaire suit le champ de tri, dans le même sens, pour
départager : sinon, des lignes égales sur le champ de tri n'ont pas d'ordre défini, et une page
pourrait répéter ou sauter l'une d'elles. L'index couvre
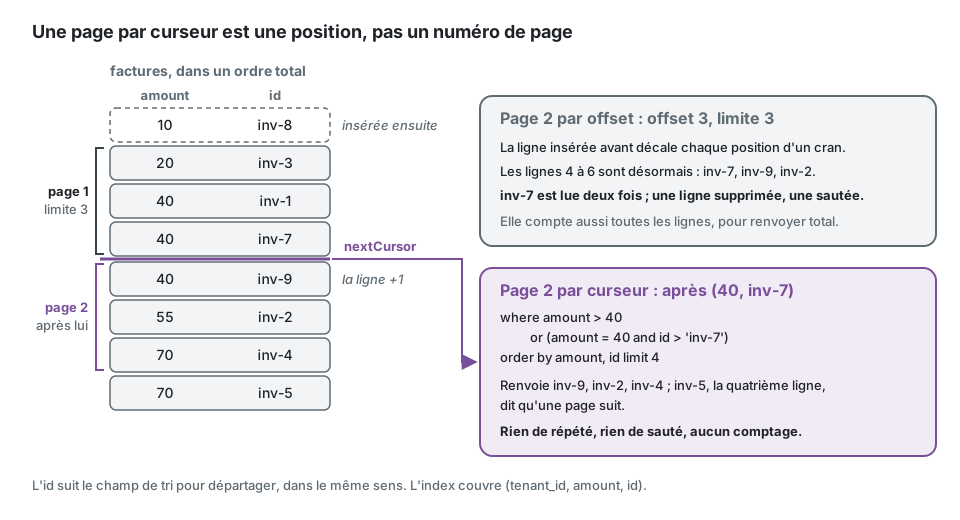
(tenant_id, <sort field>, id). - Un curseur est une position, pas un numéro de page : la valeur de tri et l'id de la
dernière ligne, écrits par
encodeCursor, comparés comme un tuple (amount > :amount OR (amount = :amount AND id > :id)). Une ligne de plus quelimitest lue pour savoir si une page suit, donc aucun comptage n'est nécessaire, et une ligne insérée avant le curseur ne décale pas la page suivante comme elle le fait avec un offset. Un curseur revient d'un client :decodeCursorrefuse ce qu'il n'a pas écrit, et l'adaptateur vérifie les types de la position avant qu'ils n'atteignent une instruction. - Une page par offset renvoie
total, une page par curseurnextCursor. Proposez la forme par offset pour les petites listes que l'on parcourt, et la forme par curseur pour tout ce qui grandit.
Ce que le curseur apporte, sur des factures triées par montant, quand une ligne est insérée entre deux pages :
Isolation des tenants
Section intitulée « Isolation des tenants »Quatre stratégies, choisies par projet (Multitenance
dit quand chacune convient). Chacune est prouvée ici par tenantIsolationContract de
@ddd-ts-kit/testing/contracts, sur PGlite et sur PostgreSQL.
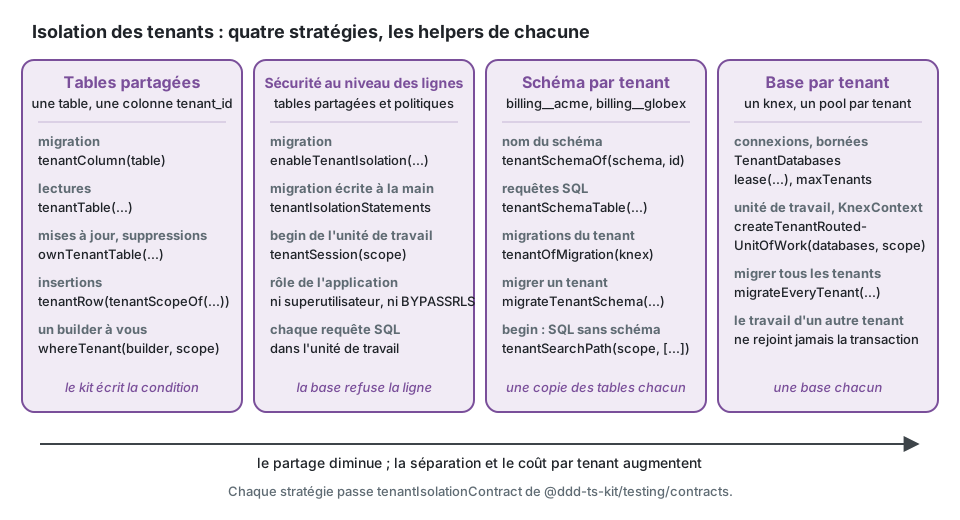
Tables partagées. Une table par agrégat, une colonne tenant_id, et chaque instruction
restreinte par le kit plutôt que par une condition écrite à la main :
const INVOICES = { schema: BILLING, table: 'invoices' };
// lectures : le tenant du travail, ou les tenants d'une élévationconst row = await tenantTable<InvoiceRow>(this.context, this.scope, INVOICES).where({ id }).first();// mises à jour et suppressions : le seul tenant du travail, qu'une élévation n'élargit jamaisawait ownTenantTable<InvoiceRow>(this.context, this.scope, INVOICES).where({ id, version: expected }).update(changes);// les insertions nomment elles-mêmes le tenantconst inserted = { ...state, ...tenantRow(tenantScopeOf(this.scope)), ...auditRow(stampCreation(this.scope, this.clock)) };
whereTenant(builder, scope) est la condition seule, pour un builder à vous. Un travail qui ne
nomme aucun tenant lève NoCurrentTenantError avant tout SQL. Les trois gardent la condition en
and avec le reste de l'instruction : SQL lie and avant or, donc .orWhere* et .or au sommet
de leur builder lèvent UngroupedOrError et les alternatives vont dans un groupe,
.where((either) => either.where(a).orWhere(b)) ; le texte d'un whereRaw, ou un knex.raw donné
à un where, reste entre parenthèses comme un seul terme, avec ses paramètres ; clearWhere() et
clear('where') lèvent ClearedTenantConditionError. Un orHaving s'applique après le where et
reste libre. Un modèle de lecture de données
d'un tenant passe tenant: scope à KnexReadModelTable et à KnexReadModelStore : chaque
ligne est écrite avec le tenant du travail, et chaque lecture et chaque écriture y est
restreinte (les clés restent uniques entre tenants ; une reconstruction, qui ne s'exécute dans
aucun tenant, est refusée).
Une mesure groupée par une requête restreinte au tenant, puis filtrée, triée et paginée sur ses
colonnes de sortie, la sélectionne avec derivedTable(context, grouped, 'occupancy') : la requête
groupée est celle qui atteint la table, par tenantTable. Un projet d'un seul client qui devient
multitenant ajoute la colonne à chaque table de données de tenant dans une migration,
addTenantColumn(knex, { schema, table, tenantOfExistingRows: 'acme' }) : les lignes déjà
présentes vont à ce tenant (refusé quand il y a des lignes et aucun tenant), puis la colonne
devient obligatoire et indexée ; une table qui l'a déjà est laissée telle quelle.
Sécurité au niveau des lignes (row-level security), une seconde ligne de défense sur les tables partagées : la base de données elle-même refuse une ligne d'un autre tenant, même à une instruction qui a oublié sa condition.
// la migration qui crée la tableawait enableTenantIsolation(knex, INVOICES); // active, force sur le propriétaire, une politique par commande SQL
// la racine de compositionconst unitOfWork = createKnexUnitOfWork(knex, undefined, { begin: tenantSession(executionScope) });
tenantSession pose les réglages du tenant pour chaque transaction seulement
(set_config(..., true)), si bien qu'une connexion d'un pool n'emporte jamais un tenant dans
la suivante : ddd_ts_kit.tenant_id et, pour une élévation, ddd_ts_kit.reach (les tenants
listés) ou ddd_ts_kit.every_tenant. Il y a une politique par commande SQL : un select voit le
tenant du travail et ce qu'atteint une élévation ; un insert, un update et un delete ne
touchent jamais que le tenant du travail, si bien qu'un delete from invoices élevé sans
condition ne supprime aucune ligne d'un autre tenant. tenantIsolationStatements(target) donne
le SQL pour une migration écrite à la main. Trois conditions la tiennent : l'application se
connecte avec un rôle qui n'est pas superutilisateur et n'a pas BYPASSRLS (l'un comme
l'autre ignorent toute politique) ; chaque instruction s'exécute dans l'unité de travail (une
instruction hors transaction ne porte aucun réglage et ne voit rien, donc les requêtes passent
elles aussi par l'unité de travail) ; les migrations s'exécutent en tant que propriétaire, hors
de celle-ci.
Un schéma par tenant. Les tables d'un contexte existent une fois par tenant, dans
<schema>__<tenant> (tenantSchemaOf('billing', 'acme') ; un identifiant de tenant qu'un nom
de schéma ne pourrait pas contenir tel quel est refusé plutôt que modifié).
tenantSchemaTable(context, scope, { schema: BILLING, table: 'invoices' }) atteint la copie du
tenant. Les migrations des tenants vivent dans un répertoire à part et nomment leur schéma
d'après le tenant pour lequel elles s'exécutent :
export async function up(knex: Knex): Promise<void> {  const schema = tenantSchemaOf(BILLING, tenantOfMigration(knex));
  await knex.schema.createSchemaIfNotExists(schema);  await knex.schema.withSchema(schema).createTable('invoices', (table) => { /* ... */ });}
migrateTenantSchema(knex, tenantId, { directory: 'migrations/tenant' }) les applique pour un
tenant et les enregistre dans migrations__<tenant> : chaque tenant avance à son rythme, et
un nouveau tenant est provisionné par sa première exécution. tenantSearchPath(scope, [BILLING])
est un begin qui fixe le chemin de recherche de chaque transaction aux seuls schémas du
tenant, pour le SQL qui ne nomme aucun schéma. Une élévation n'atteint pas plusieurs schémas à
la fois : l'équipe de la plateforme lit un tenant à la fois.
Une base par tenant. new TenantDatabases({ connectionOf: (tenantId) => configOf(tenantId), maxTenants: 20 }) ouvre un knex (un pool borné) par tenant à la première utilisation. Au
plus maxTenants instances existent à la fois, celles en cours de fermeture comprises, si bien
que le serveur n'a jamais à accepter plus de maxTenants * pool.max connexions par instance de
l'application. Un travail tient l'instance de son tenant par un bail
(databases.lease(tenantId, (knex) => ...)) : une instance n'est fermée que lorsqu'aucun travail
ne la tient, la moins récemment utilisée d'abord, et un travail pour un autre tenant attend une
place au lieu d'ouvrir au-delà de la borne. createTenantRoutedUnitOfWork(databases, scope) est
l'unité de travail et le KnexContext : chaque transaction tient un bail sur la base du tenant
du travail jusqu'à sa fin ; chaque instruction s'exécute à l'intérieur
(StatementOutsideUnitOfWorkError sinon, donc les requêtes passent elles aussi par l'unité de
travail), un travail qui ne nomme aucun tenant n'atteint aucune base, et le travail d'un autre
tenant ne rejoint jamais une transaction ouverte (CrossTenantUnitOfWorkError).
migrateEveryTenant(databases, directory, migrate) applique les migrations à chaque tenant
d'un TenantDirectory, s'arrête au premier échec et nomme son tenant.
Critères
Section intitulée « Critères »criteriaToKnex(builder, plan, columns) ajoute à une requête SQL un plan de critères du noyau :
les filtres et le périmètre de l'acteur, le jeu de clés (keyset) d'une page par curseur, l'ordre
total terminé par le départage, la fenêtre. predicateToKnex(builder, predicate, columns) ajoute
les filtres seuls, pour un comptage. columns associe chaque champ du modèle de lecture à sa
colonne, et c'est la seule source d'identifiants : chaque valeur est un paramètre lié, et une
recherche textuelle est like ? escape ?, avec %, _ et \ échappés. containsIgnoringCase et startsWithIgnoringCase sont la même recherche en ILIKE, que PostgreSQL replie avec la locale de la base (la règle et ses limites sont dans le README du kernel, « Ce que signifient des critères ») ; aucun index b-tree ne la sert, un index GIN de pg_trgm sur la colonne le fait.
async search(criteria: ScopedCriteria<AppointmentRow>): Promise<Page<AppointmentRow>> {  const plan = planCriteria(appointmentCriteria, criteria);
  if (plan.empty) {    return pageOfPlan(plan, []);  }
  const rows = await criteriaToKnex(this.context.executor()<AppointmentRow>('appointment_list'), plan, COLUMNS);
  return pageOfPlan(plan, rows.map(toRow));}
Une page par curseur est lue avec une ligne de plus que demandé : c'est ainsi que pageOfPlan
sait si une autre suit ; une page par offset tire son total d'une seconde instruction
(predicateToKnex(...).count()). Un champ déclaré nullable est trié nulls last en ordre
croissant et nulls first en ordre décroissant, sur tous les dialectes.
Chaînes. Une colonne de texte est triée et comparée par plage selon la collation de la
colonne ; les critères trient les chaînes par point de code. Déclarez avec COLLATE "C" les
colonnes de texte qui sont triées ou comparées avec gt, lt ou between : l'index sert alors
le tri, et l'ordre est le même que dans le fake. Les décimaux sont une colonne numeric et
une chaîne dans la ligne ; ils sont relus à l'échelle de la colonne. Les instants sont des
timestamptz et une Date. Un entier est un integer : un bigint revient du pilote sous forme
de chaîne.
Modèles de lecture
Section intitulée « Modèles de lecture »// la migrationawait knex.schema.withSchema('scheduling').createTable('appointment_list', (table) => { table.text('id').primary(); table.text('status').nullable(); // NULL dans une ligne supprimée, comme chaque colonne de la ligne table.datetime('starts_at', { useTz: true, precision: 3 }).nullable(); readModelColumns(table); // last_event_id, last_event_at, last_event_version, deleted table.check('deleted or (status is not null and starts_at is not null)', [], 'appointment_list_live_rows_whole');});
// infrastructure/persistence/knex-appointment-list.repository.ts@Repository(AppointmentList)export class KnexAppointmentList extends KnexReadModelStore<AppointmentRow> implements AppointmentList { constructor(context: KnexContext) { super(context, { schema: 'scheduling', table: 'appointment_list', columns: { id: 'id', status: 'status', startsAt: 'starts_at' }, definition: appointmentCriteria, }); }}Chaque écriture passe par le TableReadModelStore du noyau : une ligne n'est écrite que si son
événement est plus récent que celui qu'elle détient, sur l'exécuteur de l'unité de travail, si
bien que la ligne et la marque d'événement traité sont validées ensemble. Une ligne supprimée
reste dans la table comme une trace, avec deleted positionné : sa clé et son tampon, et NULL
dans toutes les autres colonnes, ce pour quoi chaque colonne de la ligne accepte NULL. La
suppression d'une clé que la table ne tient pas encore laisse la même trace. Une contrainte de
vérification garde entières les lignes vivantes (check (deleted or (status is not null and starts_at is not null))), une requête à vous sur la table écarte les lignes supprimées
(deleted = false), et une table dont des colonnes refusent NULL est refusée par
ReadModelTableNotReadyError avant l'écriture de la première trace, par une lecture des colonnes de la table
(Ce que laisse une ligne supprimée). Une application n'attend pas cette première trace : tableState() d'un KnexReadModelStore lit sa table comme le registre le fait avant sa première trace, pour les colonnes qu'il associe et aucune autre, et ReadModelTables du noyau le demande à chaque registre que l'application liste, puis refuse avec ReadModelTablesNotReadyError, qui nomme chaque table qui n'est pas prête, ce qui l'en empêche et la migration à écrire en deux étapes, ainsi que chaque table qu'il n'a pas pu lire ; un projet généré garde la liste, vérifie à son démarrage les tables des contextes qu'il héberge, et npm run db:read-models la vérifie avant un déploiement (Chaque table vérifiée au démarrage, et avant un déploiement). store.table est ce que prend
ProjectionRebuild ; la reconstruction est réservée à PostgreSQL (une copie <table>__rebuild
faite par LIKE ... INCLUDING ALL, les clés écrites entre-temps dans <table>__touched,
l'échange par renommage dans une seule transaction), et ses garanties et ses limites sont dans le
README de @ddd-ts-kit/kernel (« Reconstruction »). Le store passe criteriaContract et
readModelStoreContract de @ddd-ts-kit/testing/contracts, sur PGlite et sur PostgreSQL 18.
Les critères et les modèles de lecture n'ont jamais été exécutés sur MySQL ni sur SQLite.
Effacement des données personnelles
Section intitulée « Effacement des données personnelles »L'effacement d'une personne concernée des tables d'un contexte, à partir des déclarations
personalFields écrites à côté de ses mappers (@ddd-ts-kit/kernel, « Données personnelles ») :
KnexPersonalDataErasure implémente le port PersonalDataErasure sur l'exécuteur de l'unité de travail. Le port du contexte étend celui du
kernel, et son adaptateur étend cette classe.
export const personPersonalFields = personalFields<PersonRow, TenantTableTarget>(PERSONS, {  subject: 'id',  fields: ['display_name', 'email'],  erasure: 'row',});
// application/ports/identity-erasure.port.tsexport abstract class IdentityErasure extends PersonalDataErasure {}
// infrastructure/persistence/knex-identity-erasure.repository.ts@Repository(IdentityErasure)export class KnexIdentityErasure extends KnexPersonalDataErasure implements IdentityErasure {  constructor(database: KnexContext, scope: ExecutionScope, files: FileStorage) {    super(database, { name: 'identity.persons', declarations: [personPersonalFields], tenant: scope, files });  }}
erase(subject) supprime d'abord du stockage les fichiers que les lignes nomment, puis supprime les
lignes de la personne (row) ou les pseudonymise (pseudonymise : une colonne texte lit [erased],
une colonne de tout autre type ne lit rien, une colonne de fichier rien), et répond combien de lignes
il a atteintes, aucune la seconde fois. Avec tenant, chaque instruction est confinée au tenant du
travail et jamais élargie par une élévation (tenant_id, ou la column de la cible) ; sans lui, la table tient les lignes de tous
les tenants. Un sujet qui n'est pas un identifiant opaque est refusé avant toute instruction, et une
déclaration qui nomme des colonnes de fichier sans stockage de fichiers est refusée à la construction
de l'adaptateur. Les types des colonnes sont lus une fois dans la base (columnInfo), pour qu'un texte et un nombre soient pseudonymisés chacun à sa façon. Une colonne personnelle qui n'est pas un texte doit accepter null, sinon
les lignes s'effacent avec row : une déclaration qui en pseudonymiserait une qui ne l'accepte pas
est refusée avant qu'un fichier ou une ligne ne soit touché (NotNullablePersonalColumnError). L'adaptateur passe personalDataErasureContract de
@ddd-ts-kit/testing, comme celui en mémoire, sur PGlite et PostgreSQL. Ce qu'un effacement
n'atteint pas, et la chaîne entière (eraseDataSubject : la clé, chaque copie dans chaque tenant,
les reconstructions), sont dans le README du kernel (« Données personnelles »).
KnexPersonalDataExport répond au droit d'accès et à la portabilité à partir des mêmes déclarations :
exportOf(subject) remet un PersonalDataRecord par ligne sur la personne dans chaque table déclarée,
sous <name>.<table>, avec chaque colonne personnelle et chaque colonne de fichier (par sa clé) en
données simples, par leurs noms SQL, aucune autre colonne et rien de personne d'autre ; une ligne déjà
pseudonymisée répond ce qu'elle lit. La même option tenant confine chaque instruction au tenant du
travail, un sujet qui n'est pas un identifiant opaque est refusé avant toute instruction, et
l'adaptateur passe personalDataExportContract. Le port du contexte étend PersonalDataExport du
kernel et son adaptateur étend cette classe avec name, declarations et tenant
(KnexPersonalDataExportOptions) ; generate repository --personal écrit les deux adaptateurs, et
exportDataSubject du kernel rassemble chaque export en un document daté. Enveloppez l'adaptateur
avec auditedPersonalDataExport de @ddd-ts-kit/audit là où il est lié, pour que chaque remise
laisse une entrée.
Les mêmes déclarations donnent la limitation de la conservation (RGPD, article 5(1)(e)) : une
déclaration avec retention: { after: 'ended_at', months: 36 } dit combien de temps ses lignes gardent
la personne, compté depuis une colonne de date de la ligne, et purgeExpired(now) de l'adaptateur
d'effacement efface, comme la déclaration le dit, les lignes dont la date est plus ancienne que la
période ; une ligne dont la date est vide n'expire jamais, et un second passage n'atteint rien. Il
se confine au tenant du travail quand le travail en nomme un, et atteint chaque tenant quand il
n'en nomme aucun, comme le fait le job de nuit de la plateforme : un tenant oublié dans une liste
garderait ce qu'il ne doit pas. L'adaptateur implémente PersonalDataRetention du kernel et passe
personalDataRetentionContract ; purgeExpiredPersonalData du kernel lance chaque copie, et
auditedPersonalDataRetention de @ddd-ts-kit/audit enregistre chaque purge.
Outbox et idempotence
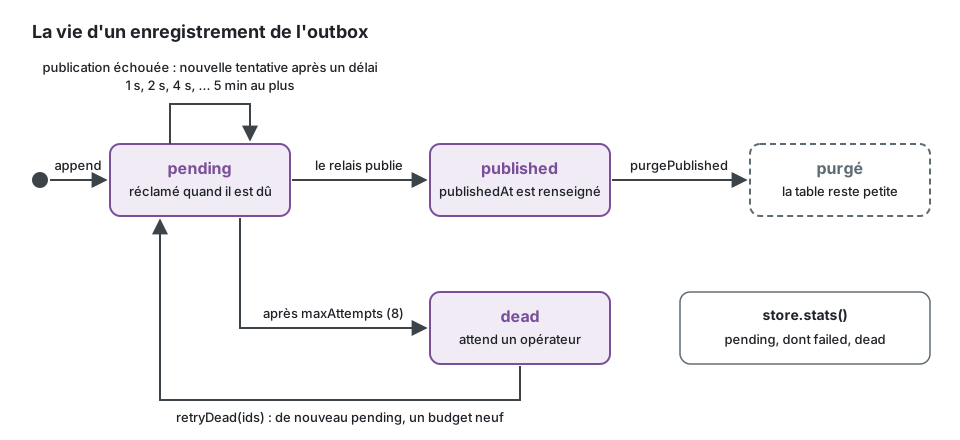
Section intitulée « Outbox et idempotence »KnexOutboxStore.claimBatchsélectionne les lignes duesFOR UPDATE SKIP LOCKEDet les réserve par un bail dans la même transaction courte en repoussantnext_attempt_at(leaseMs, 30 s par défaut) : plusieurs relais se partagent le travail sans s'attendre, et les enregistrements d'un relais mort reviennent quand le bail expire. La livraison se fait au moins une fois, sans ordre.- Là où la base de données n'a pas de
SKIP LOCKED(SQLite), ou quand vous passezclaim: 'compare-and-set', la réservation lit les lignes dues et prend chacune par une mise à jour gardée par le nombre de tentatives qu'elle a lu : même garantie, aucune clause de verrou, une instruction par enregistrement. La valeur par défaut estskip-lockedsur PostgreSQL et MySQL,compare-and-setailleurs. KnexProcessedEventStore.markProcessedest une insertion qui ignore le conflit sur(consumer, event_id). Exécutez le consommateur dans l'unité de travail : la marque est alors validée avec les effets du gestionnaire, et disparaît avec eux s'il échoue.
La vie d'un enregistrement dans la table outbox. Le relais de @ddd-ts-kit/events le conduit
par claimBatch, markPublished et markFailed ; retryDead, purgePublished et stats sont
appelés par un opérateur ou par un job planifié, jamais par le relais :
Event store
Section intitulée « Event store »// une migration du projetexport const up = (knex) => createEventStoreTables(knex, { schema: 'scheduling' });
// la racine de compositionconst { events, snapshots, checkpoints, subjectKeys } = createKnexEventSourcing(unitOfWork, { schema: 'scheduling' });createEventStoreTables exécute eventStoreTablesSql du noyau : stored_events,
stored_events_head, stream_snapshots, subscription_checkpoints et subject_keys, dans le
schéma du contexte. createKnexEventSourcing refuse un knex qui ne parle pas PostgreSQL.
Chaque instruction s'exécute sur l'exécuteur du contexte : un ajout rejoint la transaction de
l'unité de travail, si bien que le flux et les enregistrements d'outbox que publient ses
événements sont validés ensemble (eventStoreUnitOfWorkContract). Les ajouts prennent la tête
du store, une ligne verrouillée jusqu'à la fin de leur transaction : les positions sont données
dans l'ordre des validations, sans trou, et deux ajouts ne s'exécutent jamais côte à côte, quels
que soient leurs flux. PostgreSQL seulement. Les stores sont ceux du noyau (PostgresEventStore
et ses compagnons), tenus ici à eventStoreContract ; la manière dont un agrégat en event
sourcing les utilise : le README de @ddd-ts-kit/kernel, section « Event sourcing ».
Jobs en arrière-plan
Section intitulée « Jobs en arrière-plan »KnexJobStore est le JobStore de @ddd-ts-kit/scheduling sur PostgreSQL : les jobs en
arrière-plan d'un contexte dans une table de son schéma, createJobTable(knex, { schema })
appelé depuis une migration. add s'exécute sur l'exécuteur du contexte, si bien qu'un job
mis en file par une commande est écrit par la transaction de la commande ; les réservations
sélectionnent les lignes dues FOR UPDATE SKIP LOCKED dans une transaction courte à elles et les
réservent par un bail. Liez-le dans la racine de composition :
kernelModule({ unitOfWork, jobStore: new KnexJobStore(unitOfWork, { schema: 'scheduling' }) });export const up = (knex) => createJobTable(knex, { schema: 'scheduling' });export const down = (knex) => dropJobTable(knex, { schema: 'scheduling' });Le store passe jobStoreContract, sa suite d'unité de travail comprise, sur PGlite et sur
PostgreSQL. MySQL et SQLite ne sont pas couverts : la table utilise jsonb et un index partiel.
Ce que garantissent les jobs : Jobs en arrière-plan.
Gestionnaires de processus
Section intitulée « Gestionnaires de processus »KnexProcessStore est le ProcessStore du noyau : une ligne par tenant, par processus et par
clé de corrélation dans process_instances, créée par createProcessTable(knex, { schema }) depuis une
migration (dropProcessTable est son down). Une première sauvegarde insère, en ignorant une
ligne qu'une première sauvegarde concurrente a écrite ; une suivante met à jour la ligne à la
version précédente ; une sauvegarde qui ne change aucune ligne lève ConcurrencyError. Il
s'exécute sur l'exécuteur du contexte, dans la transaction de l'étape, et passe
processStoreContract avec son unité de travail.
Avec tenant (l'ExecutionScope), le store garde chaque instance dans le tenant du travail qui
l'enregistre : la table repère aussi une ligne par son tenant, le texte vide hors de tout tenant,
si bien que deux tenants peuvent utiliser la même clé de corrélation ; une instance d'un autre
tenant n'est ni trouvée ni modifiée, et un travail qui ne nomme aucun tenant est refusé par
NoCurrentTenantError.
Couverture des dialectes
Section intitulée « Couverture des dialectes »Ce qui suit concerne ce package. La CLI ne génère que pour PostgreSQL : init --orm knex
refuse --database mysql et --database sqlite.
| Base de données | État |
|---|---|
| PostgreSQL | Couvert par la suite automatisée : suites de contrat de @ddd-ts-kit/testing, contrat de repository, annulation, unité de travail imbriquée, réservations concurrentes. Elle s'exécute par défaut sur PGlite servi par le protocole réseau de PostgreSQL, et sur un vrai serveur quand DDD_TS_KIT_TEST_DATABASE_URL est définie (dernière exécution : PostgreSQL 18). |
| MySQL 8 | Absent de la suite automatisée. Les suites de contrat de l'outbox et des événements traités, et l'annulation d'append, ont été exécutées une fois à la main contre MySQL 8.4 avec mysql2, avec skip-locked et compare-and-set. |
| SQLite | Automatisé, dans l'exécution unitaire : les suites de contrat de l'outbox et des événements traités s'exécutent sur une base en mémoire avec better-sqlite3, sans conteneur ni variable d'environnement (test/stores.sqlite.spec.ts). Pas de SKIP LOCKED : la réservation est compare-and-set. Pas de schémas : createOutboxTables refuse schema ; nommez plutôt les tables par contexte. |
| MariaDB, CockroachDB, SQL Server, Oracle | Jamais exécutées. MariaDB stocke le JSON sous forme de texte : le payload reviendrait donc sous forme de chaîne. |
- Le
DATETIMEde MySQL n'a pas de fuseau horaire, et knex convertit les dates dans le fuseau horaire du processus : donnez le même à chaque processus, ou poseztimezone: 'Z'sur la connexion. - Sur MySQL 5.7 et MariaDB avant 10.6, il n'y a pas de
SKIP LOCKED: passezclaim: 'compare-and-set'. - Le payload de l'outbox est sérialisé avec
JSON.stringify: il doit donc être du JSON, ce qu'exige déjà le contrat des événements d'intégration. Un payloadundefinedest stocké commeNULLSQL et relu commenull. - L'ordre n'est pas garanti, pas même par agrégat : un événement en échec est retenté plus tard pendant que ses successeurs partent.
Tester un adaptateur
Section intitulée « Tester un adaptateur »L'unité de travail de ce package passe unitOfWorkContract, et ses stores
outboxStoreContract et processedEventStoreContract, de @ddd-ts-kit/testing/contracts.
Tenez vos repositories à repositoryContract de la même manière, à côté de leur fake en
mémoire : la même suite prouve alors que le fake avec lequel les gestionnaires sont testés se
comporte comme l'adaptateur qui tourne en production (retrouvé après une sauvegarde, tenu à part,
sauvegardes suivantes stockées, changements non sauvegardés ignorés, changement non vu refusé avec
CONCURRENCY_CONFLICT).
import { afterAll, afterEach, beforeEach, describe, expect, it } from 'vitest';import { knex } from 'knex';import { AggregateRoot } from '@ddd-ts-kit/kernel';import { createKnexUnitOfWork, KnexContext } from '@ddd-ts-kit/knex';import { repositoryContract } from '@ddd-ts-kit/testing/contracts';
// L'agrégat et l'adaptateur du contexte, déclarés pour que ce fichier se lise seul.declare class Invoice extends AggregateRoot {  static draft(id: string, amount: number): Invoice;  addCharge(amount: number): void;  readonly state: { readonly amount: number; readonly status: 'draft' | 'issued' };}
declare class KnexInvoiceRepository {  constructor(context: KnexContext);  findById(id: string): Promise<Invoice | undefined>;  save(invoice: Invoice): Promise<void>;}
declare const testDatabaseUrl: string; // une base de données de l'exécution des tests, migrée
const db = knex({ client: 'pg', connection: testDatabaseUrl });let next = 0;
afterAll(() => db.destroy());
repositoryContract<Invoice>(  { describe, it, expect, beforeEach, afterEach },  {    name: 'KnexInvoiceRepository',    createRepository: async () => {      await db('invoices').withSchema('billing_core').delete();
      return new KnexInvoiceRepository(createKnexUnitOfWork(db));    },    createAggregate: () => Invoice.draft(`inv-${(next += 1)}`, 100),    mutate: (invoice) => invoice.addCharge(50),    idOf: (invoice) => invoice.id,    stateOf: (invoice) => invoice.state,  },);
Les tests de ce package n'ont besoin d'aucun conteneur :
npx vitest run packages/knexDDD_TS_KIT_TEST_DATABASE_URL=postgresql://user:password@localhost:5432/postgres npx vitest run packages/knexAvec la variable définie, chaque fichier de spec crée sa propre base de données sur ce serveur et la supprime ensuite, et les tests qui ont besoin de deux vraies connexions (un relais qui passe sur des lignes verrouillées par un autre) s'exécutent au lieu d'être ignorés.