
@ddd-ts-kit/audit
Un journal d'audit (audit trail) inviolable de manière démontrable, dans lequel les cas d'usage n'écrivent jamais. Qui a été autorisé ou refusé à faire quoi, quelle commande s'est exécutée et comment elle s'est terminée, quel événement d'intégration est survenu, quelle personne concernée a été effacée : chaque fait est une entrée en ajout seul, chaînée par hachage à celle qui la précède, enregistrée par un middleware de bus, le hook d'autorisation, le pipeline HTTP quand une garde refuse, un abonnement aux événements, ou le stockage des clés des personnes concernées. Aucun gestionnaire (handler) et aucun agrégat ne contient d'appel d'audit.
npm i @ddd-ts-kit/auditnpm i knex pg # seulement pour @ddd-ts-kit/audit/knexnpm i drizzle-orm # seulement pour @ddd-ts-kit/audit/drizzlenpm i typeorm # seulement pour @ddd-ts-kit/audit/typeorm| Point d'entrée | Contient | Importe |
|---|---|---|
@ddd-ts-kit/audit |
InMemoryAuditTrail, les sources (auditDecisions, auditGuardRefusals, auditMiddleware, auditIntegrationEvents, auditedSubjectKeys, auditedPersonalDataErasure, auditedPersonalDataExport, auditedPersonalDataRetention), logLostRecords et auditRecordOf, auditedFields, auditedProjection et masked, le port AuditMasker et hmacMasker, verifyChain, verifyTrail et sa tâche VerifyAuditTrail, TenantAuditReader, les primitives de la chaîne (canonicalize, hashOf, wellFormed, GENESIS_HASH, chainOfTenant) ; réexportés depuis le noyau : AuditEntry, les ports AuditTrail et AuditReader et les types qu'ils nomment |
le noyau seulement |
@ddd-ts-kit/audit/knex |
KnexAuditTrail, createAuditTables, dropAuditTables |
knex (pair optionnel) |
@ddd-ts-kit/audit/drizzle |
DrizzleAuditTrail, auditEntriesTable, auditChainsTable, auditGuardStatements |
drizzle-orm (pair optionnel) |
@ddd-ts-kit/audit/prisma |
PrismaAuditTrail, auditPrismaModels, auditGuardStatements |
rien : le client de l'unité de travail de @ddd-ts-kit/prisma convient structurellement |
@ddd-ts-kit/audit/typeorm |
TypeOrmAuditTrail, auditEntities, auditGuardStatements |
typeorm (pair optionnel) |
@ddd-ts-kit/audit/testing |
auditTrailContract |
@ddd-ts-kit/testing (pair optionnel), le runner que vous passez |
Un journal d'audit répond à « qui a fait quoi, quand, et était-ce autorisé » à quelqu'un qui ne fait pas confiance à l'application : un auditeur, un client, un régulateur. Trois conséquences :
- Il est alimenté depuis l'extérieur des cas d'usage. Un gestionnaire qui doit penser à appeler l'audit l'oubliera, et un agrégat qui l'appelle a cessé d'être un modèle. Les décisions d'autorisation, les refus à la frontière HTTP, les commandes et les événements d'intégration passent déjà par quelques endroits (le middleware d'autorisation, le pipeline HTTP, les bus, les abonnements aux événements) ; c'est là que les entrées sont écrites.
- Il est en ajout seul, et chaque entrée scelle la précédente. Modifier, supprimer ou
réordonner une entrée rompt la chaîne à un endroit que
verifyChainnomme. - Il contient des identifiants et des codes, jamais de contenu. Même règle que pour le traçage et le package des aspects : des noms de classes, des identifiants de permissions, des codes d'erreur ; jamais d'arguments, de résultats ni de messages. Une valeur n'entre que si le projet la déclare, champ par champ.
Ce n'est pas un journal applicatif (les journaux sont échantillonnés, tournés et perdus), pas de
l'event sourcing (il ne reconstruit pas d'état) et pas l'AuditStamp du noyau (createdBy,
updatedBy : le dernier auteur d'une ligne, pas l'historique).
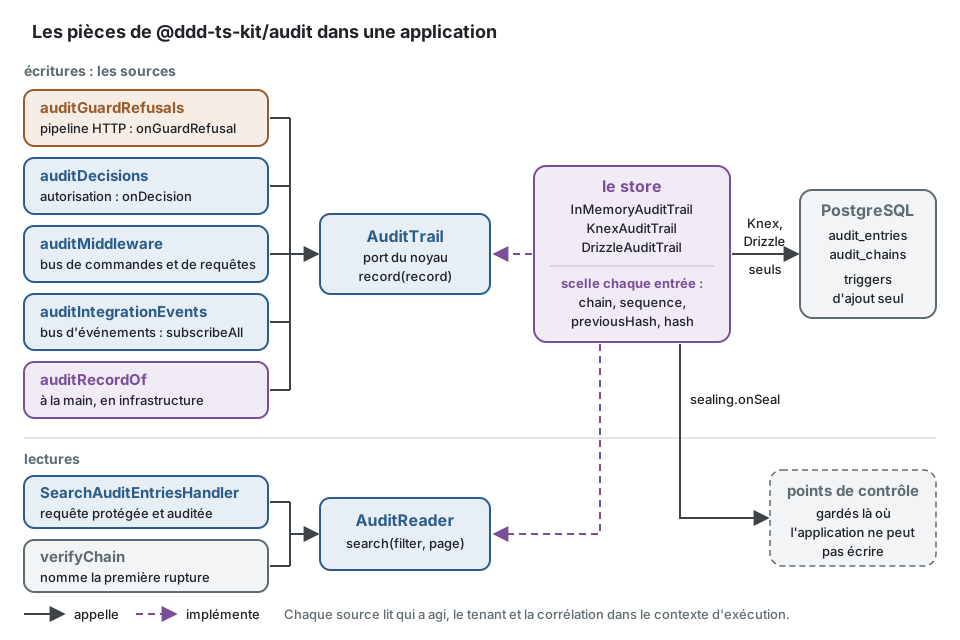
Le schéma est la carte de cette page : l'entrée et son hachage, les sources, le caviardage, la vérification, les stores et la recherche.
Un premier journal, en mémoire
Section intitulée « Un premier journal, en mémoire »Tout à la fois, dans un seul fichier qui s'exécute : un bus de commandes avec le middleware
d'audit, la déclaration de ce que porte l'entrée d'une commande, deux commandes, puis la
vérification de la chaîne et ce qu'une entrée modifiée lui fait. InMemoryAuditTrail est le
fake des tests ; en production, un store SQL prend sa place et rien d'autre ne change.
import {  AuthorizedCommand,  FixedClock,  FixedExecutionScope,  InMemoryCommandBus,  SequentialIdGenerator,  executionContext,  type Actor,} from '@ddd-ts-kit/kernel';import { InMemoryAuditTrail, auditMiddleware, auditedFields, hmacMasker, masked, verifyChain } from '@ddd-ts-kit/audit';
class RescheduleAppointmentCommand extends AuthorizedCommand {  constructor(    actor: Actor,    readonly appointmentId: string,    readonly startsAt: Date,    readonly patientEmail: string,    readonly note: string,  ) {    super(actor);  }}
const ada: Actor = { id: 'ada', type: 'user', tenantId: 'acme', roles: ['practitioner'], attributes: {} };
// Dans une application, la frontière HTTP ouvre cette portée pour chaque requête HTTP.const scope = new FixedExecutionScope(executionContext({ correlationId: 'request-1', actor: ada, origin: 'http' }));const trail = new InMemoryAuditTrail();
const commands = new InMemoryCommandBus()  .use(    auditMiddleware(trail, {      scope,      clock: new FixedClock(new Date('2026-03-01T10:00:00.000Z')),      ids: new SequentialIdGenerator('audit'),      masker: hmacMasker('a secret of the configuration', { keyId: 'k1' }),      fields: [        auditedFields(RescheduleAppointmentCommand, ['startsAt', masked('patientEmail')], {          resource: (command) => ({ type: 'appointment', id: command.appointmentId }),          context: 'scheduling',        }),      ],    }),  )  .register(RescheduleAppointmentCommand, { execute: async () => undefined }); // le gestionnaire : aucun appel d'audit
const startsAt = new Date('2026-03-04T09:30:00.000Z');await commands.execute(new RescheduleAppointmentCommand(ada, 'apt-1', startsAt, 'lin@example.org', 'Family matter'));await commands.execute(new RescheduleAppointmentCommand(ada, 'apt-1', startsAt, 'lin@example.org', 'Again'));
// trail.entries[0] :// { id: 'audit-1', chain: 'tenant:acme', sequence: 1, occurredAt: 2026-03-01T10:00:00.000Z,//   category: 'command', action: 'RescheduleAppointmentCommand', outcome: 'succeeded',//   resource: { type: 'appointment', id: 'apt-1' }, context: 'scheduling',//   changes: { startsAt: '2026-03-04T09:30:00.000Z', patientEmail: { masked: 'k1:f3997a...' } },//   actor: { id: 'ada', type: 'user', tenantId: 'acme' }, tenantId: 'acme',//   correlationId: 'request-1', origin: 'http', extensions: {},//   previousHash: '0000...0000', hash: 'f65501...' }// Pas de `note` : il n'a pas été déclaré, il n'a donc jamais été lu.
await verifyChain(trail.entries); // { valid: true, checked: 2 }
// Quelqu'un déplace le rendez-vous d'une heure, dans le journal lui-même :const first = trail.entries[0];
if (first !== undefined) {  trail.entries[0] = { ...first, changes: { ...first.changes, startsAt: '2026-03-04T10:30:00.000Z' } };}
await verifyChain(trail.entries);// { valid: false, checked: 0,//   break: { kind: 'altered-content', chain: 'tenant:acme', position: 0, sequence: 1, entryId: 'audit-1' } }
Ada travaille dans le tenant acme : ses entrées vont donc dans la chaîne tenant:acme ; la
seconde porte le hachage de la première comme previousHash. La suite de cette page prend chaque
pièce tour à tour.
L'entrée
Section intitulée « L'entrée »L'entrée est un type standard du noyau, et les deux ports, AuditTrail et AuditReader, sont
des classes abstraites du noyau, si bien que le code qui enregistre ou qui liste ne dépend que du
noyau. Une classe de port est aussi la clé d'une liaison : il n'y a pas de jeton à côté. Ce
package les réexporte, et contient tout ce qui rend un journal inviolable de manière
démontrable : la chaîne, les sources, le caviardage, la vérification et les stores.
interface AuditEntry { id: string; chain: string; // 'tenant:<id>', ou 'global' pour un travail qui ne nomme aucun tenant sequence: number; // position dans la chaîne : 1, 2, 3, sans trou occurredAt: Date; category: 'authorization' | 'command' | 'query' | 'integration-event' | 'authentication' | 'data-access' | string; action: string; // un identifiant de permission, un nom de commande, un type d'événement outcome: 'allowed' | 'denied' | 'succeeded' | 'failed'; reason?: string; // un code stable : NO_MATCHING_ROLE, le code d'une DomainError actor: { id: string; type: ActorType | 'unknown'; tenantId?: string }; tenantId?: string; // le tenant du travail en cours impersonatedBy?: string; sessionId?: string; resource?: { type: string; id: string }; context?: string; // contexte délimité correlationId: string; causationId?: string; origin: ExecutionOrigin; // 'http', 'event', 'schedule', 'cli', ... changes?: Record<string, string | number | boolean | null | { masked: string }>; extensions: AuditEntryExtensionValues; previousHash: string; hash: string;}Une source remet un AuditRecord (l'entrée sans chain, sequence, previousHash ni hash)
au journal, qui le scelle. L'acteur, le tenant, la session, l'emprunt d'identité
(impersonation), la corrélation, la causalité et l'origine sont lus dans l'ExecutionScope du
noyau, jamais transmis à travers un cas d'usage.
Un projet ajoute ses propres champs par fusion de déclarations, comme pour la Session du noyau.
Ils vivent sous extensions, sont optionnels à la lecture, et doivent être du JSON (une Date ou
une classe se lit comme never), puisqu'ils sont hachés et stockés tels quels. L'interface est
celle du noyau : augmentez @ddd-ts-kit/kernel, à côté des autres extensions du projet
(augmenter @ddd-ts-kit/audit fonctionne encore) :
declare module '@ddd-ts-kit/kernel' { interface AuditEntryExtensions { readonly region: 'eu' | 'us'; }}Une chaîne par tenant
Section intitulée « Une chaîne par tenant »Chaque entrée appartient à une chaîne : tenant:<id> quand le travail en cours nomme un
tenant, global sinon (chainOfTenant). Les raisons : un tenant peut être vérifié, exporté
et remis sans les entrées des autres ; les ajouts à une chaîne sont sérialisés, si bien qu'une
seule chaîne pour tout ferait attendre chaque commande du système sur le même verrou ; et un
tenant qui part laisse des chaînes qui se vérifient encore. Le prix : l'ordre entre les entrées
de deux tenants n'est donné que par occurredAt, pas prouvé par un hachage. Passez chainOf à
un journal pour en décider autrement (une chaîne par contexte délimité, une chaîne unique pour un
petit système).
Une commande peut agir sur un autre tenant que celui du travail : une personne d'acme qui
ouvre une organisation, ou invite quelqu'un dans une autre dont elle est membre. tenantOf(message)
d'auditMiddleware nomme ce tenant, et l'entrée du message, une fois qu'il a réussi, le prend
pour tenantId, si bien qu'elle s'écrit dans sa chaîne, son actor.tenantId restant celui du
jeton. Un échec, et la décision d'auditDecisions, restent dans le tenant du travail : ils
enregistrent ce que l'appelant a demandé, et un appelant qui nomme un tenant où il ne peut pas
agir n'écrit jamais dans sa chaîne, ni n'en ouvre une.
Le hachage
Section intitulée « Le hachage »hash est le SHA-256, en hexadécimal minuscule, de la forme canonique de l'entrée sans hash :
previousHash, chain et sequence font donc partie de ce qui est scellé. La forme canonique
(canonicalize) est faite pour être recalculée par n'importe quel programme, dans n'importe quel
langage :
- du JSON sans espaces, encodé en UTF-8 ;
- les clés de chaque objet triées par unité de code UTF-16, à toutes les profondeurs ;
- une propriété dont la valeur est
undefinedomise ; occurredAtécrit en ISO 8601 UTC avec les millisecondes (2026-03-01T10:00:00.000Z) ;- les chaînes et les nombres tels que
JSON.stringifyles écrit.
Une entrée est hachée telle qu'un store la garde. Un surrogate sans sa paire n'a pas d'encodage
UTF-8 et PostgreSQL refuse NUL : chaque texte d'une entrée, les clés de changes et d'extensions
et le nom de la chaîne compris, est donc scellé avec U+FFFD à leur place : ce qui est relu est ce
qui a été haché, quoi que contienne un enregistrement. wellFormed donne cette forme, à un store
écrit par vos soins aussi.
La première entrée d'une chaîne a un previousHash égal à GENESIS_HASH (64 zéros).
Brancher les sources
Section intitulée « Brancher les sources »Tout se passe dans la racine de composition. D'abord assemblées à la main ; les mêmes pièces
liées dans une application de @ddd-ts-kit/di viennent
après les sources. L'ordre des middlewares de
commandes compte :
import { unitOfWorkMiddleware } from '@ddd-ts-kit/kernel';import { authorizationMiddleware } from '@ddd-ts-kit/auth';import { subscribeAll } from '@ddd-ts-kit/events';import { auditDecisions, auditIntegrationEvents, auditMiddleware, auditedFields, hmacMasker, masked } from '@ddd-ts-kit/audit';import { KnexAuditTrail } from '@ddd-ts-kit/audit/knex';
const trail = new KnexAuditTrail(unitOfWork, { schema: 'audit' }); // tout ce qui a `executor()` : l'unité de travail de @ddd-ts-kit/knex, ou son contexteconst source = { scope, clock, ids };
commandBus  // 1. qui a le droit : refusé avant qu'une transaction ne s'ouvre  .use(authorizationMiddleware({ authorizer, map, onDecision: auditDecisions(trail, { ...source, sensitivePermissions: ['records:medical-file.read'] }) }))  // 2. ce qui s'est exécuté et comment cela s'est terminé : ouvre lui-même l'unité de travail  .use(auditMiddleware(trail, {    ...source,    unitOfWork,    masker: hmacMasker(config.auditMaskingSecret, { keyId: 'k1' }),    fields: [auditedFields(RescheduleAppointmentCommand, ['status', 'startsAt', masked('patientEmail')], {      resource: (command) => ({ type: 'appointment', id: command.appointmentId }),      context: 'scheduling',    })],  }))  // 3. rejoint la transaction ouverte par 2  .use(unitOfWorkMiddleware(unitOfWork));
// 4. ce qui est survenu entre les contextessubscribeAll(eventBus, auditIntegrationEvents(trail, { registry, clock, ids, processed, unitOfWork }));
a. Décisions d'autorisation
Section intitulée « a. Décisions d'autorisation »auditDecisions(trail, options) renvoie la fonction onDecision du middleware d'autorisation
de @ddd-ts-kit/auth. Les types correspondent structurellement : ce package ne dépend pas du
package auth. Chaque entrée a la catégorie authorization, l'identifiant de la permission comme
action, allowed ou denied comme résultat, le code du refus comme reason, la ressource de
la décision.
Ce qui est enregistré par défaut :
| Décision | Enregistrée |
|---|---|
| refusée, commande ou requête | toujours |
| autorisée, tout ce qui n'est pas une lecture | toujours |
lecture autorisée d'une permission listée dans sensitivePermissions |
toujours |
| toute autre lecture autorisée | non |
Enregistrer chaque liste et chaque consultation de page noie le journal et le rend coûteux à
conserver : les lectures autorisées enregistrées sont donc celles que vous choisissez.
allowedReads: 'all' les enregistre toutes, allowedReads: { sample: 0.01 } une sur cent. Une
lecture est, par défaut, une décision dont le kind est query : le middleware le tient du bus
qui a porté le message, quel que soit le nom de la classe. Une décision prise hors d'un bus ne
nomme aucun genre et est enregistrée. Passez isRead pour en décider autrement.
Quand la décision concerne un autre acteur que celui du contexte d'exécution (un consommateur qui
envoie une commande pour le compte d'un utilisateur), l'entrée nomme l'acteur de la décision avec
le type unknown : son type et son tenant ne font pas partie de ce que reçoit le hook.
a'. Refus à la frontière
Section intitulée « a'. Refus à la frontière »Une requête HTTP qu'une garde refuse (HasRole, HasScope, TenantMember, un tenant auquel
l'appelant n'appartient pas) n'atteint jamais un cas d'usage : le middleware d'autorisation ne la
voit donc pas. Le pipeline HTTP la signale à onGuardRefusal, et
auditGuardRefusals(trail, { clock, ids }) l'enregistre : catégorie authorization, action
http:<operationId>, résultat denied, le code du refus comme reason (FORBIDDEN,
UNAUTHORIZED), et l'acteur, la session, le tenant et la corrélation de la requête HTTP. Un
appelant sans identifiants n'est pas enregistré : il n'y a personne à qui demander des comptes, le
tenant auquel il s'est adressé est son propre choix, et l'enregistrer laisserait un trafic non
authentifié écrire dans le journal (et ouvrir des chaînes de hachage) sans limite ; ces refus
relèvent du journal d'accès et de la limitation de débit. Un refus enregistré est dans le tenant
des identifiants de l'appelant. Une garde qui échoue au lieu de refuser (une recherche qui a levé
une exception, pas une DomainError) n'est pas signalée.
mountExpress(app, routes, { ...boundary, onGuardRefusal: auditGuardRefusals(trail, { clock, ids }) });b. Commandes, et l'unité de travail
Section intitulée « b. Commandes, et l'unité de travail »auditMiddleware enregistre chaque commande avec le résultat succeeded ou failed, et le
code de la DomainError comme raison. Un échec qui n'est pas une DomainError est enregistré
comme UNEXPECTED_ERROR : ni sa classe ni son message n'entrent dans le journal, ils citent des
données. queries: [ReadMedicalFileQuery] ou queries: 'all' enregistre aussi les requêtes.
Deux exigences tirent en sens opposés : l'entrée d'une commande en échec doit survivre à
l'annulation (rollback), et l'entrée d'une commande réussie ne doit pas exister si sa
transaction n'a pas été validée. Un middleware placé dans l'unité de travail perd la première,
un middleware placé à l'extérieur perd la seconde (un arrêt brutal entre la validation et
l'enregistrement, ou une entrée écrite pour une validation qui a ensuite été refusée). D'où
l'agencement : le middleware est installé avant unitOfWorkMiddleware et reçoit l'unité de
travail.
- Il ouvre lui-même l'unité de travail ;
unitOfWorkMiddleware, et toutrunimbriqué, rejoignent cette transaction. - Après le retour du gestionnaire, il écrit l'entrée
succeededdans cette transaction. L'entrée et le changement d'état sont validés ensemble, ou aucun des deux n'existe. Si l'entrée ne peut pas être écrite, la commande échoue et est annulée : aucun changement d'état sans sa trace. - Quand le gestionnaire lève une erreur, ou que la validation est refusée, la transaction n'est
plus ; le middleware écrit alors l'entrée
failedhors de celle-ci, et relève l'échec du cas d'usage. Si cette écriture échoue elle aussi, l'appelant reçoit tout de même l'échec du cas d'usage, etonLostRecorden est informé.
logLostRecords(logger) est un onLostRecord qui écrit une ligne audit entry lost dans le
journal applicatif, au niveau error : la catégorie, l'action et le motif de l'entrée, le type et
le code de l'échec, jamais son message, qui cite des données. Un projet généré avec le journal
d'audit le passe à auditMiddleware, auditedSubjectKeys, auditedPersonalDataErasure,
auditedPersonalDataExport et auditedPersonalDataRetention, dans l'application et dans les
scripts de --privacy on.
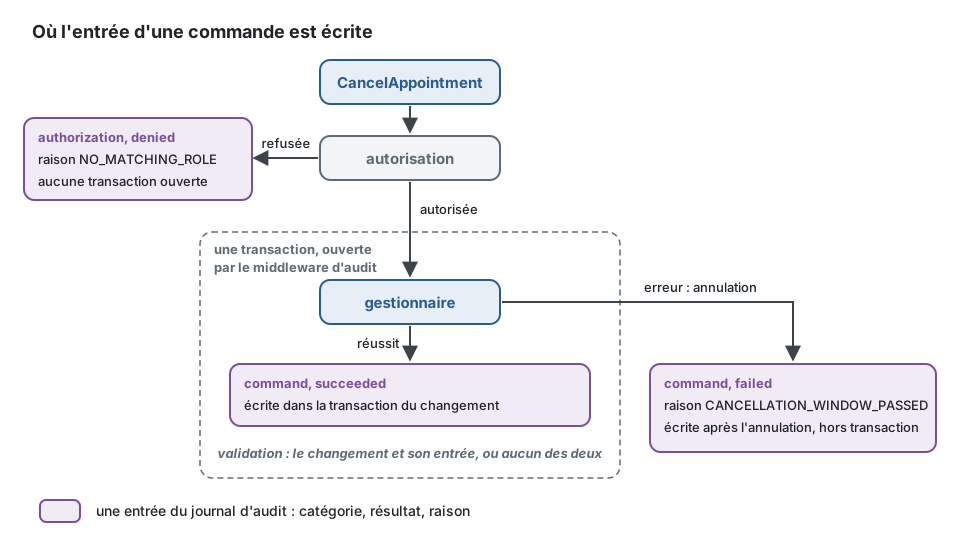
Sans unitOfWork (pas de base de données, le journal en mémoire), le middleware enregistre
après le gestionnaire. Enregistrer par l'outbox serait aussi atomique pour les succès, mais une
ligne d'outbox partage le sort de la transaction : elle ne peut donc pas porter les échecs, et ne
résout que la moitié du problème.
Placez le middleware d'autorisation avant celui-ci. Une commande refusée laisse alors une seule
entrée authorization denied et n'ouvre aucune transaction ; dans l'ordre inverse, elle
laisserait aussi une entrée command failed avec la raison FORBIDDEN.
c. Événements d'intégration
Section intitulée « c. Événements d'intégration »auditIntegrationEvents(trail, options) renvoie un abonnement par type d'événement du registre, à
remettre à subscribeAll. Il ne lit que l'enveloppe (type, id, corrélation), jamais le payload :
l'entrée dit que billing.invoice.issued est survenu, avec l'id de l'événement comme
causationId et la corrélation de l'enveloppe. La livraison se fait au moins une fois : il
déduplique donc par id d'événement grâce au ProcessedEventStore qu'il reçoit, sous le nom de
consommateur audit ; avec unitOfWork, la marque et l'entrée sont validées ensemble.
d. À la main, l'exception
Section intitulée « d. À la main, l'exception »AuditTrail.record reste disponible pour ce qu'aucune des sources ne peut voir : une entrée
data-access écrite par l'infrastructure, comme un export. auditRecordOf remplit tout ce que la
portée connaît :
await trail.record(auditRecordOf({ scope, clock, ids }, { category: 'data-access', action: 'scheduling.appointments.export', outcome: 'succeeded', changes: { rows: 2000, format: 'csv' },}));C'est du code d'infrastructure. Un appel au journal dans domain/ ou application/ est le défaut
que ce package existe pour empêcher, et
layer/application-inward signale
un import de @ddd-ts-kit/audit dans application/. Ce qu'un gestionnaire est tenté d'écrire,
et ce qui le remplace :
import { AuthorizedCommand, type Actor, type AuditTrail, type Clock, type ExecutionScope, type IdGenerator } from '@ddd-ts-kit/kernel';import { auditRecordOf, auditedFields } from '@ddd-ts-kit/audit';
class CancelAppointmentCommand extends AuthorizedCommand {  constructor(    actor: Actor,    readonly appointmentId: string,  ) {    super(actor);  }}
// Au lieu de : le gestionnaire enregistre sa propre entrée. Chaque gestionnaire doit y penser, un// échec ne laisse aucune entrée, et le cas d'usage dépend désormais de l'audit.export class CancelAppointmentHandler {  constructor(    private readonly trail: AuditTrail,    private readonly source: { scope: ExecutionScope; clock: Clock; ids: IdGenerator },  ) {}
  async execute(command: CancelAppointmentCommand): Promise<void> {    // ... annuler le rendez-vous ...    await this.trail.record(      auditRecordOf(this.source, {        category: 'command',        action: 'CancelAppointmentCommand',        outcome: 'succeeded',        resource: { type: 'appointment', id: command.appointmentId },      }),    );  }}
// Écrivez : le gestionnaire ne fait qu'annuler. Dans la racine de composition, une déclaration dit// ce que porte l'entrée, et `auditMiddleware` enregistre chaque résultat, échecs compris, avec leur code.export const cancelAppointmentAudit = auditedFields(CancelAppointmentCommand, [], {  resource: (command) => ({ type: 'appointment', id: command.appointmentId }),  context: 'scheduling',});
e. Effacements de personnes concernées
Section intitulée « e. Effacements de personnes concernées »L'effacement cryptographique (crypto-shredding) efface une personne en détruisant la clé avec
laquelle ses valeurs personnelles ont été scellées, dans le SubjectKeyStore du noyau
(Event sourcing).
La date de cette destruction est le point de départ de l'effacement : ajoutez-y la durée de
conservation des sauvegardes des clés, et vous obtenez le jour où il est complet.
auditedSubjectKeys(keys, trail, { scope, clock, ids }) décore le stockage, de sorte que chaque
erase, quel que soit l'appelant (un script, un gestionnaire de commande, un job), écrive une
entrée :
| Champ | Valeur |
|---|---|
category |
data-access |
action |
personal-data:erase (SUBJECT_ERASURE_ACTION) |
outcome |
succeeded, ou failed quand le stockage a levé une erreur, avec le code d'une DomainError ou UNEXPECTED_ERROR comme reason |
resource |
{ type: 'data-subject', id: <subject> } |
changes |
{ keyDestroyed: true }, ou { keyDestroyed: false } quand la personne n'avait plus de clé |
| acteur, tenant, session, corrélation, origine | le scope d'exécution |
La personne est l'id sous lequel ses clés sont rangées : un identifiant opaque, jamais un nom ni
un email, comme tout id de ressource. Un appelant qui reçoit l'id d'un humain (un script, un
formulaire) vérifie sa forme avant erase : l'entrée est définitive, et le journal ne contient
jamais de donnée personnelle. keyFor et find passent tels quels et n'écrivent rien.
// la racine de composition : décorer une fois, et donner la même instance au conteneur et aux scriptsconst subjectKeys = auditedSubjectKeys(eventSourcing.subjectKeys, trail, { scope, clock, ids });
builder.rebind(SubjectKeyStore).toValue(subjectKeys); // un effacement depuis un cas d'usage est enregistré aussi
Les clés et le journal gagnent à être séparés (les clés dans un stockage à elles, avec une conservation des sauvegardes plus courte), et les deux écritures ne partagent alors aucune transaction ; elles n'en partagent pas non plus dans un script qui n'ouvre aucune unité de travail. L'ordre est choisi pour que le journal ne dise jamais plus que ce qui s'est passé :
- Le contexte d'exécution est lu d'abord : un effacement hors de
ExecutionScope.runlèveNoExecutionContextErroravant qu'aucune clé ne soit touchée. Un script en ouvre un, avec l'opérateur comme acteur et l'originecli. - La clé est détruite.
- L'entrée est écrite, datée une fois que le stockage a répondu.
Quand l'étape 3 échoue, erase est rejeté avec cette erreur : la clé n'existe plus, aucune
entrée ne le dit encore, et l'appelant sait que l'effacement n'est pas terminé. Le relancer ne
trouve plus de clé et enregistre keyDestroyed: false, à une date ultérieure : une date
d'achèvement calculée depuis cette entrée peut être tardive, jamais précoce. Un effacement doit
de toute façon pouvoir être relancé, puisque ce qui le suit (reconstruire les projections qui en
gardent une copie en clair) peut échouer aussi. L'ordre inverse écrirait « effacé » avant de le
savoir, et laisserait une preuve fausse si la destruction échouait ensuite.
Quand l'étape 2 échoue, le stockage a pu détruire la clé ou non : l'entrée dit failed, avec le
code d'une DomainError ou UNEXPECTED_ERROR, et l'appelant reçoit l'erreur du stockage. Si
cette entrée ne peut pas être écrite non plus, onLostRecord(error, record) en est informé,
comme avec auditMiddleware.
Quand les clés et le journal sont dans une même base et que l'effacement tourne dans une unité de
travail (un gestionnaire de commande, derrière unitOfWorkMiddleware), les deux écritures
rejoignent sa transaction : la destruction et son entrée sont validées ensemble ou aucune
n'existe, et un échec annule l'entrée failed avec le reste. Ce que le journal garde de cet
échec, c'est l'entrée failed de la commande, que auditMiddleware écrit après l'annulation.
Ce qu'un projet garde en clair s'efface copie par copie, sans clé à détruire : un projet dont les
agrégats sont des lignes n'a aucun stockage de clés. auditedPersonalDataErasure(copy, trail, { scope, clock, ids }) décore une PersonalDataCopy, de sorte que chaque erase écrit la même entrée, avec le
nom de la copie comme context et changes: { rows }, 0 compris, sous l'acteur du travail. Le
contexte d'exécution est lu d'abord, les lignes sont effacées, puis l'entrée est écrite ; un échec est
enregistré avec son code et relevé, onLostRecord prévenu quand cette entrée se perd aussi. runErasure
d'un projet généré décore chaque copie, l'outbox et le stockage des jobs compris.
const audited = (copy: PersonalDataCopy): PersonalDataCopy => auditedPersonalDataErasure(copy, trail, source);
await eraseDataSubject(subject, { copies: dataSubjectCopies.map(audited) });
f. Exports de personnes concernées
Section intitulée « f. Exports de personnes concernées »Le droit d'accès et la portabilité remettent à une personne tout ce que le système garde d'elle :
une lecture du profil entier, dont la responsabilité de l'article 5(2) demande la trace, qui a lu
quoi de qui et quand. auditedPersonalDataExport(port, trail, { scope, clock, ids }) décore le port
PersonalDataExport d'un contexte, de sorte que chaque exportOf, quel que soit l'appelant (le
script privacy:export d'un projet généré, un gestionnaire de commande, un job), écrive une
entrée :
| Champ | Valeur |
|---|---|
category |
data-access |
action |
personal-data:export (PERSONAL_DATA_EXPORT_ACTION) |
outcome |
succeeded, ou failed quand le port a levé une erreur, avec le code d'une DomainError ou UNEXPECTED_ERROR comme reason |
resource |
{ type: 'data-subject', id: <subject> } |
context |
le name du port : le contexte borné |
changes |
{ records: <n> }, le nombre d'enregistrements lus, 0 quand le contexte ne garde rien de la personne |
| acteur, tenant, session, corrélation, origine | le scope d'exécution |
L'entrée ne contient jamais une valeur des enregistrements : le journal est en ajout seul et lu par
beaucoup, le document va à la personne seule. L'ordre est choisi pour qu'aucun document ne parte
sans sa trace : le contexte d'exécution est lu d'abord (un export hors de ExecutionScope.run est
refusé avant qu'une ligne ne soit lue), les enregistrements sont lus, l'entrée est écrite, et alors
seulement les enregistrements sont remis. Quand l'entrée ne peut pas être écrite, exportOf est
rejeté avec cette erreur et ne remet rien ; relancé, il relit les mêmes lignes et les enregistre. Un
essai est une lecture comme une autre et laisse son entrée : essayez un script sur une personne de
test, jamais sur une vraie. Une lecture qui échoue est enregistrée avec son code, puis relevée ; quand cette entrée ne peut pas
être écrite non plus, onLostRecord(error, record) en est informé. exportDataSubject du kernel
rassemble les exports ainsi décorés en un document daté, et init --privacy on le câble dans
src/platform/privacy/run-export.ts quand le journal est actif :
// src/platform/privacy/run-export.ts, tel qu'init l'écrit avec --audit onconst audited = (port: PersonalDataExport): PersonalDataExport => auditedPersonalDataExport(port, trail, source);const exports = dataSubjectExports.map((port) => audited(container.resolve(port)));g. Purges de ce qui a dépassé sa durée de conservation
Section intitulée « g. Purges de ce qui a dépassé sa durée de conservation »La limitation de la conservation de l'article 5(1)(e) s'applique sans que personne ne le demande :
le job de nuit d'un projet généré efface les lignes qui ont dépassé la durée que leur déclaration
donne. La responsabilité de l'article 5(2) demande la preuve qu'il tourne.
auditedPersonalDataRetention(port, trail, { scope, clock, ids }) décore le PersonalDataRetention
d'une copie, de sorte que chaque purgeExpired écrive une entrée : catégorie data-access, action
personal-data:purge (PERSONAL_DATA_PURGE_ACTION), le nom de la copie comme context,
changes: { rows }, 0 compris, et aucune ressource : une purge atteint des lignes par leur âge,
jamais par la personne qu'elles concernent, et l'entrée ne nomme donc personne. L'ordre est celui
des exports : le contexte d'exécution d'abord (le job et le script en ouvrent un), la purge, puis
l'entrée ; un échec est enregistré avec son code et relevé, onLostRecord informé quand cette
entrée se perd aussi.
Dans une application de @ddd-ts-kit/di
Section intitulée « Dans une application de @ddd-ts-kit/di »Le store est lié aux deux ports, et le masker au sien, chacun sous sa classe :
import { AuditReader, AuditTrail } from '@ddd-ts-kit/kernel';import { defineContextModule } from '@ddd-ts-kit/di';import { AuditMasker, hmacMasker } from '@ddd-ts-kit/audit';import { KnexAuditTrail } from '@ddd-ts-kit/audit/knex';
export const trail = new KnexAuditTrail(unitOfWork, { schema: 'audit' }); // l'unité de travail liée à `UnitOfWork` et à `KnexContext`
export const auditModule = defineContextModule({  name: 'audit',  register(builder) {    builder.bind(AuditTrail).toValue(trail);    builder.bind(AuditReader).toValue(trail);    builder.bind(AuditMasker).toValue(hmacMasker(config.auditMaskingSecret, { keyId: 'k1' }));  },});
builder.bind(AuditTrail).toClass(KnexAuditTrail, [KnexContext]) lie à la place un store avec
ses options par défaut, KnexContext étant le port de @ddd-ts-kit/knex.
Les sources sont installées là où les bus sont construits. Le bus de commandes de
kernelModule() exécute la garde des cas d'usage, puis l'unité de travail ; le middleware
d'audit doit se placer entre les deux, le bus est donc fourni par les options :
import { AuditTrail, InMemoryCommandBus, unitOfWorkMiddleware } from '@ddd-ts-kit/kernel';import { UseCaseGuard, kernelModule } from '@ddd-ts-kit/di';import { createApplication } from '@ddd-ts-kit/di/tsyringe';import { authorizationModule } from '@ddd-ts-kit/auth/di';import { AuditMasker, auditDecisions, auditMiddleware } from '@ddd-ts-kit/audit';
const source = { scope, clock, ids };
const app = createApplication({  modules: [    kernelModule({      executionScope: scope,      clock,      ids,      unitOfWork,      commandBus: (resolve) =>        new InMemoryCommandBus()          .use((message, next, info) => resolve(UseCaseGuard).check(message, next, info))          .use(auditMiddleware(resolve(AuditTrail), { ...source, unitOfWork, masker: resolve(AuditMasker), fields }))          .use(unitOfWorkMiddleware(unitOfWork)),    }),    auditModule,    schedulingModule,    authorizationModule({ authorizer, onDecision: auditDecisions(trail, { ...source, sensitivePermissions: ['records:medical-file.read'] }) }),  ],  authorization: 'required',});
Un projet généré par la CLI avec --audit on (la valeur par défaut) a ce câblage sous
src/platform/audit/ : create-audit-trail.ts construit le store des entrées, create-audit.ts ses sources, audit.module.ts
lie les deux ports, abonne les événements d'intégration sous le nom de consommateur audit et
enregistre la requête protégée SearchAuditEntriesQuery, et
src/platform/buses/create-command-bus.ts place le middleware d'audit entre la garde des cas
d'usage et l'unité de travail.
Un gestionnaire ou un adaptateur qui a besoin du journal nomme le port dans ses dépendances et
reçoit le store : [AuditReader] pour la requête qui liste les entrées (voir
Interroger le journal), [AuditTrail] pour l'adaptateur
d'infrastructure qui enregistre à la main.
Caviardage
Section intitulée « Caviardage »Par défaut, une entrée ne porte aucun payload. changes n'existe que pour ce qui a été
déclaré :
auditedFields(RescheduleAppointmentCommand, ['status', 'startsAt', masked('patientEmail')]);auditedProjection(ExportAppointmentsCommand, (command) => ({ plain: { format: command.options.format } }));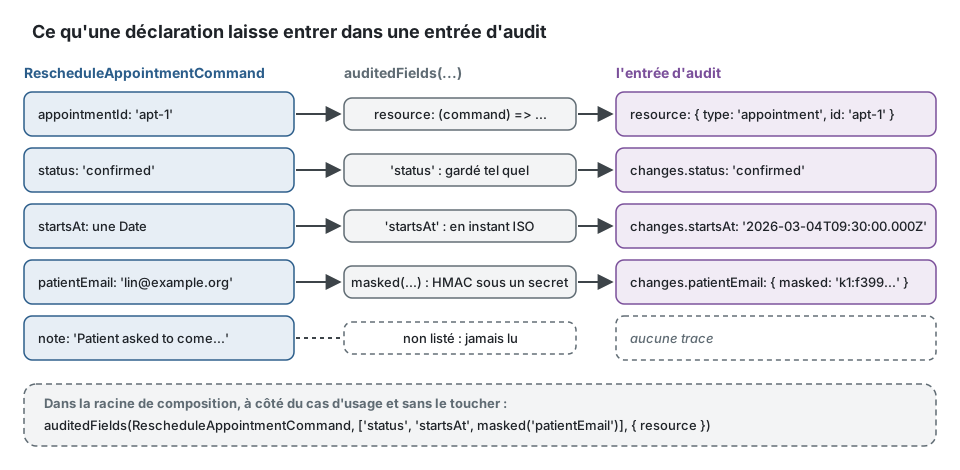
- Un champ qui n'est pas listé n'est jamais lu. Le compilateur refuse un nom que le message n'a pas.
- Une valeur n'est gardée que si c'est une chaîne, un nombre, un booléen,
null, un bigint (sous forme de texte) ou uneDate(sous forme d'instant ISO). Un objet n'est jamais stocké en entier : choisissez ses scalaires avecauditedProjection. masked('patientEmail')stocke{ masked: '<keyId>:<hex>' }: le HMAC-SHA-256 de la valeur sous un secret (hmacMasker). Deux entrées concernant le même email portent le même masque : « toutes les entrées concernant cette personne » peut donc être obtenu en masquant de nouveau l'email ; l'email lui-même n'y est pas, et sans le secret une supposition ne peut pas être vérifiée. Un simple hachage ne suffirait pas : un email ou un numéro de téléphone se devine en quelques secondes.masked('patientEmail', { subject: 'patientId' })dit à qui appartient la valeur : le champ du message qui tient l'identifiant opaque de la personne concernée, ousubjectOf: (command) => ...quand aucun champ seul ne le tient. Le masqueur le lit commedataSubject; l'entrée ne le porte jamais.- Un champ déclaré
maskedsans masker est refusé à la construction du middleware ; une projection qui demande un masque sans masker fait échouer la commande à sa première utilisation.
Ce qui ne doit jamais entrer, déclaré ou non :
- le texte libre (un commentaire, une raison saisie par un utilisateur, le corps d'un message) : il contient n'importe quoi ;
- les identifiants de connexion et les jetons, les cookies de session, les clés d'API, les codes à usage unique, même hachés ;
- les payloads entiers, les corps de requêtes HTTP, les agrégats, les résultats de requêtes ;
- les messages d'erreur et les traces de pile : enregistrez le
code; - les catégories particulières de données personnelles (santé, opinions, biométrie), même masquées, sauf si un enregistrement de décision (ADR) dit pourquoi.
Le droit à l'effacement et une chaîne en ajout seul
Section intitulée « Le droit à l'effacement et une chaîne en ajout seul »Une entrée ne peut pas être supprimée sans rompre sa chaîne, et une réglementation peut exiger que des données personnelles soient effacées. Les deux coexistent tant que la chaîne ne contient jamais les données :
-
Gardez les données personnelles dehors. Un id d'acteur, un id de ressource, un identifiant de permission sont des identifiants. Si vos identifiants sont eux-mêmes des données personnelles (un email comme id d'utilisateur), corrigez cela d'abord, ou masquez-les à la frontière.
-
Masquez ce que vous devez corréler. Une valeur masquée n'est pas lisible ; elle reste liée à une personne pour qui détient le secret.
-
L'effacement cryptographique (crypto-shredding) pour l'effacement.
subjectMasker(keys)masque chaque valeur sous une clé dérivée de la clé de sa personne concernée dans leSubjectKeyStoredu kernel, les mêmes clés qui scellent les valeurs personnelles des événements stockés (HKDF du matériau, étiqueté pour le journal ; en mémoire, ou dans la tablesubject_keysque crée l'event store de chaque package de persistance). Sans event sourcing,initn'écrit aucun magasin de clés etprivacy:erasene détruit aucune clé : un projet qui masque ainsi apporte le magasin et sa table, et donne le magasin commekeysàeraseDataSubject, sinon ses masques restent recalculables. Chaque champ masqué doit dire à qui il appartient,masked('patientEmail', { subject: 'patientId' }): le middleware refuse celui qui ne le dit pas, au câblage (MissingDataSubjectError), puisque l'acteur et la ressource d'une entrée sont rarement cette personne ; et ce sujet doit être un identifiant opaque (la grammaire d'un id de tenant), puisque le stockage de clés l'écrit en clair : un e-mail ou un nom à sa place est refusé avant qu'une clé ne soit créée (MaskingSubjectNotAnIdError). Effacer une personne (SubjectKeyStore.erase, enveloppé parauditedSubjectKeyspour que l'effacement laisse son entrée) détruit la clé : chaque masque fait avec elle devient un jeton d'apparence aléatoire que personne ne peut recalculer, les entrées restent, les hachages restent valides, et l'id de clé écrit devant chaque masque distingue les masques d'une clé disparue. Le stockage de clés est alors le système à protéger : gardez-le à part du journal et des événements, avec une rétention des sauvegardes plus courte.const keys = new PostgresSubjectKeyStore(run); // ou InMemorySubjectKeyStore, ou celui de create<Orm>EventSourcingauditMiddleware(trail, {scope,clock,ids,masker: subjectMasker(keys),fields: [auditedFields(RescheduleAppointmentCommand, ['status', masked('patientEmail', { subject: 'patientId' })])],});
Ce qui reste après l'effacement, c'est « un acteur avec cet id opaque a fait ceci à ce moment ».
Savoir si c'est acceptable est une question juridique pour le projet, à trancher avant que la
première entrée ne soit écrite. L'effacement lui-même laisse une entrée datée quand le stockage
des clés est décoré par auditedSubjectKeys et chaque copie par auditedPersonalDataErasure : voir
e. Effacements de personnes concernées.
Vérification et ancrage
Section intitulée « Vérification et ancrage »const outcome = await verifyChain(reader, { chain: 'tenant:acme' });// { valid: true, checked: 1842 }// { valid: false, checked: 311, break: { kind: 'altered-content', chain: 'tenant:acme', position: 311, sequence: 312, entryId: '...' } }verifyChain(entries | reader, { chain?, from?, to?, checkpoints?, after? }) parcourt une chaîne dans
l'ordre donné et signale le premier endroit où elle cesse de tenir :
| Genre | Signification |
|---|---|
altered-content |
l'entrée ne se hache pas en son hash, ne se lie pas à l'entrée qui la précède, ou contredit un point de contrôle |
missing-entry |
la séquence attendue n'est nulle part dans ce qui a été examiné (un trou, une tête manquante, une chaîne plus courte que to ou que le dernier point de contrôle donné) |
reordered |
la séquence attendue existe ailleurs, ou une position apparaît deux fois |
position est l'indice parmi les entrées examinées de la chaîne, sequence la séquence qui y
était attendue. Avec des entrées (un export), chaque chaîne trouvée est vérifiée, et les entrées
ne sont jamais triées d'abord : un fichier mélangé est signalé comme tel. Avec un lecteur, chain
est obligatoire et la plage est lue page par page, puis tenue en mémoire : vérifiez les longues
chaînes par plages (from, to). Une plage qui commence au-dessus de 1 fait confiance à l'entrée
qui la précède. Une chaîne qui a des archives se vérifie
depuis l'ancre de la dernière.
Le parcours s'arrête à sa première rupture : au-delà, la chaîne ne prouve rien de ce qui suit, et après une entrée disparue ou déplacée, l'endroit où elle reprend serait une supposition. La rupture est la réponse, et qui l'a examinée reprend le parcours à l'entrée suivante, ce qui fait confiance à cette entrée :
await verifyChain(reader, { chain: 'tenant:acme', from: 313 });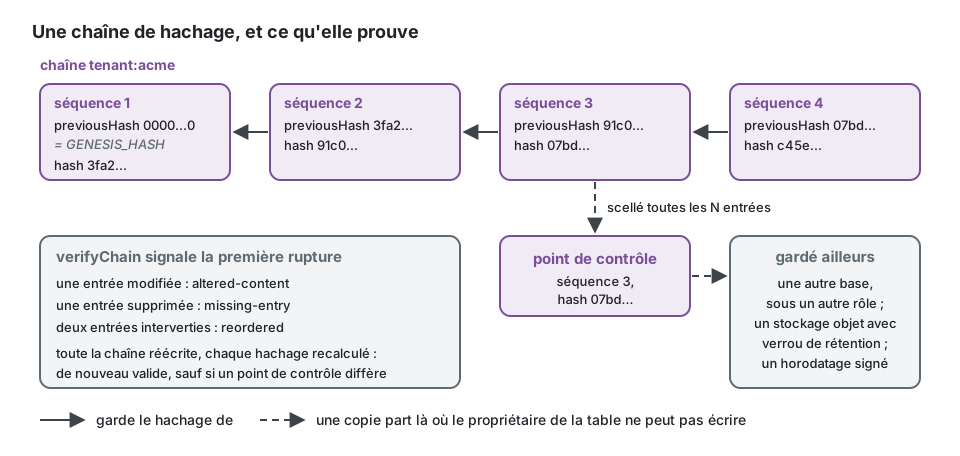
Pourquoi l'ancrage. La chaîne protège contre quiconque peut modifier quelques lignes.
Quiconque peut réécrire toute la table (un administrateur de base de données, un attaquant qui a
le rôle du propriétaire) peut recalculer chaque hachage à partir de l'entrée modifiée : le
résultat est une chaîne parfaitement valide. La seule défense est une copie de quelques hachages
là où cette personne ne peut pas écrire. sealing remet un point de contrôle toutes les N entrées
d'une chaîne :
new KnexAuditTrail(unitOfWork, { schema: 'audit', sealing: { every: 1000, onSeal: (checkpoint) => outbox.append([auditChainSealed.create(checkpoint, meta)]) },});// plus tard, contre les points de contrôle gardés ailleurs :await verifyChain(reader, { chain, checkpoints });Le hook s'exécute quand l'entrée est écrite, dans l'unité de travail quand il y en a une.
Ajouter là le point de contrôle à l'outbox fait qu'il ne part que si l'entrée est validée ; un
hook qui appelle directement un service distant peut ancrer une entrée dont la transaction est
annulée ensuite. L'endroit où vont les points de contrôle est le choix du projet : une autre base
de données sous un autre rôle, un stockage d'objets avec verrou de rétention, un journal de
transparence, un horodatage signé. Une fin tronquée (les dernières entrées supprimées) ne se voit
qu'en comparant avec un point de contrôle ultérieur ou en demandant to : une chaîne qui s'arrête
avant le dernier point de contrôle donné est signalée missing-entry à la première position
disparue, dans la limite de to quand il y en a un. Avec des entrées sans chain, une chaîne
qu'un point de contrôle nomme et qu'aucune entrée ne porte est signalée de la même façon.
Archivage
Section intitulée « Archivage »Un journal grandit aussi longtemps que vit le système, et chaque entrée garde les identifiants
d'une personne (RGPD, article 5(1)(e), limitation de la conservation). Les quatre stores SQL et
InMemoryAuditTrail implémentent ArchivableAuditTrail : les plus anciennes entrées de chaque
chaîne quittent la base pour un FileStorage du noyau, vérifiées, et la chaîne repart de leur
dernier hash.
const { archives } = await trail.archiveBefore(new Date('2025-06-01T00:00:00Z'), { files, clock });// [{ chain: 'tenant:acme', fromSequence: 1, toSequence: 4211, lastHash: '...', entries: 4211,// fileKey: 'audit-archives/tenant/acme/000000000001-000000004211.ndjson', fileDigest: '...', archivedAt }]Pour chaque chaîne, dans une transaction qui tient la tête de la chaîne : les entrées qui suivent
la dernière archive et sont antérieures à la date, sans trou, sont vérifiées depuis l'ancre de
l'archive qui les précède ; elles sont écrites dans un fichier, un JSON canonique par ligne ;
l'archive est enregistrée dans audit_archives (plage, dernier hash, SHA-256 du fichier) ; puis
les entrées sont supprimées. La garde de la table ne laisse passer un DELETE que pour des
entrées qu'une archive couvre, et refuse toute modification des archives elles-mêmes. Une chaîne
qui ne se vérifie pas garde toutes ses entrées, une rupture étant à examiner par l'opérateur, pas à
enfouir dans un fichier, et n'arrête aucune autre chaîne : chacune est tentée, puis
AuditArchiveRefusedError dit ce qui a été refusé (refusals, chacun avec sa chain et son
chainBreak) et ce que les autres ont archivé (archives). Le fichier est écrit, puis relu depuis
le stockage et son empreinte vérifiée, avant la validation de la transaction : un stockage qui ne
l'a pas gardé est refusé avec AuditArchiveNotStoredError, qui met fin au passage, et rien de
cette chaîne n'est supprimé ; un échec ensuite laisse un fichier qu'aucune archive ne nomme, que
le passage suivant réécrit sous la même clé.
Ce que le journal prouvait reste démontrable :
const [first, second] = await trail.archivesOf('tenant:acme');verifyArchive(await textOf(files, second.fileKey), second, first);// { valid: true, entries: 1830 } : l'empreinte, la plage, chaque hash et chaque lien, le dernier hashawait verifyChain(trail, { chain: 'tenant:acme', after: { chain: 'tenant:acme', sequence: second.toSequence, hash: second.lastHash } });// { valid: true, checked: 1204 } : les entrées restées en base se rattachent à l'ancre de la dernière archiveafter dit où commence le parcours : à la position qui suit l'ancre, au hash de laquelle la
première entrée doit se lier. Une chaîne qui a des archives se vérifie ainsi. Sa première entrée a
quitté la base, donc verifyChain(trail, { chain }) répond missing-entry à la séquence 1, comme
pour une chaîne dont la tête a été supprimée : le parcours ne lit pas les archives de lui-même.
Une ancre est ce que dit une ligne d'audit_archives tant que verifyArchive ne l'a pas prouvée
contre son fichier : c'est donc l'appelant qui nomme celle à laquelle il se fie.
verifyTrail(trail) vérifie chaque chaîne d'un journal qui archive, chacune de l'ancre de sa
dernière archive à sa tête (chainHeads() : la séquence et le hash de sa dernière entrée), de
sorte qu'une chaîne coupée à sa fin répond missing-entry. Les lignes des archives se suivent
sans trou, et la tête reprend après la dernière : une tête en deçà, ou à sa fin avec un autre
hash, répond altered-content. Avec files, le stockage où les archives ont été écrites, chaque
archive de chaque chaîne est relue, la plus ancienne d'abord, et prouvée par verifyArchive
contre celle d'avant : son empreinte, son intervalle, chaque entrée et chaque lien, son dernier
hash. Un stockage qui ne rend pas un fichier est la rupture de cette seule chaîne
(unreadable-archive). Sans files, une ancre est ce que dit sa ligne. Chaque chaîne s'arrête à
sa propre rupture et les autres sont vérifiées quand même :
await verifyTrail(trail);// { valid: true, checked: 1204, breaks: [] }// { valid: false, checked: 1180, breaks: [{ kind: 'altered-content', chain: 'tenant:acme', position: 24, sequence: 4235, entryId: '...' }] }VerifyAuditTrail(trail, files?) est la tâche planifiée de la plateforme qui l'exécute et échoue avec
AuditTrailBrokenError (breaks, code AUDIT_TRAIL_BROKEN) sur une rupture : le planificateur
journalise l'exécution échouée et la compte. Un projet généré avec le journal actif l'enregistre
comme audit.verify, chaque nuit à 04:30 UTC, désactivée par JOB_AUDIT_VERIFY_ENABLED=false, et
npm run audit:verify exécute la même vérification à la main. La tête est une ligne qu'écrit le
rôle de l'application : elle montre une fin retirée dans le dos du journal, pas une chaîne
réécrite en entier.
ArchiveAuditEntries(trail, files, clock, monthsOnline = 12) est la tâche planifiée de la
plateforme : chaque passage archive les entrées antérieures au premier jour du mois situé
monthsOnline mois entiers plus tôt, en UTC, si bien qu'un passage manqué est rattrapé par le
suivant. Un projet généré dont le journal est en base et dont les fichiers sont dans un stockage
l'enregistre sous audit.archive, le premier jour de chaque mois à 04:00 UTC. Avec un stockage
objet (--storage s3), il tourne sauf JOB_AUDIT_ARCHIVE_ENABLED=false ; avec --storage local,
il ne tourne qu'avec JOB_AUDIT_ARCHIVE_ENABLED=true : les fichiers seraient sur le disque du
serveur, qu'un redéploiement peut effacer et qu'une sauvegarde peut ne pas atteindre, et une archive
supprime les entrées de la base. Archivez vers un stockage durable et sauvegardé, avec un verrou de
conservation là où la loi en demande un.
Un journal créé avant les archives les ajoute une fois, dans une migration : addAuditArchives(knex, { schema }) sur Knex, les instructions de auditArchiveUpgradeStatements(schema) sur Drizzle,
Prisma et TypeORM, une fois la table de l'ORM générée.
Ce qu'une archive n'est pas : un effacement. Les entrées gardent les identifiants des personnes, dans un fichier au lieu d'une ligne ; combien de temps les fichiers sont gardés, et le verrou de conservation du bucket qui les garde, sont des décisions du responsable de traitement. La recherche dans le journal ne lit que la base.
InMemoryAuditTrail implémente les deux ports : le fake des tests (entries est le store, pour
vérifier et pour altérer) et de quoi suffire à une application sans base de données.
Les stores SQL sont pour PostgreSQL. Ils écrivent sur l'exécuteur de l'unité de travail
(KnexContext.executor(), DrizzleContext.executor(), PrismaContext.client(), TypeOrmContext.manager()) : dans une unité de travail, l'entrée est
écrite à sa validation et partage son sort ; hors de toute unité de travail, elle est écrite
immédiatement dans une transaction à elle.
// knex : une migration du projetimport { createAuditTables, dropAuditTables } from '@ddd-ts-kit/audit/knex';export const up = (knex) => createAuditTables(knex, { schema: 'audit' });export const down = (knex) => dropAuditTables(knex, { schema: 'audit' });
// drizzle : dans les fichiers de schéma que lit drizzle-kitimport { auditChainsTable, auditEntriesTable, auditGuardStatements } from '@ddd-ts-kit/audit/drizzle';export const auditEntries = auditEntriesTable('audit');export const auditChains = auditChainsTable('audit');// et dans une migration personnalisée (drizzle-kit generate --custom), puisque drizzle-kit n'écrit aucun trigger :for (const statement of auditGuardStatements('audit')) {  await db.execute(sql.raw(statement));}
new DrizzleAuditTrail(unitOfWork, { schema: 'audit' });
// prisma : les modèles dans prisma/schema/schema.prisma (avec "audit" dans les schémas de la datasource), le// garde dans une migration créée par `prisma migrate dev --create-only`console.log(auditPrismaModels('audit'));new PrismaAuditTrail(unitOfWork, { schema: 'audit' });
// typeorm : les entités enregistrées auprès de la data source, le garde dans une migration à vousconst dataSource = new DataSource({ type: 'postgres', entities: [...auditEntities({ schema: 'audit' })] });new TypeOrmAuditTrail(unitOfWork, { schema: 'audit' });
Les quatre stores partagent une seule implémentation PostgreSQL, et leurs specs tiennent chacun
au même contrat, entités et modèles compris : créés par les migrations d'un projet, ils donnent les
colonnes, les clés et les index de createAuditTables. Prisma écrit des instructions brutes sur le
client de l'unité de travail : il n'imbrique aucune transaction, donc un ajout à l'intérieur d'une
transaction prend un savepoint, et un échec de la base revient avec son SQLSTATE comme code
(23505, 23001), comme sur les autres stores, là où Prisma rapporte P2010. Son adaptateur de pg
lit un timestamptz sans le décalage de la session, alors le lecteur demande l'instant en UTC à
PostgreSQL.
Deux tables : audit_entries (clé primaire (chain, sequence), id unique, des index pour le
lecteur) et audit_chains, une ligne par chaîne qui détient sa dernière séquence et son dernier
hachage.
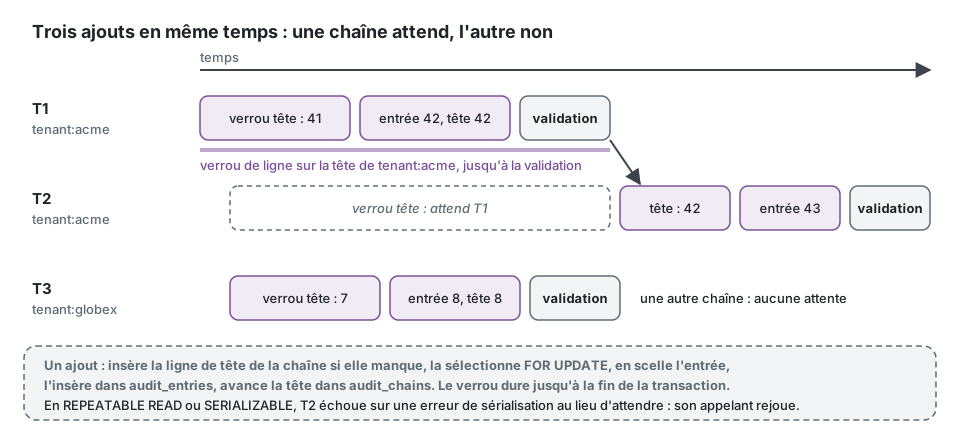
Concurrence. Un ajout insère la ligne de tête de sa chaîne si elle manque, puis la prend avec
SELECT ... FOR UPDATE, calcule l'entrée à partir d'elle, insère l'entrée et avance la tête. Le
verrou de ligne dure jusqu'à la fin de la transaction : deux ajouts à une même chaîne ne lisent
donc jamais la même tête, et la chaîne ne peut pas bifurquer ; les ajouts à d'autres chaînes
n'attendent pas. La clé primaire refuse une position en double si le verrou devait un jour être
contourné. En REPEATABLE READ ou SERIALIZABLE, le second ajout échoue sur une erreur de
sérialisation au lieu d'attendre, qui rejette l'unité de travail par une TransactionConflictError
(une ConcurrencyError, répondue 409), et son appelant la rejoue, comme pour toute autre
instruction à ces niveaux : le kit ne la rejoue pas.
À la validation. Dans une unité de travail, ce qui est enregistré attend sa validation
(atCommit du noyau) : les entrées sont écrites en dernier, après le travail et ses gestionnaires
before-commit, chaque chaîne une seule fois, les chaînes dans l'ordre de leurs noms. La tête est
alors le dernier verrou que prend la transaction, et toutes les transactions prennent les têtes
dans le même ordre : un ajout ne referme donc jamais d'interblocage (40P01) avec les lignes que
le travail a verrouillées, ni avec une autre chaîne, et une unité de travail encore à son travail
ne fait pas attendre les autres écrivains de son tenant. En contrepartie, les entrées d'une unité
de travail ne sont pas visibles en son sein avant la validation, et un refus du store (un id
écrit deux fois) fait échouer la validation, pas l'appel à record. Hors d'une unité de travail,
l'entrée est écrite tout de suite ; dans une transaction ouverte à la main, la tête reste alors
verrouillée jusqu'à la fin de cette transaction. Une unité de travail d'une autre base de données
ouverte dans celle en cours se termine avant elle : ses entrées sont écrites à la validation de
celle du dehors, dans une transaction à elles.
En ajout seul dans la base de données aussi. Le helper de migration crée la fonction
audit_entries_append_only et deux triggers : UPDATE, DELETE et TRUNCATE sur
audit_entries lèvent le SQLSTATE 23001, qui que ce soit qui les demande. Les triggers arrêtent
les erreurs et les bogues de l'application ; un rôle propriétaire de la table peut les supprimer.
L'application ne devrait donc pas posséder la table. Exécutez les migrations avec un rôle
propriétaire, et ne donnez au rôle de l'application et au rôle qui archive que ce dont chacun a
besoin :
revoke all on all tables in schema "audit" from public;grant usage on schema "audit" to app, audit_archiver;-- l'application : ajoute, recherche, vérifie (audit.verify)grant select, insert on "audit"."audit_entries" to app;grant select, insert, update on "audit"."audit_chains" to app;grant select on "audit"."audit_archives" to app;-- l'archive (audit.archive) : la tête de chaque chaîne verrouillée, l'archive enregistrée, les entrées qu'elle couvre retiréesgrant select, delete on "audit"."audit_entries" to audit_archiver;grant select, update on "audit"."audit_chains" to audit_archiver;grant select, insert on "audit"."audit_archives" to audit_archiver;L'application ne peut alors ni réécrire ni retirer une entrée, ni désactiver ou supprimer la garde.
Il reste le rôle propriétaire et le superutilisateur, et c'est à cela que sert l'ancrage. L'archive
s'exécute dans un processus à part, connecté en audit_archiver : dans un projet généré,
JOB_AUDIT_ARCHIVE_ENABLED=false pour l'application et un processus à vous qui exécute
ArchiveAuditEntries sur un journal ouvert avec le DATABASE_URL de ce rôle. Une application qui
exécute elle-même audit.archive, le défaut d'un projet généré, détient aussi select, insert on audit_archives et delete on audit_entries.
La garde laisse passer un seul DELETE : celui d'une entrée qu'une ligne de audit_archives
couvre, que archiveBefore écrit dans la même transaction. Un rôle qui peut à la fois insérer dans
audit_archives et supprimer de audit_entries peut donc laisser partir des entrées derrière une
ligne de son cru. Une telle ligne reste, les archives n'acceptant que l'ajout, et
verifyTrail(trail, { files }) relit le fichier de chaque archive de chaque chaîne et le
prouve avec verifyArchive : une ligne sans son fichier, ou dont le fichier ne la prouve pas, est
la rupture de sa chaîne (missing-entry, ou altered-content, à la première séquence qu'elle
nomme). Le audit.verify nocturne d'un projet généré avec un stockage de fichiers le fait. Gardez
ces deux privilèges au rôle qui archive.
Un nouveau store passe la même suite que ceux-ci :
import { auditTrailContract } from '@ddd-ts-kit/audit/testing';auditTrailContract({ describe, it, expect, beforeEach }, { name: 'MyAuditTrail', createTrail: () => freshTrail(), tamper, cut });tamper et cut font ce que ferait quelqu'un qui a accès au stockage, réécrire une entrée ou
retirer la fin d'une chaîne ; sans eux, la suite le vérifie sur ce qu'elle a lu. Un stockage qui
archive passe aussi archivableAuditTrailContract, avec les mêmes createTrail et cut : la tête
de chaque chaîne (chainHeads), l'archive des entrées plus anciennes qu'une date
(archiveBefore), sa ligne (archivesOf), et une vérification qui va de la dernière archive à la
tête.
Interroger le journal
Section intitulée « Interroger le journal »const page = await reader.search( { tenantId: 'acme', actorId: 'ada', category: 'authorization', outcome: 'denied', from, to }, cursorPage({ limit: 50, sort: [{ field: 'occurredAt', direction: 'desc' }] }),);Filtres : actorId, resource ({ type, id? }), action, category, outcome, période
(from inclus, to exclu), correlationId, tenantId, chain, fromSequence,
toSequence. La pagination utilise les types du noyau : une page par offset renvoie total, une
page par curseur nextCursor. Triez par occurredAt (puis par chaîne et par séquence, l'ordre
dans lequel une personne lit) ou par sequence (chaîne par chaîne, l'ordre de la vérification).
AuditReader est un port à part parce que lire le journal est en soi un acte sensible. Exposez-le
comme un cas d'usage comme un autre, ce qui le rend protégé et audité par les mécanismes
ci-dessus :
import { AuthorizedQuery, type AuditEntry, type Page } from '@ddd-ts-kit/kernel';
export class SearchAuditEntriesQuery extends AuthorizedQuery<Page<AuditEntry>> { /* actor, tenantId, filter, page */ }
// autorisation : refus par défaut, une seule permission, signalée comme sensiblerequires(SearchAuditEntriesQuery, auditPermissions['trail.read']);auditDecisions(trail, { ...source, sensitivePermissions: ['audit:trail.read'] });auditMiddleware(trail, { ...source, queries: [SearchAuditEntriesQuery] });import { AuditReader, type AuditEntry, type Page } from '@ddd-ts-kit/kernel';import { QueryHandler } from '@ddd-ts-kit/kernel/declarations';
@QueryHandler(SearchAuditEntriesQuery)export class SearchAuditEntriesHandler { constructor(private readonly reader: AuditReader) {}
execute(query: SearchAuditEntriesQuery): Promise<Page<AuditEntry>> { return this.reader.search({ ...query.filter, tenantId: query.tenantId }, query.page); }}Quiconque lit le journal y laisse une entrée. Le gestionnaire dépend de l'AuditReader du noyau,
que application/ a le droit d'importer, et reçoit le store qui lui est lié. Il restreint le
filtre au tenant de l'acteur (un périmètre d'accès calculé par l'authorizer) : un tenant ne
liste donc jamais les entrées d'un autre.
Dans un projet multitenant, liez new TenantAuditReader(store, executionScope) à AuditReader
plutôt que le store lui-même : chaque recherche est alors restreinte au tenant du travail, quoi
que dise son filtre (un filtre qui nomme un autre tenant ou une autre chaîne ne trouve rien),
l'équipe de la plateforme ne lit à travers les tenants que sous une élévation (acrossTenants
du noyau, elle-même enregistrée), et un travail qui ne nomme ni l'un ni l'autre est refusé
(NoCurrentTenantError).
- PostgreSQL seulement pour les stores SQL : verrous de ligne, comparaison de lignes pour les
curseurs,
jsonb, triggers. Une autre base de données est un autre adaptateur des deux ports, tenu à la suite de contrat. - Les ajouts à une chaîne sont sérialisés : deux unités de travail d'un même tenant écrivent leurs entrées l'une après l'autre. Dans une unité de travail, la tête n'est prise qu'à la validation, l'attente dure donc une validation, pas le travail ; dans une transaction ouverte à la main hors de toute unité de travail, la tête reste verrouillée de l'ajout à la fin de cette transaction.
- Une unité de travail annulée libère ses positions : l'entrée suivante réutilise la séquence. Il n'y a jamais de trou, et jamais d'entrée pour un travail qui n'a pas été validé.
- Une commande envoyée depuis une autre unité de travail (un consommateur dont
consumeen a ouvert une) partage son sort : si cette transaction englobante est annulée, l'entréefailedpart avec elle. - La chaîne prouve l'intégrité, pas l'exhaustivité de la capture : un fait qui n'a jamais
atteint une source (un script qui écrit dans la base de données, une route qui contourne le bus)
n'y est pas. Garder chaque route sur le bus, c'est à cela que servent
authz/declaredet les règles de dépendance. occurredAtest l'horloge de l'instance qui a enregistré ; dans une chaîne, l'ordre est la séquence.- La vérification lit la plage en mémoire, et fait confiance à l'entrée qui précède
from. - Archiver déplace, n'efface pas : combien de temps les fichiers d'archive sont gardés est une décision du projet, tout comme le verrou de conservation du stockage qui les garde. La recherche dans le journal ne lit pas les archives.
- drizzle enveloppe les erreurs du pilote et affiche les paramètres de l'instruction en échec dans
le message de son erreur. L'entrée d'une insertion d'audit ne contient que des identifiants et
des codes ; journalisez tout de même le
coded'une telle erreur, pas son message.