
Documentation
Résumé. Cette page est l'index de la documentation de fond de ddd-ts-kit. Quatre entrées sont normatives, à commencer par deux documents de référence courts : la référence d'architecture (l'arborescence canonique, les identifiants de règle, les conventions tactiques et de clean code, les niveaux de test) et la référence de configuration ; puis le README du pipeline (les portes de qualité) et le README de chaque package. Tout le reste explique et enseigne : les concepts derrière les règles, les décisions d'outillage avec leurs comparaisons et leurs limites, et des guides pour travailler sur un tel projet en équipe et avec des agents de code. Quand une page d'ici et la référence d'architecture divergent, la référence a raison.
En français. Chaque page listée ici a sa traduction française à côté d'elle (X.fr.md),
à laquelle mène le lien de sa première ligne ; cet index est celui de la documentation en
français. Ses diagrammes portent des libellés en français, et ses exemples de code sont
compilés par le pipeline comme ceux de l'anglais.
Sur le web. Ces pages, le README de chaque package et les documents de l'exemple sont aussi publiés sous la forme d'un site, avec une recherche, en français et en anglais : https://ddd-ts-kit.github.io/ddd-ts-kit/fr/. Les fichiers Markdown d'ici restent sa seule source.
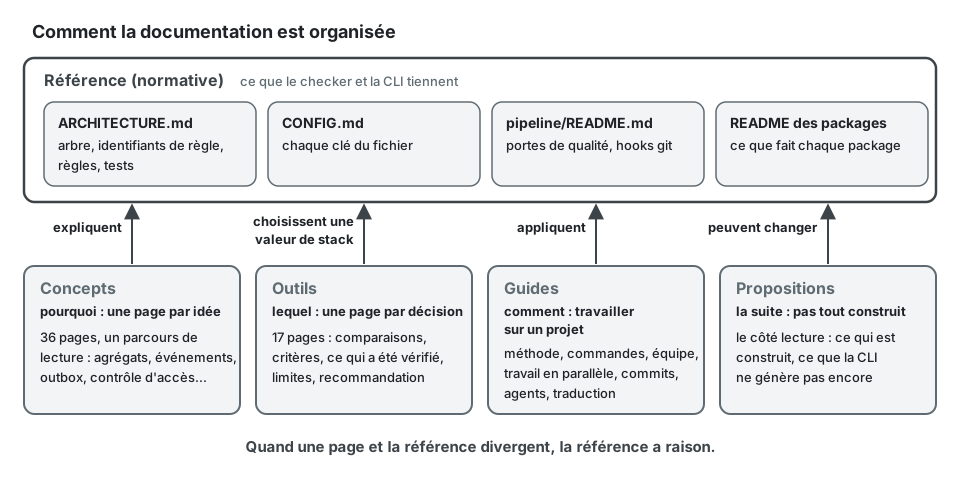
Référence (normative)
Section intitulée « Référence (normative) »| Page | Ce qu'elle contient |
|---|---|
| Référence d'architecture | l'arborescence canonique, chaque identifiant de règle, les règles tactiques, les tests, le clean code |
| Configuration | chaque clé de ddd-ts-kit.config.json |
| Versions et stabilité | ce que peut contenir une version corrective ou mineure avant 1.0, les plages que tient un projet, la mise à jour, ce que garantira 1.0 |
| Lignes laissées hors de la mesure de couverture | les vérifications que rien n'atteint, pourquoi, et quand chacune part |
Entrées de cached par locataire |
pourquoi cached range une entrée sous le locataire, lève sans la portée et saute une élévation |
| Le magasin de tuples en mémoire refuse la production | ce que createTupleStore permet, ce que fait un NODE_ENV absent, et ce qui l'inverserait |
| La garde du profil régulé n'exécute aucun programme du projet | comment le profil est lu, pourquoi pas de denyWrite, et les vérifications dont le profil se prive |
| Un refus est une erreur d'emblée avant la 1.0 | ni transition, ni alias, ni cale avant la 1.0 ; une rupture arrive avec une ligne To move |
| La garde réglementée ne lance git qu'à sa racine | le seul dépôt où la garde lance git sous le profil réglementé, et ce qu'elle laisse sans lecture |
| La garde nomme les lecteurs de VS Code | les outils de VS Code qui n'écrivent rien, et pourquoi une liste de lecteurs et non d'écrivains |
| Un store de modèle de lecture sur OpenSearch | chaque choix de @ddd-ts-kit/opensearch, et ce qui le défait |
| init câble OpenSearch | init --search opensearch : la stratégie de locataires, le provisionnement des stores déclarés, pas encore de générateur, et ce qui défait chaque choix |
| Pipeline | les portes de qualité, les hooks git, GitHub et GitLab côte à côte |
README des packages sous packages/ |
ce que fait chaque package, ses limites et ce qui a été vérifié |
Concepts : une page par idée
Section intitulée « Concepts : une page par idée »Ordonnées en parcours de lecture dans concepts/README.fr.md.
| Page | En une ligne |
|---|---|
| Domaine et sous-domaines | cœur, de soutien, générique : comment classer et ce que cela change |
| Contexte délimité | ce qu'est une frontière, et les tests du langage, de l'autonomie et de la cohérence |
| Modules du modèle | un contexte trop grand pour être lu, divisé en parties d'un seul modèle (Evans), pas en sous-contextes : les gains, les limites, comment les adopter |
| Langage omniprésent | la règle du glossaire d'abord, et comment s'écrit un glossaire |
| Carte des contextes | les patrons de relation, quand chacun convient et ce qu'il coûte |
| Carte des contextes : un exemple complet | l'application de planification, de l'expression des besoins à sa carte |
| Entités et objets-valeurs | l'identité contre la valeur, et l'obsession des primitives |
| Agrégats | frontière de cohérence, une transaction, référence par identifiant, dimensionnement |
| Briques du domaine | événement du domaine, service du domaine, repository, fabrique |
| Machines à états | le cycle de vie d'un agrégat : états, transitions, gardes, refus, son diagramme |
| Invariants, permissions, validation | trois choses différentes à trois endroits |
| Modèle anémique | comment en reconnaître un, et quand un modèle mince convient |
| Les couches et la règle de dépendance | hexagonale, en oignon, clean : ce qu'elles partagent, où elles diffèrent |
| Ports et composition | les ports en classes abstraites, la racine de composition, le câblage déclaré ou explicite |
| La couche de présentation | une classe de contrôleur par route, les groupes de routes, les gardes en bordure et les permissions sur le cas d'usage, mapper et sérialiseur |
| Représentations, accès aux champs et formulaires | un seul schéma en JSON, XML ou CSV par négociation de contenu, des champs réservés à une permission, des formulaires décrits par le serveur pour chaque appelant |
| CQRS | bus de commandes et bus de requêtes, et l'event sourcing comme choix séparé : ce qu'il apporte et ce qu'il n'apporte pas |
| Monolithe modulaire | un seul déployable, des contextes gardés extractibles |
| Événements du domaine et d'intégration | les deux sortes d'événements et la traduction entre elles |
| Outbox transactionnelle | le problème de la double écriture, l'outbox, les stratégies de relais |
| Livraison et idempotence | au moins une fois, consommateurs idempotents, ordre |
| Cohérence à terme | expliquée à une personne du produit |
| Sagas et gestionnaires de processus | les processus longs : ce que le kit fournit et ce qu'il ne fournit pas |
| Versionnement des événements | faire évoluer un événement publié |
| Event sourcing, par agrégat | quand garder un agrégat sous forme de ses événements, ce que cela coûte, upcasters, crypto-effacement (crypto-shredding), projections alimentées par le magasin, y migrer et en revenir |
| Les données personnelles dans un projet généré | ce qu'écrivent init --privacy on et generate repository --personal, l'effacement et l'export d'une personne de bout en bout, les deux modes d'effacement, la conservation purgée chaque nuit, le registre généré par docs, les règles privacy/*, ce qui reste hors de portée et ce que l'outil ne décide pas |
| Authentification et autorisation | RBAC, ABAC, ReBAC comparés, avec une table de décision |
| L'autorisation en pratique | @Requires, le middleware du bus, le port Authorizer et les politiques, suivis à travers une seule commande |
| Acteur et portée d'exécution | l'acteur explicite, et ce que porte chaque unité de travail |
| Multitenance | le tenant de la bordure au stockage : stratégies d'isolation, propagation, élévation du personnel de la plateforme, la preuve |
| Journal d'audit | un historique où toute altération se voit (tamper-evident), enregistré autour des cas d'usage |
| Observabilité | traçage, journaux, métriques, remontée des erreurs, l'identifiant de corrélation |
| Résilience | nouvelle tentative, délai d'expiration, disjoncteur, cloison, cache et leurs modes de défaillance |
| Cache HTTP | quoi mettre en cache à quelle couche, les politiques de cache, jamais une décision d'autorisation partagée entre acteurs |
| Stockage de fichiers | les fichiers dans un stockage, jamais dans la base : déposés avant la transaction, déplacés vers leur clé avec la validation, servis par des liens signés courts |
| Jobs planifiés | des jobs qui déclenchent des cas d'usage, plusieurs instances, idempotence |
| Jobs en arrière-plan | du travail mis en file dans la transaction d'une commande, exécuté au moins une fois par un worker, baux, points de reprise |
| Import et export de fichiers | une conception, pas construite : un gros fichier lu ou écrit par un job en arrière-plan, lot par lot, entre la file d'attente et le stockage de fichiers |
| Clean code | nommage, petites fonctions, ordre de lecture descendant (stepdown), commentaires, avec un avant et un après |
| Stratégie de test | fakes contre mocks, builders, tests de contrat, les quatre niveaux |
Outils : une page par décision
Section intitulée « Outils : une page par décision »Chaque page a une table de comparaison, des critères de choix, ce que le kit prend en charge et a vérifié, les limites, et une recommandation selon la situation.
| Page | La décision |
|---|---|
| Frameworks HTTP | Express, Fastify, Hono ou NestJS, et ce que coûtent des routes indépendantes du framework avec Nest |
| Validation | zod, class-validator, TypeBox ou une bibliothèque Standard Schema ; les schémas partagés |
| Paires de contrat | quel framework avec quelle bibliothèque de validation, selon l'équipe : les quatre paires prouvées de bout en bout, mesurées ; oRPC et tRPC comme seconde porte, pas comme paire |
| Représentations et formulaires | XML et CSV sans bibliothèque, et pourquoi ; les moteurs de rendu JSON Forms pour React, Angular et Vue, et les alternatives |
| Injection de dépendances | les déclarations du kit sur tsyringe, InversifyJS ou Awilix, NestJS, ou un câblage manuel, comparés et mesurés |
| Persistance | Drizzle, Knex, Prisma ou TypeORM ; PostgreSQL face aux autres ; un modèle de lecture sur OpenSearch |
| Modèles de lecture de recherche | un modèle de lecture sur OpenSearch : ce qui convient et ce qui ne convient pas, init --search opensearch, le store d'un contexte, ses tests, ses locataires, en production |
| Brokers de messages | en processus, RabbitMQ, Kafka, NATS JetStream ou Redis Streams |
| Cache et coordination | Redis, Dragonfly ou Valkey ; ce que le verrou garantit et ne garantit pas |
| Caches HTTP | Varnish, Souin, nginx, Fastly, Cloudflare ou Bunny devant l'API : comment chacun purge par étiquette, ce que le kit a vérifié |
| Connecteurs de stockage de fichiers | mémoire, répertoire local ou compatible S3 (AWS, MinIO, OVHcloud, Scaleway, R2) ; comment en écrire un pour Google Cloud Storage ou Azure |
| Identité | Keycloak, ou OIDC et JWT simples |
| Moteurs d'autorisation | modèles en processus face à OpenFGA, SpiceDB, Cedar, OPA |
| Observabilité | OpenTelemetry avec Jaeger ou Tempo ; les loggers ; Sentry ou GlitchTip |
| Analyse statique et pipeline | le checker, le plugin ESLint, dependency-cruiser, knip, TypeScript 6 et 7 ; GitHub ou GitLab |
| Socle de qualité | ce que reçoit chaque projet et ce à quoi répond chaque outil : vérification de types, lint, formatage, code mort, graphe des imports, contrôle d'architecture, tests |
| Lanceurs de tests | Vitest ou Jest |
| SDK client | openapi-typescript avec openapi-fetch, hey-api ou orval, mesurés sur le contrat de l'exemple, face au client qu'écrit ddd-ts-kit sdk : codes d'erreur typés, aucune dépendance ; comment il est vérifié et publié |
| Alias d'import | @/, déclaré une fois sous les paths de tsconfig et réécrit en chemins relatifs par le build ; des imports sans extension par défaut, et pourquoi le build écrit le .js dont Node a besoin ; pourquoi pas un import de sous-chemin Node ; ce que lit chaque outil |
| Page | Pour |
|---|---|
| Méthodologie | le chemin complet d'une expression des besoins jusqu'au code qui tourne, étape par étape : le chemin pris en charge |
| Quelle commande, quand | la commande ou la skill de chaque moment d'un projet, une première fonctionnalité en partant de zéro, et la référence de chaque commande et de chaque option |
| Une tranche, de bout en bout | la requête HTTP POST /orders à travers les quatre couches d'une tranche générée, et son code de domaine et d'application une fois rempli |
| Le plugin pour agents de code | installer le plugin dans Claude Code, Codex et Copilot, ses vingt-six skills, ses six agents et son hook, et ce que chaque hôte exécute |
| Composer le kit avec d'autres outils | le kit dans un workspace Nx et à côté de Superpowers, à partir de vraies sessions : un seul projet Nx pour le projet du kit, ce qu'il faut contourner, quel outil signale quel import, deux jeux d'instructions pour agents ; quel plugin conduit une fonctionnalité, un plan, un test et un bug, et la section d'AGENTS.md qui en décide ; Spec Kit et BMAD sur tout un parcours chacun, et les documents que chacun écrit à côté de ceux du kit |
| Travail en équipe | la propriété par contexte, le glossaire, les contrats d'abord, la revue, les décisions, l'arrivée d'un nouveau membre |
| Travail en parallèle | plusieurs personnes ou agents à la fois : ce qui est sûr, ce qui est séquencé, un plan concret |
| Parcours d'une story | une session par user story, une story par terminal : les questions d'abord, la revue de conception et les tests d'acceptation avant le code, un rapport de chaque décision provisoire |
| Boucler la boucle | d'une métrique sortie de sa bande à la prochaine story : les requêtes sur les métriques que le kit émet, un bands.yaml à trois paliers, ce qu'il faut à une exécution sans état, le compte rendu d'incident d'où part une story de correction, ce qui arrive d'un canal de discussion |
| Discipline de commit | la taille d'un commit et d'une pull request, les fichiers générés, ce que les hooks et la CI imposent |
| Un gestionnaire aux nombreuses dépendances | la surinjection par le constructeur lue comme une odeur : un ordre de diagnostic, chaque remède avec sa place dans l'arborescence, aucune limite |
| Un cycle entre deux contextes | trois questions avant de fusionner : un langage ou deux, un événement pour un sens, un concept manquant |
| Quand extraire des microservices | les signaux, les coûts, une liste de préparation, les étapes, quand refusionner |
| Démarrer avec des contextes bien conçus | un contexte générique écrit en entier avec --preset identity : ce qu'il écrit, ce qu'il demande à la stack, comment il se compose avec chaque modèle d'accès et avec les tenants |
| Choisir le contrôle d'accès | cinq questions qui choisissent les rôles, les attributs ou les relations (Zanzibar), des préréglages commentés pour chacun, le modèle combiné de l'exemple, les périmètres et les refus en bordure |
| Économie de jetons | dépenser moins de jetons avec les agents de code, et des outils complémentaires |
| Isoler les agents de code | ce qui charge une machine et ce que fait le kit ; plafonner un agent, le bac à sable de l'agent, NVIDIA OpenShell pour la sécurité d'une session |
| Déployer et revenir en arrière | ce qu'un projet livre au-delà de son image, l'ordre d'une mise en production, ce que signifie revenir en arrière pour chaque pièce, trois niveaux d'autonomie d'un agent par environnement, déployer, lire l'état et revenir en arrière en un script chacun, la répétition en préproduction |
| La documentation en français | contributeurs : comment chaque page garde sa traduction française à jour, le glossaire, le style des diagrammes, les exemples de code que le pipeline compile |
Propositions
Section intitulée « Propositions »| Page | Statut |
|---|---|
| Quels contextes méritent un preset | les critères, puis notification ensuite, les demandes sur les données personnelles comme guide ; fichiers (une capacité de la plateforme), audit, facturation et réglages non |
| Des modules à l'intérieur d'un contexte délimité | construit : les sous-contextes ne sont pas un concept des références, les modules du modèle le sont (Evans) ; le jugement de ses gains et de ses limites, et l'essai qui a mesuré le coût sur l'exemple |
| Le côté lecture | critères, représentations, formulaires, modèles de lecture et projections ; la page dit, partie par partie, ce qui est construit dans les packages d'exécution, ce que la CLI ne génère pas encore et ce qui n'est pas construit |
| Vélocité du build, des contrôles et des tests | étudié, non construit : où vont le temps et la mémoire de ce dépôt, sur une station de travail et dans le pipeline ; les leviers de Vitest, ESLint, Oxlint, du compilateur natif et des gestionnaires de packages mesurés sur cet arbre ; ce que d'autres équipes ont publié sur les orchestrateurs, la sélection de tests et GitHub Actions ; un plan dans l'ordre du gain par coût, et pourquoi aucun orchestrateur ; les outils du projet oxc (Oxlint, Oxfmt, tsdown, oxc-transform, la transformation Oxc de Vitest) mesurés le 2026-10-26, avec un verdict pour chacun et le plan de leur adoption |
| Les familles qui génèrent des projets | étudié, une ligne construite, puis les leviers que le mainteneur a décidés le 2026-10-26 : ce que coûtent les jobs du pipeline qui génèrent des projets, par exécution et par jour, sur une pull request, sur le tronc et la nuit (70 % d'une exécution de pull request), ce qu'ils répètent, neuf leviers avec leur gain et ce qu'une pull request ne prouverait plus, et un plan de pull requests dans l'ordre du gain par effort |
| La protection des données dès la conception, au-delà de l'event sourcing | construite, chaque partie : pourquoi le kit, qui n'effaçait que les valeurs personnelles des événements stockés, déclare désormais les champs personnels une fois et les lit dans des ports avec un adaptateur par ORM (effacement, export, conservation), des générateurs, un registre et des règles privacy/* ; les pull requests dans l'ordre de fusion, l'exemple qui adopte les ports ; ce qu'un outil ne peut jamais garantir et les mots à employer |
| Un second exemple, la gestion des dépenses sur la pile la plus populaire | spécifié, non construit : NestJS, Prisma, Jest, Kafka, S3, ABAC sur un métier d'argent et de workflows ; d'abord les quatre capacités que cette pile éteint aujourd'hui (file et processus sur Nest, tenancy et audit sur Prisma, le preset identity), puis l'exemple comme preuve ; MySQL laissé de côté, avec ce qu'il faudrait |
| Où mener le kit, d'après ce que font les outils voisins | proposé, non construit : seize outils voisins lus le 2026-10-25 (méthodes pour agents, plugins DDD, outils de frontières d'import, briques CQRS et event sourcing), neuf propositions notées par valeur, coût et pertinence, en paliers (maintenant, ensuite, plus tard), et ce que la comparaison suggère et que le kit ne devrait pas faire, avec la raison |
Partir d'une question
Section intitulée « Partir d'une question »| Votre question | Où se trouve la réponse |
|---|---|
| Où va ce fichier, et que peut-il importer ? | la référence d'architecture, 2. Arborescence canonique et 3. Règles de dépendance |
| Pourquoi ceci a-t-il été signalé, et comment le corriger ? | npx ddd-ts-kit explain <rule-id>, puis Quand quelque chose est refusé |
| Quelle commande, ou quelle skill, maintenant ? | Quelle commande, quand |
| Cette règle va-t-elle dans l'agrégat, le gestionnaire ou le schéma ? | Invariants, permissions, validation |
| Pourquoi le générateur refuse-t-il mon nom ? | Langage omniprésent : un nom vient du glossaire de son contexte |
| Comment un contexte réagit-il à un autre ? | Événements du domaine et d'intégration, puis Outbox transactionnelle |
| Comment tester un gestionnaire sans mock ? | Stratégie de test |
Quelle valeur pour une clé de stack ? |
la page d'outils de la décision, puis Configuration |
| Une règle ne convient pas à ce projet | Dérogations : une décision enregistrée, jamais un off silencieux |
| Qu'est-ce qui change après une mise à jour du kit ? | Versions et stabilité, Migrer après une mise à jour du kit et une clé absente de stack |
Une partie de la référence répond aussi dans le terminal d'un projet, depuis la version installée du kit, si bien qu'elle ne contredit jamais le code que vous exécutez :
npx ddd-ts-kit rules # chaque identifiant de règle, sa sévérité et ce qu'elle tientnpx ddd-ts-kit explain imports/alias-only # pourquoi une règle existe, un mauvais et un bon exemple, comment la désactivernpx ddd-ts-kit generate --help # chaque sorte de fichier qu'écrit le générateur, et ses optionsnpx ddd-ts-kit describe billing # un contexte sous forme de faits : cas d'usage, routes, événements, portsOrdre de lecture suggéré
Section intitulée « Ordre de lecture suggéré »Débutant en DDD. Suivez dans l'ordre le parcours de lecture de concepts/README.fr.md, au moins les sections 1 et 2, puis :
- Les couches et la règle de dépendance
- Événements du domaine et d'intégration et Cohérence à terme
- Stratégie de test
- Méthodologie, pour voir les idées sous forme d'étapes
- la référence d'architecture, qui se lira alors comme un résumé
Responsable technique qui adopte le kit.
- le README racine et la référence d'architecture
- Méthodologie
- les pages d'outils des décisions que vous avez à prendre, en commençant par Persistance, Brokers de messages et Analyse statique et pipeline
- Monolithe modulaire et Quand extraire des microservices
- Travail en équipe, Travail en parallèle, Discipline de commit
- Économie de jetons, si l'équipe travaille avec des agents de code
- Configuration
- Les données personnelles, avant la production : ce qui est déclaré, effacé, exporté et purgé, et ce qui reste la décision du responsable de traitement
Contributeur au kit.
CONTRIBUTING.mdà la racine, puis la référence d'architecture : un changement de règle commence là- Ports et composition et Les couches et la règle de dépendance
- le README du package que vous changez, et ceux de la CLI et du plugin ESLint, qui portent les règles
- Analyse statique et pipeline et Stratégie de test
- la page d'outils du domaine que vous touchez : elle dit ce qui a été vérifié et ce qui ne l'a pas été, et c'est là qu'une contribution est la plus utile
- La documentation en français, avant de changer une page : sa traduction française change dans la même pull request