
Les données personnelles dans un projet généré
Résumé. Un projet généré sait lesquelles de ses colonnes tiennent des données personnelles, et
efface une personne de toutes d'une seule commande. init écrit le dossier privacy de la
plateforme (--privacy on, le défaut avec un ORM) : les listes des copies et des exports que chaque
contexte déclare, et les scripts privacy:erase et privacy:export. generate repository <context> <Aggregate> --personal <colonne>,... déclare ce qu'une table garde d'une personne, à côté de son
mapper, et écrit une fois par contexte l'effacement et l'export qui lisent chaque déclaration :
deux ports, leurs adaptateurs sur ceux du paquet d'ORM, leurs fakes, une spec et leurs lignes
dans les copies et les exports de la plateforme. Avec --event-sourcing on, la clé de la personne dans l'event store est détruite d'abord,
pour que ses événements stockés se lisent effacés. Ce sont les mécanismes de la protection des
données dès la conception, intégrés par défaut ; ce qu'un outil ne peut pas décider, la base légale
d'un traitement ou la complétude d'une déclaration, reste au projet, et cette page le dit. Les pièces
du kit sur lesquelles cette page repose : Event sourcing
pour le scellement des événements stockés, Journal d'audit
pour la preuve datée, Multi-tenant pour ce qu'un tenant confine.
Ce qu'un projet généré contient
Section intitulée « Ce qu'un projet généré contient »| Écrit par | Quoi | Où |
|---|---|---|
init --privacy on (on avec un ORM, off sans ou sur demande) |
les listes des copies et des exports que les contextes déclarent, la liste des événements qui portent des données personnelles (personal-events.ts, écrite par docs), runErasure, runExport et runPurge, le job de nuit privacy.purge-expired, les trois scripts |
src/platform/privacy/, scripts/privacy-erase.ts, scripts/privacy-export.ts, scripts/privacy-purge.ts |
init --event-sourcing on (off sauf demande) |
l'event store, les clés des personnes concernées et le chiffre qui scelle une valeur personnelle d'un événement stocké, audités quand le journal est actif | src/platform/event-sourcing/, le schéma event_store |
generate repository <ctx> <Aggregate> --personal <colonne>,... |
les colonnes dans le stockage, leur déclaration, et une fois par contexte l'effacement et l'export qui la lisent | le contexte |
generate personal-fields <ctx> <table> --personal <colonne>,... --subject <colonne> |
la déclaration d'une table qu'aucun agrégat ne possède, jointe à l'effacement et à l'export du contexte, ou écrite avec eux | le contexte |
Un projet sans donnée personnelle prend --privacy off et ne paie rien ; un projet dont tous les
agrégats sont des lignes garde --event-sourcing off et ne paie aucune table pour cela. Les deux
sont enregistrés dans la configuration (stack.privacy, stack.eventSourcing) et changés plus tard
par init --force (CONFIG.fr.md).
Déclarer ce qu'une table garde d'une personne
Section intitulée « Déclarer ce qu'une table garde d'une personne »npx ddd-ts-kit generate repository billing Customer --personal email,display_namenpx ddd-ts-kit generate repository billing Invoice --personal customer_email --subject customer_id --erasure rowLa première commande déclare que la table customers garde l'email et le nom affiché de la personne
dont la ligne parle, nommée par son id : un effacement les pseudonymise, la ligne reste et chacun
se lit [erased]. La seconde déclare que la table invoices copie l'email d'un client, nommé par
customer_id, et qu'un effacement supprime ces lignes. Chaque commande :
- ajoute les colonnes à la table et au type de ligne de l'agrégat, en texte nullable ; le mapper
les écrit vides, avec une note, tant que l'agrégat ne les porte pas (un objet-valeur
Email, un champ de l'état) ; - écrit la déclaration
infrastructure/persistence/<agrégat>.personal-fields.tsà côté du mapper, avecpersonalFieldsdu kernel, épelée comme l'effacement de l'ORM la lit : les noms SQL sur Knex et Prisma, les propriétés de la définition sur Drizzle et TypeORM ; - la première fois dans un contexte, écrit son effacement : le port
application/ports/<contexte>-personal-data-erasure.port.ts, une classe abstraite qui étendPersonalDataErasuredu kernel ; l'adaptateurinfrastructure/persistence/<orm>-<contexte>-personal-data-erasure.repository.ts, qui étend l'effacement du paquet d'ORM (KnexPersonalDataErasure,DrizzlePersonalDataErasure,PrismaPersonalDataErasure,TypeOrmPersonalDataErasure) avec les déclarations du contexte, confiné au tenant du travail quand le repository l'est ; son fake ; une spec qui enregistre deux personnes par le repository, écrit leurs colonnes personnelles et prouve l'effacement et l'export sur la base de test ; et sa liaison, le décorateur@Repositoryen style déclaré, le fichier module d'un contexte explicite, la fabrique d'une plateforme câblée à la main ; - la première fois dans un contexte aussi, écrit son export : le port
application/ports/<contexte>-personal-data-export.port.ts, qui étendPersonalDataExportdu kernel ; l'adaptateurinfrastructure/persistence/<orm>-<contexte>-personal-data-export.repository.ts, qui étend l'export du paquet d'ORM (KnexPersonalDataExport,DrizzlePersonalDataExport,PrismaPersonalDataExport,TypeOrmPersonalDataExport) avec les mêmes déclarations, confiné au tenant de la même façon ; son fake ; lié de la même façon ; - liste les deux ports une fois, dans
src/platform/privacy/data-subject-copies.tsetdata-subject-exports.ts, entre les marqueurs ;init --forceles liste de nouveau quand il réécrit les fichiers ; - une table ultérieure du même contexte rejoint les
declarationsdes deux adaptateurs, entre marqueurs.
// infrastructure/persistence/customer.personal-fields.ts, tel que généré sur Knexconst TABLE = { schema: BILLING_SCHEMA, table: 'customers' };
const declaration: PersonalFieldsOptions<CustomerRow> = {  subject: 'id',  fields: ['email', 'display_name'],  erasure: 'pseudonymise',};
export const CustomerPersonalFields = personalFields(TABLE, declaration);
La colonne du sujet nomme la personne concernée dont une ligne parle, un identifiant opaque : id
quand la ligne est la personne, la colonne qui tient l'id de la personne sinon. Elle n'est jamais une
donnée personnelle elle-même, et le générateur refuse un sujet listé dans --personal. Les colonnes
sont données par leur nom SQL, lettres minuscules, chiffres et tirets bas ; une colonne que la table
générée garde pour elle (id, version, tenant_id, les colonnes d'audit, le registered_at d'une table générée avant 0.100) est
refusée, comme un projet sans dossier privacy (init --force --privacy on) ou sans paquet d'ORM qui
livre l'effacement (--orm none, --orm custom).
Les deux modes, fixés par table :
--erasure |
Ce que lisent ensuite les lignes de la personne | Quand |
|---|---|---|
pseudonymise (le défaut) |
la ligne reste, chaque colonne personnelle de texte se lit [erased], toute autre colonne personnelle ne lit rien (elle doit accepter null) |
une ligne vers laquelle d'autres pointent, un fait du métier qui nomme la personne par un id opaque |
row |
les lignes de la personne sont supprimées | une pure copie de la personne, un contact, une entrée de carnet d'adresses |
Une table qu'aucun agrégat ne possède
Section intitulée « Une table qu'aucun agrégat ne possède »Un modèle de lecture, une table de messages reçus, une table écrite à la main dans le schéma du
contexte : chacune peut garder une copie d'une personne, et aucune n'a d'agrégat que
generate repository pourrait nommer.
npx ddd-ts-kit generate personal-fields billing payment_reminders --personal customer_email,customer_name --subject customer_idLa table est donnée par son nom SQL et doit exister dans le fichier de schéma du contexte :
<context>.schema.ts avec Drizzle et TypeORM, create-<context>-tables.schema.ts avec Knex,
prisma/schema/<context>.prisma avec Prisma. La commande :
- écrit
infrastructure/persistence/<table>.personal-fields.ts(payment-reminders.personal-fields.ts, qui exportePaymentRemindersPersonalFields), épelée comme l'effacement de l'ORM la lit : avec Drizzle et TypeORM par les propriétés que la définition de la table donne à ses colonnes, lues dans le fichier de schéma, avec Knex et Prisma par les noms SQL ; - la joint aux
declarationsde l'effacement et de l'export du contexte quand ils existent ; - sinon les écrit comme le fait la première table d'un contexte (ports, adaptateurs, fakes,
liaison, les lignes dans les copies et les exports de la plateforme). La spec diffère : aucun
repository ni builder n'écrit les lignes d'une telle table, donc
test/integration/<context>-personal-data.spec.tsprouve les fakes et nomme enit.todochaque cas à prouver sur la base de test (effacé pour la personne et laissé aux autres, exporté, purgé avec--retention), que vous écrivez avec des lignes insérées comme le projet écrit cette table.
Elle ne modifie jamais la table. Une colonne que --personal, --subject ou --retention nomme et
que la définition ne tient pas est refusée, avec les colonnes qu'elle a ; quand la définition prend
des colonnes ailleurs (une décomposition, une fonction appelée sur la table), la commande ne peut
pas le savoir, déclare la colonne et dit dans sa sortie de vérifier que la table la tient. Là où
l'effacement est confiné à un tenant (--tenant-scoped, ou un projet dont stack.tenancy n'est
pas none), la table doit tenir tenant_id aussi.
--subject est obligatoire ici. Dans une table sans agrégat la ligne est rarement la personne, et
un défaut à id ferait chercher la personne dans la mauvaise colonne par
npm run privacy:erase -- <personne> alors que le registre dit la table couverte. Ne donnez
--subject id que lorsque l'identifiant de la ligne est celui de la personne.
Refusés : une table que le schéma du contexte ne déclare pas (la commande liste celles qu'il
déclare), une table qui a déjà une déclaration (ajoutez la colonne à ses fields à la main), et
tout ce que --personal d'un repository refuse. generate repository <ctx> <Aggregate> --personal ...
lancée sur un agrégat dont la table existe est refusée aussi, le générateur déclarant une table une
seule fois : ajoutez les colonnes à la table à la main, puis déclarez-les avec
generate personal-fields.
L'effacement, de bout en bout
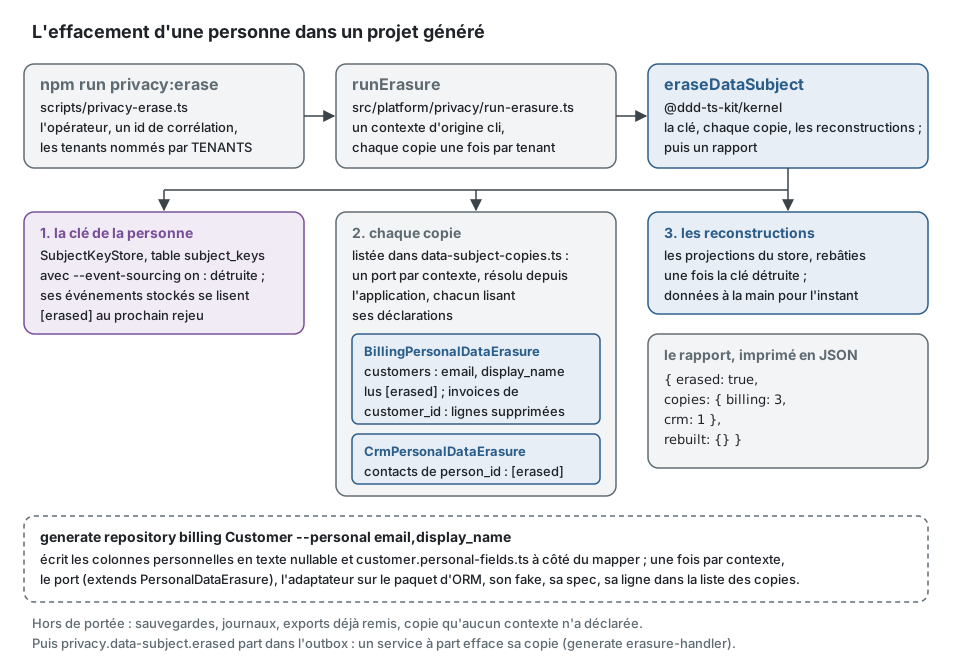
Section intitulée « L'effacement, de bout en bout »npm run privacy:erase -- <subject-id> [--operator <qui-demande>] [--rerun] tourne sur les sources avec les
variables de .env. Le script ouvre la persistance, compose l'application, ouvre un contexte
d'exécution d'origine cli avec l'opérateur pour acteur, et lance eraseDataSubject du kernel sur :
- la clé de la personne, quand le projet a un event store : détruite, pour que chaque événement
stocké de la personne se lise
[erased]au prochain rejeu, et auditée quand le journal est actif ; - chaque copie listée dans
data-subject-copies.ts, un port par contexte, résolu depuis l'application : chaque adaptateur efface ou pseudonymise les lignes de ses tables déclarées, dans le tenant du travail ; avec--tenancy shared-table, l'annuaire des tenants les nomme (les organisations du contexte d'identité quand le projet l'a, sinonTENANTS, séparés par des virgules) et une copie est jouée une fois par tenant, puisqu'une écriture de données de tenant n'est jamais élargie ; avec--audit on, chaque copie laisse une entréepersonal-data:eraseavec l'opérateur et le nombre de lignes,0compris, avec ou sans event store ; - ce que la plateforme garde de la personne dans des tables qu'aucun tenant ne confine, une fois :
dans chaque enregistrement de l'outbox qui nomme la personne, en attente, publié ou mort, les champs
que l'option
personalde son événement liste (platform.outbox, d'aprèspersonal-events.ts), et chaque job mis en file avec la personne poursubject, quel que soit son statut (platform.background-jobs) : un job en attente ne tourne jamais, un job en cours s'arrête à son prochain heartbeat. Chacun laisse aussi son entrée ; - les projections alimentées par le store, reconstruites une fois la clé détruite : données à la
main pour l'instant, là où le lanceur dit
TODO(platform).
Il imprime le rapport en JSON : si une clé a été détruite, les lignes que chaque contexte et la
plateforme ont atteintes, les projections reconstruites. Une copie ou une reconstruction qui échoue
n'arrête pas les autres, et le premier échec est levé une fois que tout a tourné : relancer l'effacement achève celui qui a
échoué à mi-chemin. Un effacement qui n'a rien atteint est refusé, code de sortie 1, et annoncé à
personne : l'id est mal saisi, son tenant manque à l'annuaire, ou la personne a déjà été effacée, et
les entrées du journal d'audit disent lequel. --rerun dit que c'est attendu : le code de sortie est 0
et l'effacement est annoncé de nouveau. Un sujet qui n'est pas un identifiant opaque (un nom, un email)
est refusé avant que quoi que ce soit ne soit touché.
Une fois chaque copie effacée, runErasure publie privacy.data-subject.erased par l'outbox
(dataSubjectErasedV1 du kernel, { subjectId, erasedAt } : l'id de la personne et de personne d'autre, l'opérateur restant dans le journal d'audit auquel mène son id de corrélation ; des identifiants
seulement), une fois par tenant avec des tables partagées ; le relais de l'application en marche
le livre. Un effacement qui a échoué ne publie rien, et le relancer le fait, avec --rerun quand il
ne reste rien à atteindre. C'est ainsi que l'article 19 porte au-delà de la base que tient la plateforme :
- un contexte extrait en service à part efface sa copie de son côté :
npx ddd-ts-kit generate erasure-handler <context>écrit le handler idempotent de l'événement sur l'effacement du contexte, sa spec sur le fake et son abonnement (le décorateur, le fichier module, ou la plateforme câblée à la main, dans une transaction derrière un broker). Dans le monolithe, la plateforme a déjà effacé cette copie, et le handler n'atteint rien : un effacement est idempotent. Un contexte dont les agrégats sont en event sourcing n'a pas de table et n'a pas besoin d'un tel handler : ses valeurs personnelles sont scellées parpersonalData(subjectId, value)et la clé détruite à l'étape 1 les efface dans tous les contextes à la fois ;generate erasure-handlerle refuse donc et le dit. Une projection qui garde une copie en clair est reconstruite une fois la clé détruite, et un effacement à une date du métier (une rétention de cinq ans après la fin de la relation) est un job planifié à vous qui appelle la même destruction de clé (Event sourcing) ; - un système hors du projet qui consomme les événements du projet, et a copié la personne depuis l'un d'eux, s'abonne au même type : le catalogue des événements et AsyncAPI le listent ;
- un événement d'intégration qui porte des données personnelles le dit (
personal: { subject, fields }surdefineIntegrationEvent) : le catalogue l'écrit sous la charge utile, AsyncAPI enx-personal-data, pour que chaque consommateur sache quelle copie il garde (@ddd-ts-kit/events).
Dans une spec de gestionnaire, le fake de l'effacement (Fake<Contexte>PersonalDataErasure)
compte les lignes qu'il tient d'une personne et les oublie au premier effacement, comme le fake d'un
repository.
L'export, de bout en bout
Section intitulée « L'export, de bout en bout »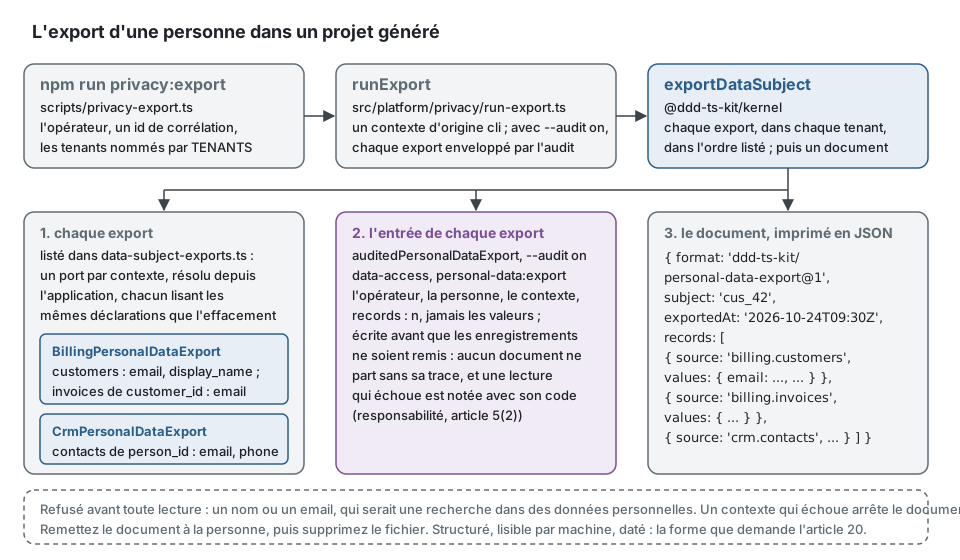
npm run privacy:export -- <subject-id> [--operator <qui-demande>] > export.json répond au droit
d'accès et à la portabilité (RGPD, articles 15 et 20) de la même façon : le script compose
l'application, ouvre un contexte d'exécution d'origine cli avec l'opérateur pour acteur, et lance
exportDataSubject du kernel sur chaque export listé dans data-subject-exports.ts, un port par
contexte, dans chaque tenant que l'annuaire liste avec des tables partagées (les organisations du contexte d'identité, sinon TENANTS), puisqu'une lecture de
données de tenant est confinée à son tenant comme une écriture. Chaque adaptateur lit les mêmes
déclarations que l'effacement et répond un enregistrement par ligne sur la personne, sous
<contexte>.<table>, avec les colonnes personnelles et les clés des fichiers en données simples,
aucune autre colonne et rien de personne d'autre ; une ligne déjà pseudonymisée se lit [erased], une
ligne supprimée ne répond rien. Avec --event-sourcing on, runExport remet aussi ce que l'event
store garde de la personne, par EventStorePersonalDataExport du kernel : un enregistrement par
événement qui porte une valeur scellée avec la clé de la personne, sous
platform.event-store.<type d'événement>, qui nomme son événement (stream, aggregateId,
version, occurredAt), chaque valeur ouverte et nommée par son chemin dans les données de
l'événement (reason, contacts[0]). Un flux porte le nom de son agrégat, pas celui de la
personne : cet export lit donc tout le store, par tours de 500 événements dans l'ordre de leurs
positions, dans chaque tenant ; le store valide ses ajouts dans cet ordre, si bien qu'un tour ne
manque aucun événement. Une valeur dont un effacement a détruit la clé a disparu et ne répond
rien ; une valeur qui ne se déchiffre pas est nommée dans unreadable, et l'export continue. Le
résultat est un document :
{ "format": "ddd-ts-kit/personal-data-export@1", "subject": "cus_42", "exportedAt": "2026-10-24T09:30:00.000Z", "records": [ { "source": "billing.customers", "values": { "email": "ada@example.org", "display_name": "Ada" } }, { "source": "billing.invoices", "values": { "customer_email": "ada@example.org" } }, { "source": "crm.contacts", "values": { "email": "ada@example.org", "phone": null } }, { "source": "platform.event-store.care.dossier.opened", "values": { "note": "Asthma" }, "event": { "stream": "care.dossier-d1", "aggregateId": "d1", "version": 1, "occurredAt": "2026-10-02T08:15:00.000Z" } } ]}Structuré, couramment utilisé et lisible par machine, comme le demande l'article 20 ; daté, pour que ce qu'il affirme soit vrai de cet instant ; nommé par son format, pour qu'un lecteur en connaisse la forme et distingue une forme ultérieure ; nommant la personne par le seul id opaque. Remettez-le à la personne, puis supprimez le fichier. Les exports tournent dans l'ordre listé, pour qu'un document se lise pareil d'une exécution à l'autre, et celui qui échoue arrête le rassemblement : un document auquel un contexte manquerait en silence affirmerait moins que ce que le système garde. Un sujet qui n'est pas un identifiant opaque est refusé avant toute lecture : un export cherche une personne par son id, jamais par un nom ou un email, ce qui serait une recherche dans des données personnelles.
Avec --audit on, runExport enveloppe chaque port avec auditedPersonalDataExport de
@ddd-ts-kit/audit : une entrée par contexte, catégorie data-access, action personal-data:export,
l'opérateur, la personne, le contexte et le nombre d'enregistrements, jamais les valeurs, écrite
avant que les enregistrements ne soient remis, pour qu'aucun document ne parte sans sa trace. C'est
la responsabilité de l'article 5(2) appliquée au droit d'accès : qui a lu quoi de qui, et quand
(Journal d'audit). Le journal
est en ajout seul : chaque exécution est une remise et laisse son entrée, un essai compris ; essayez
le script sur une personne de test, jamais sur une vraie.
Dans une spec de gestionnaire, le fake de l'export (Fake<Contexte>PersonalDataExport) remet les
enregistrements qu'un test lui a donnés et se souvient de qui a été demandé.
La conservation, chaque nuit
Section intitulée « La conservation, chaque nuit »npx ddd-ts-kit generate repository billing Customer --personal email,display_name --retention ended_at:36m--retention <colonne>:<n><d|m|y> dit combien de temps les lignes gardent la personne (RGPD,
article 5(1)(e)), compté depuis la fin de la relation avec la personne : une colonne à vous qui la
date, ended_at ci-dessus, qui rejoint le stockage en horodatage nullable, vide tant que la relation
dure ; une ligne dont la date est vide n'expire jamais. La déclaration gagne
retention: { after: 'ended_at', months: 36 }, et la spec générée prouve la purge sur la base de
test. Remplissez cette colonne quand la relation prend fin (le contrat clos, le compte supprimé),
dans le mapper de l'agrégat qui le sait.
Ne comptez jamais une conservation depuis le début : created_at (ou le registered_at d'une table plus ancienne) date la création de la ligne, et une purge
comptée depuis elle effacerait, chaque nuit et pour de bon, des personnes encore clientes. Le
générateur la refuse, comme il refuse les autres colonnes que la table garde pour elle, une colonne
personnelle, le sujet et une période qui n'est pas une unité positive ; une déclaration écrite à la
main prend le même soin.
Chaque nuit à 03:00 UTC, le job privacy.purge-expired de la plateforme lance runPurge : chaque
copie listée dans data-subject-copies.ts efface, comme sa déclaration le dit, les lignes qui ont
dépassé leur durée de conservation, dans chaque tenant, puisque le travail d'un job n'en nomme
aucun et qu'un tenant oublié dans une liste garderait ce qu'il ne doit pas, la seule écriture du
kit à travers les tenants (Multi-tenant) ; avec --audit on,
chaque copie laisse une entrée personal-data:purge avec le nombre de lignes, 0 compris, et
aucune personne. JOB_PRIVACY_PURGE_EXPIRED_ENABLED=false coupe le job dans un environnement, et
npm run privacy:purge le lance à la main et imprime les lignes atteintes par contexte. Une table
dont la déclaration ne donne aucune durée garde ses lignes jusqu'à ce que la personne le demande.
La plateforme garde des traces de son propre travail, et elles sont purgées de la même façon. À
03:30 UTC, events.purge-published retire les enregistrements de l'outbox publiés depuis plus de
OUTBOX_RETENTION_DAYS jours ; à 03:45 UTC, jobs.purge-finished retire les jobs réussis ou annulés
depuis plus de BACKGROUND_JOBS_RETENTION_DAYS jours, trente jours chacun par défaut. Un enregistrement
et une ligne de job gardent leur charge utile jusque-là. Un événement mort ou un job mort reste
jusqu'à ce qu'un opérateur décide, et un effacement l'atteint malgré tout.
JOB_EVENTS_PURGE_PUBLISHED_ENABLED=false et JOB_JOBS_PURGE_FINISHED_ENABLED=false en coupent un dans
un environnement.
Un projet qui lit ses durées dans la configuration (une variable d'environnement comme
RETENTION_PERIODS, un objet JSON de la copie à la durée) et purge par son propre job ne déclare
aucune retention littérale, que le registre écrirait until erased : il nomme la configuration,
configuredRetention: 'RETENTION_PERIODS', et le registre écrit configured by `RETENTION_PERIODS` .
Le kit lit la clé dans le texte de la source et jamais la valeur, et sa propre purge ne part que d'une
retention littérale ; les deux ensemble sont refusées. La durée elle-même reste au projet de
l'énoncer, dans la section du responsable de traitement du registre.
Combien de temps est une décision du projet, pas de l'outil : la durée qu'une loi impose (comptabilité, santé), ou celle dont la finalité a besoin. Écrivez-la au registre avec sa raison.
Le registre, généré
Section intitulée « Le registre, généré »npx ddd-ts-kit docs lit chaque déclaration et chaque événement d'intégration, et écrit ce que le
système garde des personnes à deux endroits, que docs --check tient au code comme le reste :
- la section Personal data de chaque
CONTEXT.md: une ligne par table (la colonne qui nomme la personne, les colonnes et les fichiers personnels, ce que fait un effacement, combien de temps les lignes sont gardées), puis les événements dont l'optionpersonaldit que leur payload en porte ; docs/privacy/register.md, avec--privacy on: les mêmes lignes à travers les contextes, les colonnes nommées comme la base les nomme quel que soit l'ORM, et chaque événement qui porte des données personnelles avec les contextes en aval de son producteur.
| Context | Table | About | Personal data | On erasure | Kept ||---|---|---|---|---|---|| billing | `customers` | `id` | `email`, `display_name` | pseudonymised | 36 months after `ended_at` |Le registre est l'inventaire qu'un projet tient, pas le registre des activités de traitement de
l'article 30 du RGPD : celui-ci nomme aussi les finalités, la base légale, les destinataires hors du
système et les transferts, qu'aucun code ne dit. Le fichier les laisse au responsable de traitement,
dans des sections hors des marqueurs que docs ne réécrit jamais, avec ce que le code ne purge pas
(sauvegardes, journaux, fichiers, archives du journal d'audit). Une table n'est au registre que si
une déclaration la nomme.
Les règles
Section intitulée « Les règles »Cinq règles de ddd-ts-kit check tiennent un projet dont stack.privacy vaut on à ses
déclarations, en avertissements, et elles le restent : elles lisent des noms, jamais des
contenus, et une colonne address peut désigner un entrepôt. Une équipe qui en veut une bloquante
met sa sévérité à error dans rules de la config. Un projet qui a choisi off n'en entend rien.
| Règle | Signale |
|---|---|
privacy/declared-field |
une colonne nommée comme une donnée personnelle (email, phone, birth_date, address, iban... le vocabulaire du kit, avec privacy.vocabulary de la config ajouté et privacy.allow retiré) qu'aucune déclaration de son contexte ne nomme, sur les quatre ORM |
privacy/event-payload-declared |
un champ du payload d'un événement d'intégration nommé comme une donnée personnelle que son option personal ne liste pas |
privacy/erasure-reaches-copies |
un contexte qui consomme un événement portant des données personnelles et n'efface rien quand la personne est effacée |
privacy/subject-is-opaque |
un sujet qui est lui-même une donnée personnelle (un email comme clé d'une personne) |
privacy/no-personal-data-in-logs |
un appel au logger ou aux métriques qui nomme un champ personnel déclaré |
privacy/snapshot-sealed |
une valeur d'un mapper de snapshots nommée comme une donnée personnelle qu'aucun personalData ne scelle |
Elles lisent des noms, pas des contenus, c'est pourquoi chacune dit ce qu'elle ne voit pas
(npx ddd-ts-kit explain privacy/declared-field). Une colonne qui ne tient rien d'une personne dans
un projet (la boîte aux lettres partagée d'une équipe) est une dérogation enregistrée là où elle
s'écrit, // ddd-ts-kit-disable-next-line privacy/declared-field -- ADR-NNNN: <why>, ou un mot de
privacy.allow. Un flux d'événements n'a pas de table : une clé d'un mapper d'événements que le même
fichier scelle avec personalData(subject, value) est déclarée par là, et seule une clé stockée en
clair est signalée.
Ce qui reste hors de portée
Section intitulée « Ce qui reste hors de portée »- Les sauvegardes et la rétention du broker. Un effacement atteint la base de données, jamais
une sauvegarde ni un message déjà publié : la borne d'un effacement est une date, que la politique
de rétention décide. L'annonce atteint les consommateurs en marche et abonnés ; un message déjà
dans une file de lettres mortes ou sur un topic y reste jusqu'à la fin de sa rétention. Un
enregistrement de l'outbox est dans la base : l'effacement l'atteint, et seulement par les champs que
l'option
personalde son événement liste, à traverspersonal-events.ts, queddd-ts-kit docstient à jour. Un enregistrement encore en attente part avec[erased]à la place du champ : un consommateur dont le schéma refuse ce texte refuse l'événement, et rien de la personne ne sort. Les clés de l'event store rendent illisibles les événements d'une sauvegarde une fois détruites, raison pour laquelle elles vivent à part, avec une rétention plus courte (Event sourcing). - Un champ qu'aucune option
personalne liste, un job qui ne nomme aucunsubject. La charge utile d'un événement se lit par sa déclaration, et une ligne de job se trouve par sonsubject:privacy/event-payload-declaredsignale un champ nommé comme une donnée personnelle, et rien ne signale un job qui tient une personne dans sa charge utile sans la nommer. Un job qui concerne une personne est mis en file avec{ subject: personId }. Les jobs gardés dans la mémoire d'un processus (--queue memory) sont hors de portée d'un script qui tourne dans un autre, et finissent avec ce processus. - Ce qu'un cache garde. Un effacement n'atteint pas le port
Cache: une valeur qu'une lecturecachedgarde d'une personne y reste jusqu'à son temps de vie, une fois la ligne disparue. Une lecture qui répond une personne prend unttlMsque la rétention du projet accepte, ou n'est pas mise en cache. - Les journaux et les exports déjà remis. Rien du kit ne les réécrit ; les adaptateurs de journal masquent les secrets, pas les noms (Observabilité).
- Une colonne qu'aucune déclaration ne nomme. Une règle lit le nom d'une colonne, pas ce qu'un
champ texte peut contenir : une colonne
notespeut tenir un diagnostic. Les déclarations sont l'inventaire qu'un projet maintient, etprivacy/declared-fieldne signale qu'une colonne dont le nom porte un mot du vocabulaire (voir Les règles). - Un read model. Une projection garde ses lignes dans un read model store, pas dans une table
à elle : elle ne déclare rien encore. La reconstruction d'une projection alimentée par l'event store
retire la copie en clair qu'elle gardait, une fois donnée à
rebuilds. Un read model dans OpenSearch s'atteint comme le dit Modèles de lecture de recherche. - Les colonnes que l'agrégat n'écrit pas encore. Le mapper écrit les colonnes déclarées vides tant que l'agrégat ne les porte pas ; l'effacement d'une colonne vide atteint la ligne malgré tout.
Ce que l'outil ne décide pas
Section intitulée « Ce que l'outil ne décide pas »Le kit fournit les mesures techniques de la protection des données dès la conception (RGPD, article 25) : déclaration, effacement, export, une preuve datée, une conservation purgée chaque nuit et un registre généré. La base légale de chaque traitement, l'information des personnes concernées, les sous-traitants et l'analyse d'impact appartiennent au projet ; qu'une ligne pseudonymisée vaille effacement aux yeux de la loi est au responsable de traitement d'en décider, comme la page du journal d'audit le dit de ce qui reste dans la chaîne. Le document d'un export porte les données ; les informations qui accompagnent la réponse à une demande d'accès (les finalités, les destinataires, la durée de conservation, les droits de la personne, article 15(1)) sont la lettre que le projet écrit autour. Par construction veut dire intégré par défaut, jamais une garantie juridique.
Voir aussi
Section intitulée « Voir aussi »- Event sourcing, par agrégat : le scellement des événements stockés et les clés
- Journal d'audit : la preuve datée d'un effacement et d'un export, les masques à clé par personne concernée
- Multi-tenant : ce qu'un tenant confine, et pourquoi un effacement est joué une fois par tenant
- Stockage de fichiers : les fichiers d'une personne, déclarés comme
filesd'une déclaration - Protection des données dès la conception, au-delà de l'event sourcing : les parties construites et celles à venir, les mots à employer
- La référence du CLI :
init(--privacy,--event-sourcing) etgenerate repository(--personal,--subject,--erasure),generate personal-fieldspour une table qu'aucun agrégat ne possède