
Stratégie de test
Résumé. Le kit teste le comportement à travers des interfaces publiques, à quatre niveaux (domaine, application, adaptateur, de bout en bout), avec les mêmes builders de données de test à chaque niveau. Les doublures de test sont des fakes, des implémentations en mémoire et fonctionnelles des ports, plutôt que des mocks ; un fake reste honnête en passant la même suite de contrat que l'adaptateur réel qu'il remplace. Les specs d'agrégat se lisent « étant donné / quand / alors ». Le résultat est une suite où la plupart des tests s'exécutent en quelques millisecondes sans aucune infrastructure, survivent aux refactorisations parce qu'ils vérifient des résultats plutôt que des appels, et se lisent comme des règles métier. Cette page explique chaque choix, dit quoi tester où, et énonce ce que la stratégie ne couvre pas.
Le vocabulaire des doublures de test
Section intitulée « Le vocabulaire des doublures de test »« Mock » désigne souvent n'importe quelle doublure. Le vocabulaire de Gerard Meszaros, popularisé par Martin Fowler, est plus précis :
| Doublure | Ce qu'elle est | Vérifie |
|---|---|---|
| dummy | passée mais jamais utilisée | rien |
| stub | renvoie des réponses préparées | l'état, indirectement |
| spy | un stub qui enregistre comment il a été appelé | les appels, après coup |
| mock | préprogrammé avec les appels qu'il attend | les appels : le test échoue s'ils diffèrent |
| fake | une implémentation qui fonctionne, avec un raccourci (en mémoire au lieu d'une base de données) | l'état |
La distinction qui compte est la dernière colonne. Un test avec des mocks vérifie une
interaction : « save a été appelée une fois avec cet objet ». Un test avec un fake vérifie un
résultat : « le rendez-vous est enregistré et annulé ».
Des fakes, pas des mocks
Section intitulée « Des fakes, pas des mocks »// au lieu de, avec un mock : vérifie comment le gestionnaire parle à ses collaborateursconst appointments = { findById: vi.fn().mockResolvedValue(appointment), save: vi.fn() };// le contrôle d'accès est simulé lui aussi : le test connaît désormais chaque collaborateur du gestionnaireconst access = { authorize: vi.fn().mockResolvedValue(undefined) };const handler = new CancelAppointmentHandler(appointments, access, clock);
await handler.execute(new CancelAppointmentCommand(patient, appointment.id));
expect(appointments.save).toHaveBeenCalledWith(expect.objectContaining({ status: 'cancelled' }));
// écrivez, avec un fake : vérifie ce qui est vrai après coupconst appointments = new FakeAppointmentRepository();await appointments.save(appointment);
const app = createTestApplication({ modules: [platformTestModule, contextModule('scheduling', schedulingDeclarations), holders], fakes: [fake(AppointmentRepository, appointments)],});
await app.commandBus.execute(new CancelAppointmentCommand(patient, appointment.id));
expect((await appointments.findById(appointment.id))?.status).toBe('cancelled');expect(app.eventBus.published).toMatchObject([{ type: 'scheduling.appointment.cancelled' }]);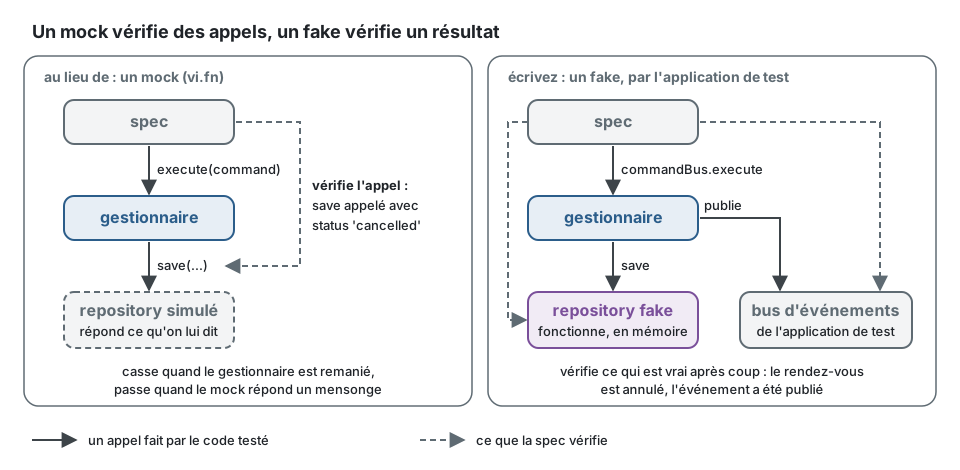
Pourquoi le kit préfère la seconde forme (règle
test/no-mocks, un avertissement par défaut) :
- Les mocks couplent les tests à l'implémentation. Renommez une méthode, enregistrez en deux étapes au lieu d'une, chargez par une autre méthode de recherche : le comportement est inchangé, les tests à base de mocks échouent. Des tests qui cassent à chaque refactorisation découragent de refactoriser.
- Les mocks peuvent affirmer un mensonge. Un repository simulé renvoie tout ce que dit le test, y compris des choses que le vrai ne renverrait jamais. Le test passe ; la production, non.
- Les fakes sont réutilisables. Un seul repository en mémoire sert toutes les specs de
gestionnaire du contexte, et une panne est une méthode du fake (
mailer.failNextWith(...)) plutôt qu'une préparation répétée dans chaque test. - L'architecture rend les mocks inutiles. Chaque dépendance est un port reçu par le constructeur ; le temps et les identifiants sont aussi des ports. Une classe qui a besoin d'un mock de module pour être testée enfreint une règle de pureté (Code propre).
C'est l'école « classique » dans les termes de Fowler. L'école « mockiste », décrite par Freeman et Pryce, utilise les mocks pour découvrir les interfaces en concevant de l'extérieur vers l'intérieur ; c'est une pratique cohérente, et ses auteurs mettent eux aussi en garde contre le fait de simuler des types que l'on ne possède pas. La position du kit est plus étroite qu'une doctrine : ses ports sont déjà conçus et chacun a un fake, si bien que les vérifications d'interaction ajoutent du couplage sans ajouter d'information.
La seule doublure acceptée qui n'est pas un fake : un stub d'une API HTTP extérieure au niveau du réseau, dans la spec d'intégration d'un adaptateur.
Un fake est une petite classe de test/fakes/ qui implémente le port avec un raccourci, et
offre sous forme de méthodes les pannes dont un test a besoin. Le mailer du contexte de
notification de l'exemple, raccourci :
export abstract class Mailer {  /** Échoue quand le fournisseur n'a pas pris le courriel. */  abstract deliver(address: string, subject: string): Promise<void>;}
// notification/test/fakes/mailer.fake.tsexport class FakeMailer implements Mailer {  /** Ce que le fournisseur a pris, dans l'ordre : ce qu'une spec vérifie. */  readonly delivered: { readonly address: string; readonly subject: string }[] = [];
  private readonly failures: Error[] = [];
  /** La prochaine livraison échoue avec cette erreur, puis le mailer fonctionne de nouveau. */  failNextWith(error: Error): void {    this.failures.push(error);  }
  async deliver(address: string, subject: string): Promise<void> {    const failure = this.failures.shift();
    if (failure !== undefined) {      throw failure;    }
    this.delivered.push({ address, subject });  }}
Une spec se lit alors comme la règle qu'elle prouve : mailer.failNextWith(new Error('provider unreachable')), envoyer la notification, et attendre que rien n'ait été enregistré ni publié.
Les tests de contrat gardent les fakes honnêtes
Section intitulée « Les tests de contrat gardent les fakes honnêtes »La faiblesse d'un fake est la dérive : un repository en mémoire qui tolère ce que PostgreSQL refuserait. La réponse est une suite de contrat : un ensemble de tests écrits contre le port, exécutés contre le fake et contre l'adaptateur réel.
flowchart TB
  C[Suite de contrat du port : enregistrer puis trouver, identifiant inconnu, mise à jour, concurrence optimiste...]
  C --> F[FakeCalendarRepository, dans test/fakes]
  C --> R[Adaptateur réel sur PostgreSQL]
  F --> H[utilisé par chaque spec de gestionnaire]
  R --> P[utilisé en production]
Dans le code, un appel par implémentation, avec les mêmes attentes. La spec du repository des calendriers de l'exemple, raccourcie :
import { afterEach, beforeEach, describe, expect, it } from 'vitest';import { AggregateRoot, type Repository } from '@ddd-ts-kit/kernel';import { InMemoryRepository } from '@ddd-ts-kit/testing';import { repositoryContract } from '@ddd-ts-kit/testing/contracts';
// venus du domaine, des builders et de la base de données de test du projetinterface CalendarState {  readonly exceptions: readonly string[];}declare class Calendar extends AggregateRoot {  static rehydrate(id: string, state: CalendarState): Calendar;  addException(day: string, at: Date): void;  toState(): CalendarState;}declare function aCalendar(): { build(): Calendar };declare function knexCalendarRepositoryOnAFreshDatabase(): Promise<Repository<Calendar>>;
const runner = { describe, it, expect, beforeEach, afterEach };
const expectations = {  createAggregate: () => aCalendar().build(),  mutate: (calendar: Calendar) => calendar.addException('2026-12-25', new Date('2026-01-02T00:00:00.000Z')),  idOf: (calendar: Calendar) => calendar.id,  stateOf: (calendar: Calendar) => calendar.toState(),};
// le fake qu'utilise chaque spec de gestionnairerepositoryContract<Calendar>(runner, {  ...expectations,  name: 'FakeCalendarRepository',  createRepository: () =>    new InMemoryRepository<Calendar>({ clone: (stored) => Calendar.rehydrate(stored.id, stored.toState()) }),});
// l'adaptateur qu'utilise la production, sur une vraie base de donnéesrepositoryContract<Calendar>(runner, {  ...expectations,  name: 'KnexCalendarRepository',  createRepository: () => knexCalendarRepositoryOnAFreshDatabase(),});
Si les deux passent la même suite, un gestionnaire testé sur le fake se comporte de la même
façon sur l'adaptateur pour tout ce que couvre le contrat. Le kit fournit des suites pour ses
propres ports dans @ddd-ts-kit/testing/contracts (repository, unité de travail, store de
modèle de lecture et critères, bus d'événements, store d'événements, store de l'outbox, store des
événements traités, store des processus, store des jobs, planificateur de jobs, cache,
purgeur de cache, verrou, limiteur de débit, stockage de fichiers, logger, isolation des
tenants) et dans @ddd-ts-kit/auth/testing (autorisateur, store des tuples de relation),
ainsi que ContractSuite, la base pour écrire la suite d'un port à vous. Remplacer un ORM ou un
broker revient alors à « écrire l'adaptateur, passer la suite ».
Un contrat couvre ce qu'il teste et rien de plus : le comportement propre à un adaptateur (le mapping de chaque colonne, l'annulation d'une transaction) a ses propres tests d'intégration.
Un projet généré sur un ORM tient les stores du kit tels que sa propre plateforme les branche :
src/platform/database/persistence.contract.spec.ts exécute les contrats des stores de
l'outbox, des événements traités, des jobs et des processus sur la persistance de
open-test-database.ts, avec ce que la pile active (le tenant de chaque événement et de chaque
instance de processus sous --tenancy, l'unité de travail d'une étape). Un store branché sans ce
que la pile demande échoue là, avant d'échouer en production.
Builders
Section intitulée « Builders »Les données de test viennent de builders, un par agrégat :
const appointment = anAppointment().forPatient('ada').startingAt(tomorrowAt9).cancelledByPatient().build();Un builder étend Builder de @ddd-ts-kit/testing : des defaults() valides une fois pour
toutes, un construct() qui passe par l'API publique de l'agrégat, et une méthode par mot du
langage. L'instant de la naissance est un ingrédient nommé d'après son fait (bookedAt de
Appointment Booked), comme l'écrit generate aggregate --birth ; examples/scheduling garde
bornAt tant que ses agrégats ne sont pas régénérés. Sur le modèle du builder de l'exemple :
import { AggregateRoot } from '@ddd-ts-kit/kernel';import { Builder, sequence, type Defaults } from '@ddd-ts-kit/testing';
// l'agrégat, venu du domainedeclare class Appointment extends AggregateRoot {  static create(id: string, patientId: string, startsAt: Date, bookedAt: Date): Appointment;  cancel(by: 'patient' | 'practice', at: Date): void;}
interface AppointmentIngredients {  readonly id: string;  readonly patientId: string;  readonly startsAt: Date;  readonly bookedAt: Date;  readonly cancelled: boolean;}
export class AppointmentBuilder extends Builder<AppointmentIngredients, Appointment> {  forPatient(patientId: string): this {    return this.with('patientId', patientId);  }
  startingAt(instant: Date): this {    return this.with('startsAt', instant);  }
  cancelledByPatient(): this {    return this.with('cancelled', true);  }
  protected defaults(): Defaults<AppointmentIngredients> {    return {      id: sequence('appointment'),      patientId: 'patient-1',      startsAt: new Date('2026-03-02T09:00:00.000Z'),      bookedAt: new Date('2026-03-01T00:00:00.000Z'),      cancelled: false,    };  }
  /** Par l'API publique seulement : un test ne peut jamais partir d'un état que les règles interdisent. */  protected construct({ id, patientId, startsAt, bookedAt, cancelled }: AppointmentIngredients): Appointment {    const appointment = Appointment.create(id, patientId, startsAt, bookedAt);
    if (cancelled) {      appointment.cancel('patient', bookedAt);    }
    return appointment;  }}
export function anAppointment(): AppointmentBuilder { return new AppointmentBuilder();}- Des valeurs par défaut valides.
anAppointment().build()est un rendez-vous valide. Un test n'énonce que ce qui compte pour la règle qu'il vérifie, si bien que le lecteur voit la cause du résultat. - Nommés dans le langage omniprésent (ubiquitous language).
cancelledByPatient(), paswithStatus('CANCELLED'). - Construits par l'API publique.
build()passe par la fabrique et les méthodes d'intention de l'agrégat, si bien qu'un test ne peut pas partir d'un état invalide. Si un test a besoin d'un état que l'API publique ne peut pas atteindre, soit l'état est impossible, soit l'API est incomplète. - Immuables. Chaque appel renvoie un nouveau builder, si bien qu'une base partagée ne peut pas fuiter d'un test à l'autre.
Règle test/builder-required. Sans builders,
chaque changement d'un constructeur modifie cinquante tests, et chaque test enfouit son unique
valeur pertinente sous dix valeurs qui ne le sont pas.
Plusieurs specs de handler d'un contexte construisent la même application de test avec les
mêmes fakes. Cette mise en place s'écrit une fois, comme un monde de test/worlds/, et se
génère au lieu de se copier :
npx ddd-ts-kit generate test-world schedulingLe générateur lit test/fakes/*.fake.ts, trouve le port que chaque classe implémente dans
domain/repositories/ ou application/ports/, et écrit test/worlds/scheduling.world.ts :
aSchedulingWorld(options) construit chaque fake, laisse la spec enregistrer ce dont elle
part, puis confie les fakes à l'application de test et la rend avec chaque fake sous le nom
de son port. Une spec de l'exemple se lit alors :
const { application, appointmentRepository } = await aSchedulingWorld({ modules: [holders], now: NOW, given: async (fakes) => { await fakes.appointmentRepository.save(requested); },});- Ce qu'il prend.
nowetidPrefixvont à l'application de test ;modulesajoute ce que la spec apporte, son module d'autorisation (par défaut aucun rôle ne détient de permission) ;fakesajoute le fake d'un port qu'il ne sait pas construire seul, un lecteur qui répond ce que la spec lui donne ;tenants, avec la multi-location, les locataires pour lesquels tourne une tâche planifiée par locataire ;givenreçoit les fakes avant que l'application ne les branche, si bien que les événements enregistrés en construisant les agrégats stockés ne sont pas annoncés comme si une commande venait de s'exécuter. - Les specs générées passent par lui. Une commande, une requête ou une tâche planifiée
générée une fois
test/worlds/<context>.world.tsprésent écrit sonarrange()comme un seul appel du monde ; générée avant, ou quand le monde n'a pas le fake dont sa spec a besoin, elle construit elle-même l'application de test, et un commentaire et la sortie du générateur disent ce que le monde changerait (avec un conteneur, où le monde remplace toute la mise en place). Un monde que le générateur ne sait pas lire, son constructeura<Context>Worldou ses options introuvables, est dit tel et jamais proposé à--force. Un fake qu'une spec passe au monde remplace celui qu'il construit pour le même port. Aucun générateur n'écrit le monde sans qu'on le demande. - Sans conteneur d'injection (
createTestBuses), le monde rend les bus et les fakes, chaque repository enveloppé pardispatching, et la spec enregistre le handler qu'elle teste. - Ce qu'il laisse de côté, en le disant. Un fake dont le constructeur attend un argument
(un lecteur qui répond ce que la spec lui donne) et, avec un conteneur, le fake d'un port
que rien ne lie ni n'utilise encore : l'application de test le refuserait. Relancez le
générateur avec
--forcequand le contexte a gagné un fake. - Ce qui reste dans la spec. La permission qu'elle exerce, les données dont elle part
(construites par les builders) et les faits qu'elle écoute. Un monde ne contient aucune
donnée de test. La permission tient en une ligne,
holdersOfde@ddd-ts-kit/auth/testing: un acteur qui la détient et un autorisateur qui l'accorde à cet acteur et aux acteurs système, et refuse tous les autres.
const { holder, authorizer } = holdersOf(schedulingPermissions['appointment.confirm']);const holders = authorizationModule({ authorizer });Une aide écrite parmi les specs à la place, test/unit/scheduling-application.ts, est
signalée par test/helper-placed, un
avertissement : test/unit/ et test/integration/ contiennent des specs, et une mise en place
partagée, des données de test ou un port en mémoire ont chacun leur place (test/worlds/,
test/builders/, test/fakes/).
Où vivent les tests d'un module
Section intitulée « Où vivent les tests d'un module »Un contexte qui divise son modèle en modules ne garde aucun dossier test/ à
son propre niveau. Chaque module tient ses tests à côté de ses couches, <module>/test/ avec
unit/, integration/, builders/ et fakes/ : les specs d'une partie du modèle s'ouvrent,
se déplacent et se relisent avec elle. Un builder et un fake suivent leur sujet, pas leur
usage : le builder d'un agrégat est dans le module de cet agrégat, le fake d'un port ou d'un
repository dans le module de ce port, et une spec d'un autre module les importe de là. Ce
qui n'appartient à aucun module est dans shared/test/ : les mondes, qui arrangent une
application de test sur les fakes de tous les modules, un fake ou un builder qui ne porte
le nom de rien d'un module (une horloge), et la spec d'une garde ou de plusieurs modules.
generate écrit chacun à sa place, move-to-module emmène les specs d'un fichier déplacé, et
ddd-ts-kit context-layout déplace un contexte disposé auparavant. Un contexte sans modules
garde son dossier test/ tel que cette page le montre.
Étant donné / quand / alors
Section intitulée « Étant donné / quand / alors »Une spec d'agrégat est un scénario : un état construit (ou des événements passés), une intention, puis les événements enregistrés ou l'erreur levée.
import { describe, expect, it } from 'vitest';import { AggregateRoot } from '@ddd-ts-kit/kernel';import { Builder, given } from '@ddd-ts-kit/testing';
// l'agrégat et son builder, venus de l'exemple précédentdeclare class Appointment extends AggregateRoot {  readonly status: 'booked' | 'cancelled';  cancel(by: 'patient' | 'practice', at: Date): void;  reschedule(startsAt: Date, at: Date): void;}declare abstract class AppointmentBuilder extends Builder<object, Appointment> {  cancelledByPatient(): this;}declare function anAppointment(): AppointmentBuilder;
const at = new Date('2026-03-01T08:00:00.000Z');
describe('Appointment', () => {  it('records that it was cancelled', () => {    given(anAppointment())      .when((appointment) => appointment.cancel('patient', at))      .thenEvents([{ name: 'scheduling.appointment.cancelled', occurredAt: at }])      .thenState((appointment) => expect(appointment.status).toBe('cancelled'));  });
  it('refuses to reschedule a cancelled appointment', () => {    given(anAppointment().cancelledByPatient())      .when((appointment) => appointment.reschedule(new Date('2026-03-03T09:00:00.000Z'), at))      .thenError('APPOINTMENT_ENDED');  });});
given prend le builder, construit l'agrégat et oublie les événements enregistrés pendant sa
construction, si bien que thenEvents ne voit que ceux de when. thenError prend un code, ou la
classe de l'erreur et un code.
Une intention par test, et des vérifications sur les événements, les erreurs et l'état par l'API
publique seulement. Le nom du test énonce la règle : refuses to reschedule a cancelled appointment.
Les quatre niveaux
Section intitulée « Les quatre niveaux »| Niveau | Ce qui s'exécute | Doublures | Vitesse |
|---|---|---|---|
| domaine | agrégats, objets-valeurs, services du domaine | aucune | millisecondes |
| application | les vrais gestionnaires à travers les bus en mémoire | des fakes pour chaque port, une horloge fixe | millisecondes |
| adaptateur | un adaptateur réel contre sa dépendance réelle, plus la suite de contrat | aucune | secondes |
| de bout en bout | l'application entière avec ses adaptateurs réels, par HTTP et le bus d'événements | aucune ; des données générées avec une graine fixe | secondes |
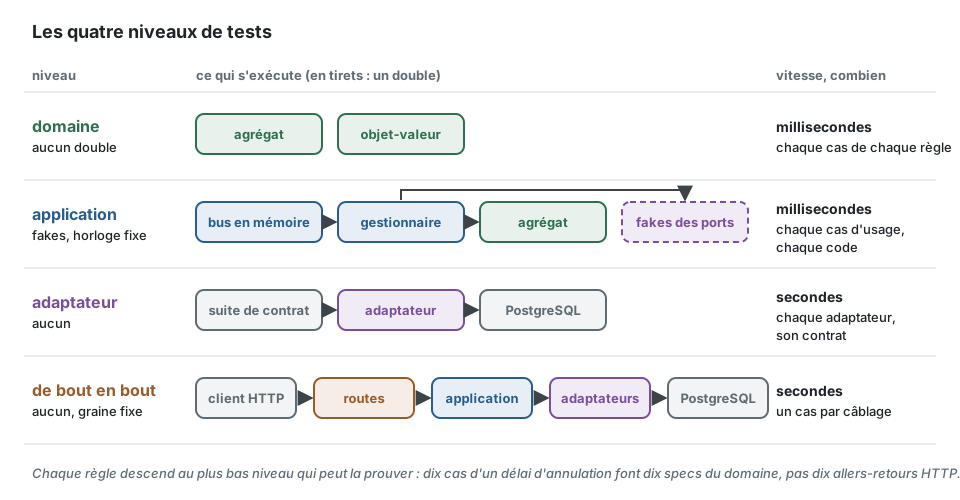
Tableau normatif : section 7 de la référence de l'architecture.
Un niveau d'architecture se tient à côté d'eux : ddd-ts-kit check, et un test généré qui démarre
chaque contexte seul pour prouver qu'il reste extractible.
Les mêmes builders servent à chaque niveau. Les tests de bout en bout créent leur état par l'API
publique, utilisent des données générées avec une graine affichée en cas d'échec pour qu'une
exécution en échec puisse être rejouée, et vérifient ce qu'un client observe (réponses, événements
publiés), jamais directement la base de données.
generate e2e nomme une spec d'après le cas d'usage dont elle conduit la route,
test/e2e/issue-invoice.e2e.spec.ts. Une spec qui dépasse la limite de taille
(clean/file-size, 350 lignes) est découpée par comportement en parties qui portent son nom,
test/e2e/issue-invoice-refusals.e2e.spec.ts, et un parcours qui traverse plusieurs cas d'usage
est test/e2e/journey-<name>.e2e.spec.ts : la garde du plugin laisse écrire ces deux-là à la
main, et refuse toute autre nouvelle spec de bout en bout. Ce que partagent les specs d'un
contexte (connecter une personne, un monde) vit dans test/e2e/support/<context>/, au lieu
d'être copié dans chacune.
Les specs d'adaptateur et de bout en bout d'un projet généré s'exécutent sur PostgreSQL dans le
processus (PGlite). Une mise en place globale (test/support/test-database-template.ts)
le démarre une fois par exécution et enregistre son cluster initialisé ; chaque spec en ouvre une
copie au lieu de lancer son propre initdb, la partie lente du démarrage, si bien qu'une machine
chargée ne fait plus dépasser son délai au hook qui ouvre la base. Chaque spec crée encore ses
tables sur cette copie : le code des contextes qui les crée reste exécuté, et mesuré, comme avant.
Mesuré avec PGlite 0.5.9 sur une machine au repos (2026-10-18, cinq exécutions chacune) : un
initdb prend environ 770 ms, ouvrir une copie du cluster enregistré environ 170 ms, et créer vingt
tables avec leurs clés et leurs index sur elle environ 25 ms. Enregistrer aussi les tables dans
la copie épargnerait ces 25 ms et laisserait non exécuté le code qui les crée : ce n'est pas
fait.
Contre un serveur (DATABASE_URL, que lit le support de bout en bout), la base que nomme l'URL
est migrée à l'avance (npm run db:migrate) et chaque fichier de spec s'exécute sur une base à
lui, avec les tables de celle-là, vidées. Une mise en place globale de l'exécution de bout en bout
(test/support/test-database-setup.ts) ouvre l'exécution une fois, là où aucun délai de hook ne
s'applique (test/support/test-database-run.ts) : elle copie la base migrée
(create database ... template) et vide la copie. openTestDatabase(url) copie ensuite ce modèle
pour son fichier (test/support/test-database-clone.ts), connecte la persistance à la copie, et la
supprime à close(). Un fichier attend donc sa base une fraction de seconde quoi que contienne la
base migrée, les fichiers s'exécutent en même temps sur un serveur comme dans le processus, et la
base migrée elle-même n'est jamais écrite. reset() vide toujours les tables de la copie entre
deux tests. Mesuré sur PostgreSQL 18 avec une base migrée de 474 Mo (2026-11-12) : une copie prend
6 secondes, quatre en même temps 46 à 56 secondes chacune, plus que les 30 secondes d'un hook ;
avec le modèle de l'exécution, la mise en place globale prend 6 secondes une fois et chaque
fichier attend 0,1 à 0,5 seconde. Deux exécutions lancées ensemble copient la base migrée l'une
après l'autre (un verrou pour tout le serveur, puisque deux copies en même temps se
ralentissent) : la seconde attend la copie de la première, dans sa mise en place globale, et leurs
fichiers ne s'attendent jamais. Sur Prisma, le client et generated/schema.sql que chaque
exécution dérive d'abord (npm run db:client, par ddd-ts-kit prisma-client) sont écrits par une
seule exécution à la fois, et la seconde les trouve à jour et n'écrit rien, si bien que de deux
exécutions lancées depuis les mêmes sources, aucune ne lit un client que l'autre est en train de
réécrire. Une exécution qui surveille les fichiers copie une fois, à son
démarrage : une migration appliquée entre-temps atteint les fichiers après un redémarrage.
- Un fichier part de tables vides, sauf celles que le projet garde. L'exécution vide chaque
table de sa copie sauf celles que liste
KEPT_TABLESdanstest/support/test-database-kept.ts, un fichier du projet :<schéma>.<table>, ou<schéma>.*, écrit comme le serveur stocke le nom et sans guillemets, donc en minuscules sauf si la table a été créée entre guillemets ("Countries"se listepublic.Countries,Countriesse listepublic.countries).<schéma>.*garde chaque table du schéma, quoi que son nom contienne : une table dont le nom contient un point ou un guillemet n'a pas de nom à elle dans la liste et ne se garde que par<schéma>.*, et un schéma dont le nom en contient un ne peut pas être listé. Toute autre forme (*,public, un nom entre guillemets,public.plans.v2) fait refuser l'exécution avec les formes qu'un nom prend, et un nom qui n'est aucune table de la base (une faute de frappe, une autre casse, une vue) est dit en une ligne, puisqu'il ne garde rien ; les noms que la liste générée tient pour une table que son outil n'a pas encore créée ne le sont pas. Tel que généré, il liste ce que l'outil de migration écrit de ce qu'il a appliqué et, avec un journal d'audit, le schémaaudit, laissé tel que la base migrée le contient (son garde refuse un truncate, et le paquet audit conseille un journal que le rôle de l'application ne possède pas). Un outil de migration à qui l'on fait nommer sa table autrement (tableNamedu knexfile,migrationsTableNamede la source de données,migrations.tablededrizzle.config.ts) y voit ce nom écrit à la main. Ajoutez une table dont une migration insère les lignes et que l'application lit : tout le reste de ce qu'une migration insère, de ce qu'une application ou une spec a laissé, n'atteint jamais une spec, comme sur PostgreSQL dans le processus. Les tables sont vidées en un seultruncatesanscascade, chacune seule (only) : une table gardée qui référence une table vidée fait refuser l'exécution avec les deux noms, et se garde avec celle qu'elle référence ; une table gardée qui hérite d'une table vidée garde ses lignes. Une partition se vide avec sa table : une partition gardée d'une table vidée fait refuser l'exécution avec les deux noms, de même qu'une table gardée qui référence une partition d'une telle table. Une table qu'un autre rôle possède, ou placée dans un schéma que le rôle de l'exécution ne peut pas utiliser, est laissée avec ses lignes et nommée en une ligne, une table d'une extension est laissée aussi, les vues matérialisées sont rafraîchies, et une séquence qu'aucune colonne ne possède garde sa valeur. L'exécution nomme sur sa sortie d'erreur les tables vidées qui contenaient des lignes, jusqu'à 20 d'entre elles, pour qu'une ligne qui manque à une spec ait sa cause à l'écran, et au-delà de 64 Mo ce qu'a pris la copie : donnez aux tests une base à eux, migrée et vide, pour épargner ce temps. - Les connexions sont partagées entre les fichiers qui s'exécutent en même temps. La mise en
place globale compte les fichiers qui s'exécutent en même temps, les workers de l'exécution et
pas plus que les fichiers de cette exécution (3 fichiers sur une machine de 16 workers
comptent 3). Sous Vitest, c'est la liste du lanceur une fois appliqués les filtres de la ligne
de commande, et la part d'un shard. Jest ne remet aucune liste à une mise en place globale :
le compte est celui des fichiers de spec sous
test/que les motifs de la ligne de commande retiennent, sur le chemin depuis la racine du projet ou sur le chemin entier comme Jest les applique, moins ceux qu'ignoretestPathIgnorePatterns, et la part d'un shard, un nombre que l'exécution ne peut pas dépasser. Quand le compte ne peut pas se faire, ou ne trouve rien (une exécution qui surveille, un lanceur qui ne liste rien, un motif qui n'est pas une expression, pas de répertoiretest/, aucun fichier de spec soustest/parmi ceux de l'exécution, qui a alors des fichiers que ce compte ne voit pas), seuls les workers comptent. La mise en place lit ensuite ce qu'il reste au serveur (max_connections, moins ce qu'il réserve et ce qui est ouvert, et pas plus que la limite de connexions du rôle), et donne à chaque fichier sa part, moins une connexion de réserve : l'application sous test ouvre un pool de cette taille, 10 au plus (DatabaseClone.poolSize, que les quatre ORM remettent à leur connexion), et celle de réserve est la connexion qui copie et supprime la base, ou un client qu'une spec ouvre elle-même. Une seconde application démarrée dans le même fichier, ou un adaptateur qui ouvre son propre pool, n'est pas comptée. Sous deux connexions pour le pool l'exécution est refusée avant qu'un fichier démarre, avec ses nombres, le nombre de fichiers en même temps qui tient (--maxWorkers) et ce qui relève la borne qui la retient (max_connections, la limite du rôle, ou la variable ci-dessous), au lieu d'untoo many clientsdu pilote au milieu d'une spec.TEST_DATABASE_CONNECTIONSénonce un nombre plus petit que ce que laisse le serveur, pour un serveur que d'autres exécutions vont utiliser ; une valeur qui n'est pas un nombre entier, ou qui dépasse ce que laisse le serveur, est refusée. Le compte est pris au démarrage de l'exécution : une exécution lancée plus tard voit ce que la première a d'ouvert, pas ce qu'elle ouvrira. - Une exécution dit qu'elle vit, deux fois. Une base d'une exécution s'appelle
<base>_test_<exécution>_templateou<base>_test_<exécution>_<aléa>. L'exécution tient un verrou consultatif dont la clé est son nom, sur une session de la basepostgresdu serveur, d'avant sa première base jusqu'à son démontage, et toutes les 15 secondes elle écrit l'heure du serveur dans le commentaire de son modèle (comment on database). La mise en place globale d'une exécution ne supprime une base nommée d'après une exécution que si le verrou de celle-ci est libre, si elle n'a rien écrit depuis une minute, et si personne n'est connecté à la base : une exécution qui vit, dans un autre checkout ou sur une autre machine, garde ses bases, et une base d'un autre nom n'est jamais supprimée. Le verrou seul ne suffirait pas : un serveur termine des sessions (un redémarrage, une bascule, un délai des sessions inactives, un portable qui a dormi), l'exécution reprend alors aussitôt une session et son verrou, et le commentaire couvre ce moment ; les sessions sur une base ne suffiraient pas non plus, puisqu'un pool inactif n'en a pas et qu'un modèle n'en a pas entre deux fichiers. Ce qu'une exécution tuée à l'instant a laissé est donc supprimé par une exécution qui démarre une minute plus tard, pas par la toute suivante. Une exécution qui ne peut pas reprendre de session le dit, et son démontage ne lève jamais d'erreur : il supprime ce qui est à elle sur une autre session. Une exécution qui reprend une session et ne trouve plus son modèle (elle n'en a pas eu pendant plus d'une minute et une autre exécution a supprimé ce qu'elle tenait pour mort, ou un administrateur l'a fait) dit qu'elle a perdu ses bases, et chaque fichier qui ne peut alors pas copier le modèle échoue avec la même phrase au lieu dutemplate database ... does not existdu serveur. La copie de la base migrée a une session à elle : quand le serveur la termine, ce qui reste de la copie est supprimé et la copie refaite une fois, et une seconde fin est dite comme telle. Une instruction de l'exécution que quelqu'un annule (pg_cancel_backend, une tâche qui annule les instructions qui durent) n'est pas une session terminée : l'exécution dit que sa copie a été annulée et ne la reprend pas. L'adresse est directe : derrière un pooler en mode transaction un verrou de session ne veut rien dire, et l'exécution a besoin du serveur lui-même.DATABASE_URLne peut pas nommer la basepostgres, où les exécutions tiennent leurs sessions : l'exécution le dit. - Hors d'une exécution de bout en bout (
openTestDatabase(url)appelé par une spec de l'exécution unitaire, ou un projet sans pile HTTP) aucune mise en place globale n'a ouvert d'exécution : l'appel en ouvre une à lui, qui copie et vide elle-même la base migrée, dans le temps que cela prend, et tient une session de plus, celle de son verrou. Rien ne compte les fichiers qui le font en même temps, chacun une exécution qui voit les connexions restantes à son démarrage : chacun ouvre un petit pool, 4 connexions au plus (16 fichiers de ce genre à la fois tiennent dans les 100 connexions d'un serveur laissé tel qu'installé), et est refusé quand le serveur n'a pas de place pour lui à ce moment. Un refus avant tout fichier, et une part de ce que laisse le serveur, sont ce que donne une exécution de bout en bout ; hors d'elle, bornez vous-même les workers de l'exécution.
Ce que cela demande au serveur :
- le rôle de l'URL peut créer une base (
alter role <role> createdb) et possède la base migrée, ou est un super-utilisateur, et le serveur est PostgreSQL 13 ou plus récent (drop database ... with (force)) ; - personne d'autre n'est connecté à la base migrée quand l'exécution démarre, car PostgreSQL ne
copie une base qu'à cette condition : une application laissée en marche sur elle, ou une
console, fait échouer la mise en place globale après une dizaine de secondes, avec un message qui
le dit. Les fichiers ne s'y connectent jamais : ils copient le modèle de leur exécution par la
base
postgresdu serveur ; - rien des délais qu'un rôle, une base ou le serveur fixe pour les requêtes d'une application
(
alter role <rôle> set statement_timeout = '30s') : les sessions de l'exécution elle-même, celle qui tient son verrou et celles qui copient, vident et suppriment ses bases, mettentstatement_timeout,lock_timeoutet, à partir de PostgreSQL 17,transaction_timeoutà 0 pour elles-mêmes, puisque ce qu'elles font dure autant que la base est grande et qu'une exécution attend son tour derrière une autre. Elles n'ouvrent aucune transaction à elles :idle_in_transaction_session_timeoutne s'y applique donc jamais. Le pool de l'application sous test n'est pas une session de l'exécution : il garde les délais de son rôle, comme en production.
Un broker ou un serveur au protocole Redis reste le même pour tous les fichiers : avec son adresse dans l'environnement, la configuration de l'exécution de bout en bout garde les fichiers l'un après l'autre.
Sous Vitest, chaque mise en place globale renvoie son démontage : l'un supprime le cluster
enregistré, l'autre termine l'exécution sur le serveur, et vitest.e2e.config.ts nomme les deux.
Sous Jest, une mise en place est l'export par défaut de son fichier : jest.config.js nomme celle
qui enregistre le cluster, jest.e2e.config.js celle de l'exécution de bout en bout, qui
enregistre le cluster ou ouvre l'exécution sur un serveur, et
test/support/test-database-teardown.ts, nommé par globalTeardown, supprime le cluster ou
termine l'exécution ; les workers que Jest démarre après la mise en place héritent des variables
qu'elle définit (TEST_DATABASE_TEMPLATE, ou TEST_DATABASE_RUN et TEST_DATABASE_POOL_SIZE sur
un serveur). Un lanceur charge sa mise en place globale, et ce que ce fichier importe, avant
qu'aucun alias d'import du projet n'existe (Jest n'y applique aucun moduleNameMapper) : les
fichiers placés directement sous test/support/ s'importent par un chemin relatif de ce
répertoire (./test-database-run), le seul endroit où
imports/alias-only admet un chemin relatif. La mise en place
globale ne demande donc rien à ce qui démarre le lanceur. Les fichiers de spec d'un projet sous
Jest, si : ce sont des modules ES, que Jest ne charge que si Node tourne avec
--experimental-vm-modules. Les scripts générés le passent ; un npx jest -c jest.e2e.config.js
nu échoue avec Must use import to load ES Module, et
NODE_OPTIONS=--experimental-vm-modules npx jest -c jest.e2e.config.js, ou le lanceur d'un
éditeur à qui l'on donne cette variable, démarre l'exécution comme le script. Sous
"importExtension": "js", le chemin relatif se termine par le .ts de la source
(./test-database-run.ts) : le lanceur charge les sources à travers sa transformation, qui
trouve le fichier sous le nom qu'il porte, là où un .js nomme un fichier qui n'existe pas et
arrête l'exécution (Cannot find module), alors que le compilateur l'accepterait.
imports/alias-only tient cette terminaison, et tsconfig.json la laisse lire à la vérification
des types : "allowImportingTsExtensions": true, que le compilateur n'accepte qu'avec
"noEmit": true, tous deux remis à false dans tsconfig.build.json, si bien que le build émet
ce qu'il émettait sans eux. imports/alias-declared tient ces quatre lignes.
Sur le preset identity, les specs d'intégration sous
Jest prenaient 45 secondes de CPU avec un initdb par fichier de spec, et 26 avec la copie
(mesuré).
Ce qui se passe après la réponse (l'outbox relayée, les gestionnaires qu'elle atteint, ce qu'ils
enregistrent à leur tour) s'attend avec await application.settled(), puis se vérifie aussitôt.
Un délai fixe est lent quand il est long et instable quand il est court ; settled se résout dès
que l'outbox ne tient plus aucun événement en attente, et quand le temps est écoulé il échoue en
nommant ce qui attend encore et combien en a échoué.
Un système extérieur qui ne répond nulle part dans une exécution de test (le fournisseur d'identité
du preset identity) ferait retenter l'outbox sans fin, et settled() ne se terminerait jamais. Le
support partagé (test/e2e/support/start-application.ts) lui répond par son fake de
test/fakes/, lié dans contextsOfTheRun() : le preset identity y lie FakeIdentityProviderAdmin,
et qui ajoute un autre système extérieur y lie son fake.
Un cas d'usage qu'aucune route n'atteint est lancé par l'événement d'intégration que reçoit son
gestionnaire : sa spec de bout en bout (ddd-ts-kit generate e2e <context> <UseCase>, avec
--event <eventType> quand des gestionnaires de plusieurs événements envoient sa commande)
construit cet événement depuis la déclaration de l'amont, le remet à l'application qui tourne avec
await application.publish([event]), comme le ferait le relais de l'amont, puis attend
application.settled() avant de vérifier ce qu'un client ou un autre contexte observe.
Un cas d'usage que seul un job lance (generate job, ni route ni gestionnaire) reçoit la même
spec avec un autre départ : elle exécute le job comme le ferait l'ordonnanceur avec
await application.runJob('<context>.<job>') du support partagé, attend application.settled(),
et laisse à remplir ce qu'il faut observer. Le générateur cherche une route, puis un gestionnaire
qui envoie la commande, puis un job qui l'envoie, et nomme les trois quand il n'en trouve aucun. runJob échoue quand le job est par tenant et que
l'exécution n'a atteint aucun tenant (JobRun.tenants vaut 0, le job n'a jamais été appelé) :
ouvrez d'abord un tenant, après reset().
Un cas d'usage qu'un job en arrière-plan lance (generate background-job, mis en file par un
autre cas d'usage) est trouvé de la même façon, et sa spec a trois temps : la requête dont le cas
d'usage met le job en file, envoyée par l'API ; const ran = await application.runDueJobs(), qui
exécute ce qui est échu dans les files comme le ferait le worker, jusqu'à ce qu'il ne reste
rien, et répond le nom de chaque job exécuté ; puis application.settled() et ce qu'un client
observe. La spec générée vérifie que le job est parmi ran : elle échoue donc tant que la
requête qui met en file n'est pas écrite. runDueJobs rejette quand une exécution n'a pas réussi,
en nommant le job, l'issue et le code de l'erreur (The background job billing.void-invoice ended retried (UNEXPECTED_ERROR).), jamais son message. Dès son premier appel, la spec est le seul
consommateur des files : le worker du processus, qu'une file gardée en mémoire démarre, est
d'abord arrêté, donc aucun job ne se termine dans le dos de la spec. Un job mis en file avec
un délai n'est pas échu avant son heure : la spec de ses cas d'usage sur une horloge qu'elle
avance est la spec unitaire du job. --job <JobName> nomme un seul job, planifié ou en
arrière-plan, par sa classe ou par le nom sous lequel il s'exécute, y compris pour un cas d'usage
qu'une route atteint : sa spec est écrite à côté de celle de la route, dans
test/e2e/<use-case>-<job>.e2e.spec.ts.
L'acceptation d'une story est une spec de bout en bout écrite avant son code, à partir des
critères de la story (docs/architecture/stories/<story>.md) :
test/acceptance/<story>.acceptance.spec.ts, un scénario par critère, par l'API seulement. Chaque
scénario s'exécute enveloppé dans pending(...) de @ddd-ts-kit/testing/e2e, qui passe tant
qu'une assertion échoue et échoue dès que le scénario passe, ou s'arrête sur autre chose, si bien
qu'un scénario qui attend son code ne cache jamais un scénario cassé.
ddd-ts-kit acceptance <story> --lock enregistre ensuite une empreinte de chaque critère et de
chaque scénario : un scénario changé alors que son critère ne l'est pas, ou un critère changé, est
signalé et n'est verrouillé à nouveau qu'une fois que l'agent acceptance-judge, qui n'a pas fait
le changement, a laissé passer cette version précise ; jamais rendu plus facile à passer en silence. La slice qui satisfait un scénario retire son enveloppe ; la
story se clôt quand il n'en reste aucune (ddd-ts-kit acceptance <story> --gate passing).
Quoi tester où
Section intitulée « Quoi tester où »| Comportement | Niveau | Pourquoi là |
|---|---|---|
| « Un rendez-vous annulé ne peut pas être reprogrammé » | domaine | un invariant : aucune entrée-sortie nécessaire, des cas exhaustifs ne coûtent pas cher |
Bornes de TimeSlot (fin avant le début, durée nulle) |
domaine, piloté par une table | validation d'un objet-valeur |
« L'annulation publie scheduling.appointment.cancelled une fois que le gestionnaire de la commande a rendu la main ; un refus n'enregistre et ne publie rien » |
application | orchestration : charger, une intention, enregistrer |
| Chaque code d'erreur déclaré d'un cas d'usage | application | le contrat du gestionnaire |
« Un acteur sans appointment.cancel est refusé » |
application, avec le module d'autorisation listé | une propriété du câblage du contexte |
| « Seul le client qui a réservé peut annuler » (la politique) | unitaire, sur la politique seule | une fonction pure |
| Mapping de chaque colonne, concurrence optimiste, annulation de transaction | adaptateur | seule la vraie base de données peut le dire |
| La contrainte d'exclusion qui empêche la double réservation | adaptateur | la contrainte vit dans la base de données |
| Le fake et l'adaptateur sont d'accord | contrat, au niveau adaptateur | garde le niveau application digne de confiance |
| 401 sans justificatif d'identité, 403 sans la permission, le statut documenté avec elle | de bout en bout | toute la chaîne : HTTP, authentification, bus |
| « Une réservation entraîne la planification d'un rappel », à travers deux contextes | de bout en bout | traverse le bus d'événements ; à terme, si bien que le test attend le résultat |
| Code de statut et corps du document problem pour une entrée de mauvaise forme | spec de route | validation à la frontière |
| Ce qu'un contrôleur confie à son cas d'usage, le statut qu'il répond | spec du contrôleur ou de la route, envoyée par routeOf de @ddd-ts-kit/http/testing à un bus enregistreur |
la traduction de la frontière, gardes comprises |
| « Quand le patient annule, le suivi des présences le note » (une réaction) | spec de la réaction : le fait donné, la commande qu'un RecordingCommandBus de @ddd-ts-kit/kernel/testing a gardée vérifiée |
la décision de la réaction, pas ce que la commande fait ensuite |
Une réaction before-commit s'exécute dans la transaction, une réaction after-commit une fois celle-ci validée |
la suite du noyau, une fois | une garantie du kit, jamais prouvée de nouveau par un projet |
Deux principes découlent du tableau. Poussez chaque règle au niveau le plus bas qui peut la prouver : dix cas d'un délai d'annulation font dix tests d'une milliseconde sur l'agrégat, pas dix allers-retours HTTP. Et ne répétez pas une règle à chaque niveau : le test de bout en bout prouve le câblage avec un cas, le test du domaine prouve la règle avec tous.
Chaque unité de comportement a une spec (règle
test/spec-required), et six règles du plugin
ESLint tiennent la forme de chaque test : son titre énonce la règle qu'il prouve, en minuscules,
jamais should ni le nom d'une méthode (test/title-states-a-rule) ; il ne contient ni if, ni
boucle, ni try (test/no-logic) ; il vérifie un résultat (test/assertion-present), un refus par
son code et ses faits plutôt que par un message (test/refusal-by-code), et jamais un snapshot
(test/no-snapshot) ; et chaque test s'exécute, sans .only ni .skip (test/no-only-no-skip).
Préparation, action et vérification restent séparées par des lignes vides. Les six sont des
erreurs : les quatre qui lisent ce qu'un test dit étaient des avertissements en 0.89, pour que la
montée de version vers elles ne fasse jamais passer un lint vert au rouge.
Propriétés
Section intitulée « Propriétés »Un objet-valeur porte des lois vraies pour toute valeur, pas pour les trois qu'un test nomme : deux plages se chevauchent dans les deux sens ou dans aucun, un créneau est tenu au moins jusqu'à sa fin, un parse puis un format rendent la valeur. Une telle loi s'énonce une fois, en propriété, et se vérifie sur des valeurs générées :
import fc from 'fast-check';
it('overlaps another range in both directions or in none, for any two ranges', () => {  fc.assert(fc.property(anyRange(), anyRange(), (one, other) => one.overlaps(other) === other.overlaps(one)));});
generate property <context> <ValueObject> en commence une : une spec à côté de celle du value
object (test/unit/<name>.vo.properties.spec.ts), avec le générateur de valeurs bâti sur sa
fabrique, une première loi (égal à la valeur créée de nouveau depuis ses propres composants) et une
règle prévue par sorte de loi. fast-check rejoint les dépendances de développement avec la
première propriété (le générateur l'ajoute, ou npm i -D fast-check), sous Vitest comme sous Jest ; un projet sans propriété ne porte aucune dépendance morte. Le titre énonce la loi, pour que la page de
ce qu'énoncent les tests la lise ; fc.assert est une assertion pour test/assertion-present ; le
générateur (anyRange()) est une petite fonction auxiliaire de la spec bâtie sur les fabriques du
modèle, pour que toute valeur générée soit une valeur que le modèle accepte. Une exécution qui
échoue imprime la graine et le contre-exemple, réduit au plus petit. Une propriété est pour une loi
du modèle : un invariant, une symétrie, un aller-retour, une idempotence ; l'orchestration d'un cas
d'usage s'énonce par ses scénarios, avec des valeurs nommées, pas par une propriété. La spec
qu'écrit generate value-object se termine par une règle planifiée pour le rappeler :
keeps its invariants for any value a generator can produce, as a property. L'exemple en énonce
quatre, sur ses plages et ses créneaux.
Seuils de couverture
Section intitulée « Seuils de couverture »Un projet énonce la couverture minimale de chaque couche à un seul endroit, la clé coverage de
ddd-ts-kit.config.json (CONFIG.md) ; le lanceur de tests
la lit, et npm run verify comme le pipeline échouent en dessous. La référence, en
instructions, branches, fonctions, lignes :
| Couche | Référence | Pourquoi ce plancher | Mesurée par |
|---|---|---|---|
domain/ |
90, 85, 90, 90 | du code pur, rien n'empêche de le tester ; il porte les règles | specs unitaires |
application/ |
85, 80, 85, 85 | les gestionnaires s'exécutent avec des fakes | specs unitaires |
presentation/ |
80, 70, 80, 80 | mapping et traduction des statuts ; ses chemins d'erreur sont aussi tenus de bout en bout | specs unitaires |
infrastructure/ |
70, 60, 70, 70 | les chemins de défaillance des pilotes sont difficiles à provoquer ; les adaptateurs sont tenus par des suites de contrat | specs d'intégration |
Chaque contexte est tenu à part, couche par couche, dès le premier fichier source de la couche. Un
projet fraîchement généré passe : ce qu'écrit un générateur vient avec une spec qui l'exécute, et
les entrées it.todo nomment le comportement qui reste à prouver.
Ce que prouve un taux. Qu'une ligne, une branche ou une fonction s'est exécutée pendant qu'un test tournait. Une couche sous son plancher contient du code qu'aucun test n'a jamais exécuté : c'est certain, et c'est ce que la porte attrape.
Ce qu'il ne prouve pas. Que quoi que ce soit a été vérifié sur ce qui s'est exécuté, que les cas qui comptent ont été essayés, ou que le test échouerait si le comportement changeait. Une spec qui appelle un gestionnaire et ne vérifie rien le couvre entièrement. Les specs nommées d'après des règles métier, les suites de contrat et les parcours de bout en bout prouvent le comportement ; la couverture dit seulement où rien ne le fait.
Un plancher, pas un objectif. Relevez un seuil quand une couche est restée au-dessus ;
n'écrivez jamais un test pour faire bouger un nombre. Un seuil ne s'abaisse que par une dérogation
enregistrée, et la mesure n'est jamais rétrécie autour du code qui la fait échouer
(test/coverage-governed) : une branche non couverte est testée, ou supprimée quand rien ne peut
l'atteindre.
// au lieu de, dans vitest.config.ts : une mesure rétrécie à la main, refusée par test/coverage-governedtest: { coverage: { exclude: ['src/contexts/billing/infrastructure/**'], thresholds: { branches: 50 } } }
// écrivez : le lanceur lit ce qu'il mesure et ses planchers dans ddd-ts-kit.config.jsontest: { coverage: { provider: 'v8', ...governedCoverage(mode) } } // depuis @ddd-ts-kit/testing/coverage"coverage": { "infrastructure": { "branches": 50 } },"deviations": [ { "what": "coverage.infrastructure.branches", "adr": "0011", "reason": "The failure branches of the driver are held by its contract suite." }]Une boucle qui attend est une boucle qu'on saute : les specs d'un contexte tournent après chaque
changement, donc chaque fichier de spec est tenu au budget de temps de son niveau, cinq secondes
pour une spec unitaire et trente pour une spec d'intégration par la référence (budget de
ddd-ts-kit.config.json, baissé librement, monté seulement par une dérogation enregistrée). Le
reporter du lanceur, @ddd-ts-kit/testing/budget/vitest ou @ddd-ts-kit/testing/budget/jest, nomme
la spec la plus lente de chaque niveau à la fin de chaque exécution et avertit quand les tests et les hooks d'un fichier dépassent son budget, le chargement de ses modules laissé de côté ; il fait échouer l'exécution une fois que le projet impose le budget ("enforce": true sous budget), quand ses mesures sont stables, puisqu'une durée dépend de la charge de la machine autant que de la spec. Une spec unitaire lente cache un
monde reconstruit à chaque test au lieu d'être partagé (Mondes), des entrées-sorties
derrière ce qui devrait être un fake, ou une attente ; une spec d'intégration lente reconstruit un
schéma par test ou rejoue plus que le comportement qu'elle énonce. Les specs de l'application hors
des contextes, bout en bout, acceptation et architecture, ne sont pas tenues : un flux a le temps
qu'il lui faut ; une spec de la plateforme compte comme intégration, puisque ses adaptateurs
ouvrent une base. Sur l'exemple, la spec unitaire la plus lente prend 1,6 seconde et la spec
d'intégration la plus lente 11, sous charge.
Score de mutation
Section intitulée « Score de mutation »Un taux de couverture dit qu'une ligne a tourné sous un test ; un score de mutation dit qu'un test
remarquerait si la ligne changeait. Chaque nuit le pipeline lance Stryker sur les couches domaine et application de
chaque contexte (npm run test:mutation) : chaque mutant est un petit changement du code, une
condition inversée, une borne déplacée, un retour vidé, et les specs unitaires tournent contre
lui ; un mutant que les specs remarquent est détecté, un qu'elles laissent passer est un
survivant. Puis ddd-ts-kit mutation lit le rapport et tient chaque couche de chaque contexte à son
plancher mutation de ddd-ts-kit.config.json, 80 et 75 par la référence (CONFIG.md).
La config Stryker n'écrit ni glob ni nombre : elle étale governedMutation() de
@ddd-ts-kit/testing/mutation, qui mute les couches domaine et application de chaque contexte, écarte les textes
des refus par l'ignorer du kit, puisqu'un refus se vérifie par son code et jamais par son texte,
toute autre chaîne mesurée, et ignore les mutants statiques, ceux du code qui s'exécute une fois au
chargement du module. La règle
test/mutation-governed refuse un mutate, un
mutator, un ignoreStatic ou des thresholds écrits à la main.
Un survivant est une règle qu'aucun test n'énonce. Lisez-le comme une décision métier : quand le comportement est la règle, énoncez-la dans un test nommé d'après elle, comme l'essai sur l'exemple l'a fait pour un rappel retiré puis replanifié pour la même heure ; quand le comportement est un accident du code, ou une branche qu'aucun appelant n'atteint, laissez le mutant en vie et dites pourquoi, sans jamais le cacher par la configuration. Mesuré sur l'exemple le 2026-10-24 (README du pipeline) avec la configuration livrée : 1436 mutants, dont 163 textes de refus et mutants statiques laissés de côté, 1226 tués, 41 survivants, 6 sans couverture, 96,3 % en 5 minutes, le contexte le plus bas à 95,4 %. Avec la couche application, mesurée le même jour : 2412 mutants dans 283 fichiers, 96,1 % en 5 minutes 24 secondes, la couche application à 95,7 % et son contexte le plus bas à 93,5 % ; c'est la passe de tests initiale que la nuit paie, pas les mutants.
Une pull request reçoit une lecture de son changement, pas la mesure complète : le job
mutation-changed du pipeline réutilise le rapport de la dernière nuit pour ce que le changement
ne touche pas (le mode incrémental de Stryker, une minute environ sur l'exemple quand le changement reste dans le domaine, les cas d'usage et les specs), relance la mesure complète, cinq minutes environ, quand le changement touche un code dont les tests dépendent et que Stryker ne compare pas (une route, un adaptateur, un fake, un builder, un monde, la plateforme, une dépendance, le cas courant d'une fonctionnalité), puis liste les survivants des
fichiers que le changement a touchés (ddd-ts-kit mutation --changed <base>). Lisez-les avant de
demander une revue ; le plancher reste l'affaire de la nuit.
Documentation vivante
Section intitulée « Documentation vivante »Le métier demande aux tests ce que Gherkin promet : une lecture des règles dans ses propres mots. Le
kit la donne sans seconde langue : le titre d'un test énonce une règle (test/title-states-a-rule),
et ddd-ts-kit docs écrit docs/behaviour/<context>.md d'après les titres des specs de chaque
contexte, lus comme une spécification : un titre par cas d'usage, dans les mots de la spec de son
handler (Cancel invoice (command)), qui réunit les règles de son handler, de sa policy, de son
contrôleur ou de sa route, de sa spec de bout en bout et de ses scénarios d'acceptation ; un titre
par partie du modèle (Slot (value object), in calendars) et par réaction ; les specs qui
n'entrent dans aucun sous leur répertoire, titrées en mots elles aussi (Not banned (guard)). Sous
chaque titre viennent d'abord les règles écrites
pour le projet, puis les titres qu'un template de spec du kit a écrits, mot pour mot (Generated by the kit), pour qu'un relecteur lise ce que le projet a ajouté ; une règle planifiée (it.todo)
vient en dernier, et elle comme une spec mise de côté sont dites comme telles. Un titre qui cite la
ligne du plan qu'il sert (#US5.02 AC1 a customer places an order) montre la ligne avant la règle,
et la page finit par Rows of the plan, chaque ligne citée et le nombre de titres qui la citent : un
relecteur vérifie que chaque ligne de règle de la ligne dans docs/architecture/slices.md a son
titre. docs/behaviour/application.md garde les specs hors des contextes qui
ne servent aucun cas d'usage (parcours, architecture). npm run docs:generate les écrit, le hook de pre-commit les régénère et
les ajoute quand une spec est indexée (un worker confiné à son contexte les laisse au tronc),
docs --check les tient à jour, et elles sont commitées avec les specs : le test est la preuve,
la page sa lecture. Sur l'exemple,
scheduling liste 632 règles d'après 169 specs, 63 de ses 635 titres tels que le kit les a générés, une table de cas comptant pour une règle.
Un fichier .feature promettrait la même lecture, au prix d'une glu de step definitions, d'une
seconde grammaire à enseigner et d'une dérive que le pipeline ne voit pas. Gherkin ne paie que si
le métier écrit lui-même les scénarios ; il est alors une entrée pour les specs d'acceptation
d'une story, jamais le moteur.
Limites et quand ne pas l'utiliser
Section intitulée « Limites et quand ne pas l'utiliser »- La mesure complète tourne chaque nuit ; une pull request reçoit une lecture de son changement. Cinq minutes pour le domaine des quatre contextes de l'exemple, c'est trop long pour la boucle d'un changement : le job de la nuit tient le plancher, et une pull request liste les survivants des fichiers qu'elle a touchés d'après une passe qui réutilise les résultats de la nuit quand le changement reste dans le modèle et les cas d'usage, jamais une porte ; un survivant trouvé la nuit est une règle à énoncer le lendemain.
- Un score de mutation dit qu'un changement a été remarqué, pas que la bonne règle a été énoncée. Un test qui tue un mutant énonce ce que le code fait aujourd'hui : chacun se lit comme une décision métier avant d'être gardé, et un comportement accidentel reste en vie et on le dit, plutôt que d'être figé.
- Un score de mutation ne dit rien d'une règle écrite en déclaration. Les mutants statiques sont
ignorés, ceux du code qui s'exécute une fois au chargement du module : les transitions d'une
machine à états, une constante, une expression régulière déclarée en haut d'un fichier. Une
transition fausse dans une telle table ne fait baisser aucun score, et le test qui énonce la règle
en est la seule preuve ;
ddd-ts-kit mutationmontre les mutants ignorés de chaque contexte à côté de son score. Sur l'exemple, 90 des 1436 mutants sont statiques, dont la déclaration de la machine à états des rendez-vous. - Un fake ne vaut que ce que vaut sa suite de contrat. Un comportement que la suite ne couvre pas peut différer en silence : collation et tri SQL, moment d'application des contraintes, gestion des fuseaux horaires. Quand un bogue vient d'un tel trou, ajoutez le cas à la suite, pas seulement à un adaptateur.
- PostgreSQL dans le processus n'est pas le serveur de production. Les specs rapides des adaptateurs s'exécutent sur PGlite ; une dernière exécution d'intégration contre le vrai serveur reste nécessaire, et les README des adaptateurs d'ORM disent que MySQL et SQLite sont hors de la suite automatisée, sauf les registres de Knex, tenus à leurs suites de contrat sur une base SQLite en mémoire dans l'exécution unitaire.
- Les règles d'existence vérifient des fichiers, pas leur contenu.
test/spec-requiredettest/builder-requiredvérifient que le fichier existe ; une spec qui ne contient que desit.todoles satisfait. Les règles de forme lisent chaque test, pas si les cas qui comptent ont été essayés :expect(true).toBe(true)passetest/assertion-present. Des todos restants signifient que le travail n'est pas fini :ddd-ts-kit todoles liste, etstory --gate closerefuse de clore une story tant qu'il reste unit.tododes siens. test/no-mocksest un avertissement par défaut et concerne les tests d'un contexte. Du code existant en cours d'adoption, ou un SDK tiers sans point d'injection, peut justifier un mock ; faites-en une décision enregistrée plutôt qu'une habitude.- Les tests de bout en bout d'un comportement à terme sont plus lents et demandent du soin. Ils
attendent un résultat au lieu de dormir, et une attente mal bornée fait un test instable.
settledcompte ce que tient l'outbox : ce qu'un broker livre ensuite à ses consommateurs s'attend aveccollectEvents(...).waitFor, et une projection lue par l'API aveceventually. - Aucun test de performance, de charge ou de sécurité ne fait partie de cette stratégie, ni aucun test de contrat piloté par les consommateurs entre des services déployés séparément : les documents OpenAPI et AsyncAPI générés, avec leurs vérifications de dérive, tiennent les contrats à la place. Après l'extraction d'un service, envisagez de l'ajouter (Quand extraire des microservices).
- Gerard Meszaros, xUnit Test Patterns, Addison-Wesley, 2007 : Test Double et ses variantes (Dummy, Stub, Spy, Mock, Fake), antécédents du Test Data Builder (Creation Method).
- Martin Fowler, « Mocks Aren't Stubs » (2007), « TestDouble », « TestPyramid », « ContractTest » et « GivenWhenThen », martinfowler.com.
- Steve Freeman et Nat Pryce, Growing Object-Oriented Software, Guided by Tests, Addison-Wesley, 2009 : la pratique mockiste, « only mock types that you own », les builders de données de test (chapitre 22).
- Nat Pryce, « Test Data Builders: an alternative to the Object Mother pattern », 2007 (natpryce.com).
- Vladimir Khorikov, Unit Testing Principles, Practices, and Patterns, Manning, 2020 : la résistance à la refactorisation comme propriété d'un bon test.
- Dan North, « Introducing BDD », 2006 (dannorth.net) : étant donné / quand / alors.
@ddd-ts-kit/testingetpipeline/README.md.
Voir aussi
Section intitulée « Voir aussi »- Code propre
- Agrégats
- Ports et composition
- Garanties de livraison et consommateurs idempotents
- Lanceurs de tests
- Analyse statique et pipeline
- Référence de l'architecture : sections 5 et 7, règles
test/spec-required,test/no-mocks,test/builder-required