
@ddd-ts-kit/kernel
Les blocs de base dont dépend chaque contexte, et rien d'autre : aucun framework, aucun ORM,
aucun logger, aucune dépendance. C'est le seul package du kit que domain/ peut importer ;
application/ l'importe aussi, avec @ddd-ts-kit/auth à côté pour les permissions et les
politiques.
npm i @ddd-ts-kit/kernelTrois points d'entrée : @ddd-ts-kit/kernel (les blocs de base, les ports, les interfaces
standard et leurs doubles), @ddd-ts-kit/kernel/declarations (les décorateurs par lesquels une
classe dit ce qu'elle est, voir « Déclarations ») et @ddd-ts-kit/kernel/testing (les bus
enregistreurs d'une spec, voir « La spec d'une réaction »).
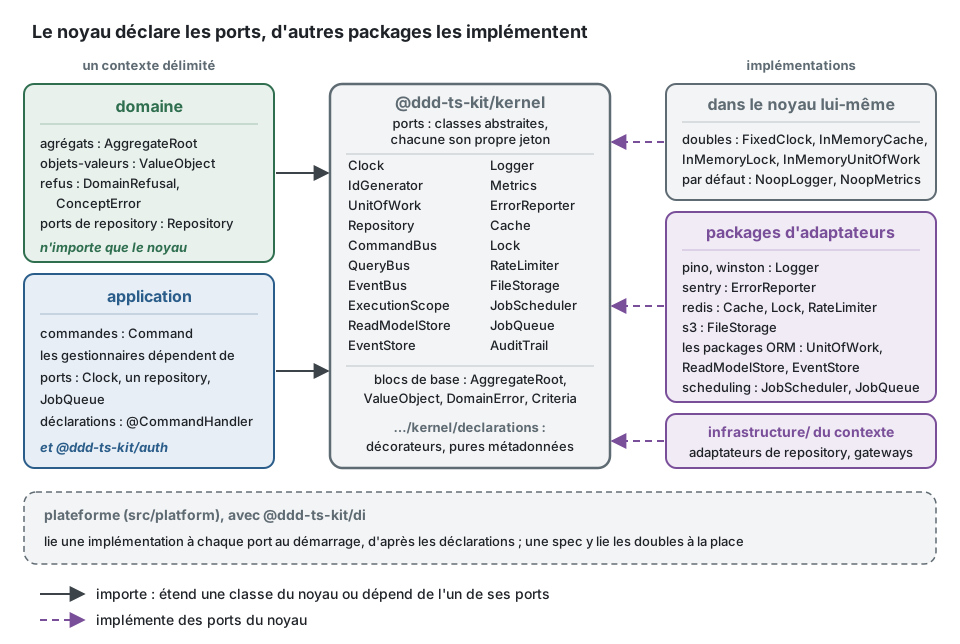
Le noyau dit ce dont un contexte a besoin (un Clock, un UnitOfWork, un Logger) et
jamais comment : chaque port est une classe abstraite aux seuls membres abstraits. Ses
implémentations vivent ailleurs : les doubles et les versions en processus du noyau lui-même
pour les tests et un processus unique, les packages d'adaptateurs du kit (@ddd-ts-kit/pino,
@ddd-ts-kit/redis, @ddd-ts-kit/s3, les packages ORM, ...) pour la production, et
l'infrastructure/ de chaque contexte pour ses propres repositories et gateways. La
plateforme en choisit une par port au démarrage, si bien qu'une règle métier ne change jamais
avec une bibliothèque.
| Thème | Exports |
|---|---|
| Domaine | Entity, AggregateRoot (version, événements enregistrés), ValueObject, DomainEvent, DomainError avec un code stable, ConceptError (les erreurs d'un concept, chacune construite par une fabrique statique : voir « Erreurs du domaine »), DomainRefusal (une classe par refus, construite par des fabriques statiques), FactualRefusal, isRefusal, CodeOf, RefusalOf, Refusal, RefusalFacts, le générique InvariantViolation, NotFoundError, ConflictError (et UniqueViolationError, une valeur qu'une contrainte d'unicité garde déjà détenue), ConcurrencyError, PreconditionFailedError, Result avec ok, err, unwrap |
| Ports | Clock, IdGenerator, UnitOfWork, Repository (classes abstraites : chacune est son propre jeton d'injection), UseCase, DependencyKind (les rôles que déclare une liaison, lus par di, le traçage et les aspects : repository, gateway, external, use-case, publisher, consumer, domain-event-handler, job) |
| Bus | Command, Query, CommandBus, QueryBus, BusMiddleware, les InMemoryCommandBus et InMemoryQueryBus en processus (register(type, handler, { context }) nomme le contexte délimité dans MessageInfo), unitOfWorkMiddleware |
| Événements | IntegrationEvent, IntegrationEventPublisher, IntegrationEventSubscriber, EventBus (les deux à la fois), EventSubscribers (l'abonné de chaque contexte délimité), ProcessedEventStore, idempotent, InMemoryEventBus (exécute chaque gestionnaire d'un événement, puis rejette avec une AggregateError des échecs ; avec { failures: 'as-thrown' }, la valeur par défaut d'une prochaine version mineure, l'échec d'un seul gestionnaire est relancé tel quel, avec son code), EventBusFailures, DomainEventDispatcher, IntegrationEventCallback et DomainEventCallback (les fonctions que reçoivent un abonné et un distributeur), executionContextOfEvent, inEventScope, scopedPublisher, EventDelivery (ce qu'un fournisseur dit d'une livraison : tentative, dernière tentative, transport, source, consommateur), messagingSystemOf |
| Événements du domaine et unité de travail | dispatchingOnSave (l'enveloppe qui fait remettre par un repository ce qu'ont enregistré les agrégats qu'on lui confie), announceDomainEvents, withinUnitOfWork (ce sur quoi repose chaque UnitOfWork.run : file, distribution avant la validation, phase after-commit), unitOfWorkStage et UnitOfWorkStage, DomainEventPhase, DomainEventSubscription, SaveAfterCommitError, AfterCommitFailure, reportAfterCommitFailures, InMemoryDomainEventDispatcher |
| Machines à états | defineStateMachine, StateMachine, TransitionError, InvalidStateMachineError, mermaidOfStateMachine (voir « Machines à états ») |
| Acteur | Actor, AuthorizedCommand, AuthorizedQuery, ActorContext, systemActor |
| Interfaces standard | Session, ExecutionContext et ExecutionScope, Logger, Metrics, ErrorReporter, Cache, CacheInvalidation et CachePurger (avec cacheTag, tenantCacheTags, CachePurgeRequest, PublishedCacheInvalidation, PurgingPublisher, RepeatedCachePurger : voir « Purger les caches HTTP »), Lock, RateLimiter, Page et PageRequest, AuditStamp, TenantScoped, AuditTrail, AuditReader et AuditEntry |
| Jobs planifiés | JobScheduler, ScheduledJob, JobExecution, JobSchedule, JobOptions, JobDefinition, JobRun, JobDescription, parseJobSchedule, describeJobSchedule, jobPolicy, executionContextOfJob |
| Jobs en arrière-plan | JobQueue, BackgroundJob, BackgroundJobExecution, BackgroundJobPayloadSchema, processTimeoutDuePayload, EnqueueOptions, QueuedJob, QueuedJobStatus, backgroundJobPolicy, retryDelayMs, executionContextOfBackgroundJob, whenCommitted (voir « JobQueue ») |
| Gestionnaires de processus | ProcessManager, ProcessDecision, ProcessRunner, ProcessStore, InMemoryProcessStore, UnreadableProcessStateError (voir « ProcessRunner et ProcessStore ») |
| Fichiers | FileStorage, StoredFile, FileScanner, FileKeys, TenantFileKeys, FileStaging, FileUpload, fileUploadsMiddleware, FileInspection, FileError, InMemoryFileStorage, LocalFileStorage, PurgeStagedFiles (voir « FileStorage, StoredFile, FileScanner ») |
| Multitenance | tenantScopeOf, tenantReachOf, acrossTenants, tenantKey, tenantCacheKey, isTenantId, TenantDirectory, InMemoryTenantDirectory (voir « Multitenance ») |
| Event sourcing | EventSourcedAggregate, EventStore, defineStoredEvent, EventSerializer, EventSourcedRepository, SnapshotPolicy, personalData, PersonalDataCipher, CatchUpSubscription, EventStoreProjectionRebuild, InMemoryEventStore, PostgresEventStore (voir « Event sourcing ») |
| Données personnelles | personalFields, PersonalDataErasure, PersonalDataExport, eraseDataSubject, exportDataSubject, PersonalDataExportDocument, inEachTenant, recordsInEachTenant, isDataSubjectId, PersonalDataRecord, InMemoryPersonalData (voir « Données personnelles ») |
| Côté lecture | Criteria, defineCriteria, validateCriteria, scoped, planCriteria, evaluateCriteria, pageOfPlan, hydrate, ReadModelStore, stampOf, TableReadModelStore, ProjectionRebuild, InMemoryReadModelStore (voir « Critères », « Hydratation » et « Projections ») |
| Aides à la persistance | optimisticUpdate, expectVersion (la version qu'un appelant a lue, If-Match en HTTP, est toujours la version courante, sinon PreconditionFailedError : 412), schemaNameOf, stampCreation, stampUpdate, tenantScopeOf, encodeCursor, decodeCursor |
| Remontée des erreurs | ErrorReporter, ErrorReport, errorReportOf, reportOnce, isUnexpectedError, errorReportingMiddleware, DeadLetterReports, reportProcessFailures, NoopErrorReporter |
| Doubles | FixedClock, SequentialIdGenerator, InMemoryUnitOfWork, FixedActorContext, FixedExecutionScope, InMemoryLogger, InMemoryMetrics, InMemoryErrorReporter, InMemoryCache, InMemoryCacheInvalidation, InMemoryCachePurger, InMemoryLock, InMemoryRateLimiter |
Tests (@ddd-ts-kit/kernel/testing) |
RecordingCommandBus, RecordingQueryBus : des bus qui gardent chaque message qu'on leur confie, dans l'ordre (executed), et répondent ce que la spec leur a dit (answering(type, answer)), rien sinon (voir « La spec d'une réaction ») |
Déclarations (@ddd-ts-kit/kernel/declarations) |
Requires, Public, CommandHandler, QueryHandler, IntegrationEventHandler, DomainEventHandler, Scheduled, Background, Projection, On, applyingProjection, Repository, Gateway, Adapter, Policy, Edge (pour les décorateurs d'un package de transport, comme @Controller), injected, injectedDependencies, declarationOf, listDeclarations, DeclarationError, Token, describeToken, tokenIdentity, portDefect |
Les règles que servent ces blocs sont dans docs/ARCHITECTURE.md.
Un premier agrégat
Section intitulée « Un premier agrégat »Les quatre blocs de base d'un modèle, dans un seul fichier pour la lecture (un projet donne à
chacun son propre fichier, et ddd-ts-kit generate les écrit) :
import { AggregateRoot, DomainRefusal, Entity, ValueObject, NamedDomainEvent } from '@ddd-ts-kit/kernel';
// Les codes du contexte, dans <context>.codes.ts, et ses refus, une classe chacun (voir « Erreurs du domaine »).export const OrderingCodes = {  InvalidQuantity: 'INVALID_QUANTITY',  OrderAlreadyPlaced: 'ORDER_ALREADY_PLACED',  OrderEmpty: 'ORDER_EMPTY',} as const;
export class InvalidQuantity extends DomainRefusal {  readonly code = OrderingCodes.InvalidQuantity;
  static forUnits(units: number) {    return InvalidQuantity.refusal(`${units} is not a positive whole quantity.`, { units });  }}
export class OrderAlreadyPlaced extends DomainRefusal {  readonly code = OrderingCodes.OrderAlreadyPlaced;
  static forOrder(orderId: string) {    return OrderAlreadyPlaced.refusal(`Order ${orderId} is already placed.`, { orderId });  }}
export class OrderEmpty extends DomainRefusal {  readonly code = OrderingCodes.OrderEmpty;
  static onPlacement(orderId: string) {    return OrderEmpty.refusal(`Order ${orderId} has no line to place.`, { orderId });  }}
// Un objet-valeur : immuable, comparé par valeur, valide dès sa construction.export class Quantity extends ValueObject<{ readonly units: number }> {  private constructor(props: { readonly units: number }) {    super(props);  }
  static create(units: number): Quantity {    if (!Number.isInteger(units) || units <= 0) {      throw InvalidQuantity.forUnits(units);    }
    return new Quantity({ units });  }
  get units(): number {    return this.props.units;  }}
// Une entité : connue par son identité, atteinte seulement par sa racine d'agrégat.export class OrderLine extends Entity {  constructor(    productId: string,    readonly quantity: Quantity,  ) {    super(productId);  }}
// Un événement du domaine : un fait passé, nommé <contexte>.<agrégat>.<fait>.export class OrderPlaced extends NamedDomainEvent('ordering.order.placed') {  constructor(    readonly aggregateId: string,    readonly occurredAt: Date,    readonly lineCount: number,  ) {    super();  }}
// La racine d'agrégat : la seule entrée, chaque règle vérifiée par une méthode d'intention.export class Order extends AggregateRoot {  private readonly lines: OrderLine[] = [];  private placed = false;
  private constructor(id: string) {    super(id);  }
  static open(id: string): Order {    return new Order(id);  }
  add(productId: string, quantity: Quantity): void {    if (this.placed) {      throw OrderAlreadyPlaced.forOrder(this.id);    }
    this.lines.push(new OrderLine(productId, quantity));  }
  place(now: Date): void {    if (this.placed) {      throw OrderAlreadyPlaced.forOrder(this.id);    }
    if (this.lines.length === 0) {      throw OrderEmpty.onPlacement(this.id);    }
    this.placed = true;    this.record(new OrderPlaced(this.id, now, this.lines.length));  }}
// Ce que vérifie une spec de l'agrégat :const order = Order.open('o-1');order.add('p-7', Quantity.create(2));order.place(new Date('2026-01-05T09:00:00Z'));
order.pullEvents(); // [OrderPlaced { aggregateId: 'o-1', lineCount: 1, ... }]Quantity.create(2).equals(Quantity.create(2)); // true : même valeurnew OrderLine('p-7', Quantity.create(1)).equals(new OrderLine('p-7', Quantity.create(5))); // true : même identité| Bloc | Ce que le noyau lui donne |
|---|---|
Entity<Id> |
id et equals : deux entités sont égales quand leur classe et leur id le sont |
ValueObject<Props> |
des props gelées, equals par valeur (les dates par leur instant, les listes et les enregistrements en profondeur), toJSON |
AggregateRoot<Id> |
une entité avec version, le jeton de concurrence optimiste que gère l'adaptateur de son repository, record(event) pour ses méthodes et pullEvents(). Les événements enregistrés ne sont pas énumérables : décomposer, comparer ou sérialiser un agrégat ne les voit jamais |
DomainEvent |
une interface : name, occurredAt, aggregateId |
Plutôt que de changer l'état depuis l'extérieur, où chaque appelant doit se souvenir de la règle :
order.status = 'placed'; // rien ne vérifie que la commande a des lignesevents.push({ name: 'ordering.order.placed' }); // et rien ne lie le fait au changementécrivez une méthode d'intention sur l'agrégat, qui vérifie la règle et enregistre le fait du même geste :
order.place(clock.now());Result, ok, err et unwrap servent au projet dont les objets-valeurs renvoient leur refus
au lieu de le lever ("stack.valueObjects": "result"). Pourquoi chaque bloc existe :
Agrégats et
Entités et objets-valeurs.
Erreurs du domaine
Section intitulée « Erreurs du domaine »Un refus métier est une DomainError : une réponse que le code a prévue, connue partout par son
code. Un contexte a une classe par refus, nommée d'après ce qui est refusé, qui étend
DomainRefusal ; ses fabriques statiques sont nommées d'après ce sur quoi porte le refus, et le
code de chaque refus du contexte est écrit une seule fois, dans la liste fermée
<context>.codes.ts :
import { DomainRefusal } from '@ddd-ts-kit/kernel';
declare const calendar: { readonly id: string };declare const slot: { readonly startsAt: Date };
// scheduling.codes.tsexport const SchedulingCodes = {  SlotTaken: 'SLOT_TAKEN',  UnknownAppointment: 'APPOINTMENT_NOT_FOUND',} as const;
export type SchedulingCode = (typeof SchedulingCodes)[keyof typeof SchedulingCodes];
// domain/errors/slot-taken.error.tsexport class SlotTaken extends DomainRefusal {  readonly code = SchedulingCodes.SlotTaken;
  static forCalendar(calendarId: string, startsAt: Date) {    return SlotTaken.refusal(      `The slot starting at ${startsAt.toISOString()} on calendar ${calendarId} is already held.`,      { calendarId, startsAt },    ).exposing('startsAt');  }}
// domain/errors/unknown-appointment.error.tsexport class UnknownAppointment extends DomainRefusal {  readonly code = SchedulingCodes.UnknownAppointment;
  static forAppointment(appointmentId: string) {    return UnknownAppointment.refusal(`Appointment ${appointmentId} does not exist.`, { appointmentId });  }}
throw SlotTaken.forCalendar(calendar.id, slot.startsAt);| Membre | Ce qu'il fait |
|---|---|
readonly code |
écrit par la classe, lu dans la liste de son contexte sous son propre nom : un code par classe, quelle que soit la fabrique |
protected static refusal(message, facts?) |
construit le refus d'une fabrique : une instance de la classe sur laquelle il est appelé, typée avec son code et ces faits. Le constructeur est protégé et une sous-classe n'en déclare aucun, si bien qu'en dehors de sa classe un refus n'existe que par une fabrique |
protected exposing(...names) |
appelé sur le refus par sa fabrique : ces faits peuvent sortir du processus. Aucun ne le peut par défaut |
protected causedBy(cause) |
appelé par sa fabrique : l'erreur que ce refus traduit, comme cause |
message, name, cause |
comme sur toute DomainError ; name est la classe |
facts |
chaque fait donné à la fabrique, en données simples (RefusalFacts : textes, nombres, booléens, dates, null, listes de ceux-ci), pour le code qui attrape l'erreur et pour les tests |
exposedFacts |
les faits qu'un client peut lire : ce que @ddd-ts-kit/http écrit sous facts dans le document problem |
toJSON() |
{ name, code, message }, plus facts quand certains sont exposés : jamais la pile, la cause ni un fait privé |
static is(error) |
restreint ce qui a été attrapé à ce refus, avec les faits de chacune de ses fabriques |
Plutôt qu'une Error nue, que rien en aval ne distingue d'un bug :
throw new Error(`Slot ${startsAt.toISOString()} is taken`); // signalée comme inattendue, renvoyée en 500écrivez le refus, que chaque couche connaît par son code :
throw SlotTaken.forCalendar(calendar.id, slot.startsAt); // une réponse prévue : un 4xx de code SLOT_TAKENLe statut HTTP de chaque code se choisit dans la couche de présentation, à un seul endroit ; les
journaux d'erreurs, les spans et le journal d'audit enregistrent le code, et le rapporteur
d'erreurs laisse une DomainError tranquille (les deux exceptions sont sous « ErrorReporter »).
Les codes que lèvent les paquets du kit forment eux aussi une liste, KitCodes, avec son type KitCode :
KitCodes.Forbidden vaut 'FORBIDDEN', KitCodes.ValidationFailed vaut 'VALIDATION_FAILED', et de même pour
NotFound, Conflict, InvariantViolation, Unauthorized, NotAcceptable, ConcurrencyConflict,
InvalidCriteria, InvalidPageRequest, Timeout, CircuitOpen, BulkheadFull, AttemptsExhausted,
ServiceUnavailable, PreconditionFailed, PreconditionRequired, FileTooLarge, UnsupportedMediaType,
FileNotFound, FileRejected et InvalidFileKey. Une route les nomme dans errors et un test les attend
(rejects.toMatchObject({ code: KitCodes.Forbidden })) sans écrire la chaîne : l'éditeur complète la clé,
et une clé mal orthographiée ne compile pas.
Les codes d'un contexte forment un vocabulaire fermé, SchedulingCode : isRefusal(error, SchedulingCodes)
restreint ce qui a été attrapé à l'un d'eux, si bien qu'un switch sur son code est exhaustif, et
la classe d'un refus connaît ses faits :
import { isRefusal } from '@ddd-ts-kit/kernel';
if (isRefusal(error, SchedulingCodes)) {  switch (error.code) {    case 'SLOT_TAKEN':      return 'choose another slot';    case 'APPOINTMENT_NOT_FOUND':      return 'book again';  }}
if (SlotTaken.is(error)) {  retryAfter(error.facts.startsAt); // une Date}
isRefusal(error, 'SLOT_TAKEN'); // quelle que soit la classe : tout ce qui suit s'appuie sur le code
Une fabrique laisse son type de retour être inféré : une annotation : SlotTaken cacherait ses
faits à is.
Les faits sont privés. Un message est écrit pour un humain et renvoyé au client comme
detail ; les faits sont des données, et restent dans le processus sauf si la fabrique nomme
ceux qui peuvent sortir. N'exposez jamais ce qui identifie une personne. Le journal d'audit et
les spans n'enregistrent que le code.
Une classe par concept est la forme de ConceptError, et fonctionne toujours : une classe
réunit les refus d'un concept, chacun une fabrique nommée d'après le refus qui donne son propre
code, et CodeOf<typeof AppointmentError> est l'union de ses codes.
import { ConceptError, type CodeOf } from '@ddd-ts-kit/kernel';
export class AppointmentError extends ConceptError {  static slotTaken(calendarId: string, startsAt: Date) {    return AppointmentError.refusal('SLOT_TAKEN', `The slot at ${startsAt.toISOString()} is held.`, {      calendarId,      startsAt,    }).exposing('startsAt');  }}
export type AppointmentErrorCode = CodeOf<typeof AppointmentError>; // 'SLOT_TAKEN'
ConceptError a les membres ci-dessus, mais refusal(code, message, facts?) prend le code, et
AppointmentError.is(error, 'SLOT_TAKEN') restreint à un code de la classe. ConceptError et
DomainRefusal partagent FactualRefusal, les faits et leur exposition, que lit
@ddd-ts-kit/http.
Une classe par erreur est la forme de 0.1 et 0.2, et fonctionne toujours : DomainError est
toujours abstraite sur code, son constructeur toujours public, et InvariantViolation,
NotFoundError, ConflictError et ConcurrencyError, chacune un refus sous un code fixe, se
construisent toujours avec new.
export class SlotTakenError extends DomainError { readonly code = 'SLOT_TAKEN';}Un projet dit quelle forme il écrit avec "stack.refusals" dans ddd-ts-kit.config.json
(named, ce qu'écrit init ; factories, une classe par concept ; ou classes, ce que veut dire
une config sans la clé) ; les règles errors/* tiennent les deux premières, et
ddd-ts-kit error-factories fait passer un projet des autres à named. Les formes peuvent vivre
dans un même projet.
Machines à états
Section intitulée « Machines à états »import { AggregateRoot, DomainRefusal, defineStateMachine } from '@ddd-ts-kit/kernel';
export const ParcelStatus = { Registered: 'registered', Shipped: 'shipped', Delivered: 'delivered' } as const;export type ParcelStatus = (typeof ParcelStatus)[keyof typeof ParcelStatus];
// shipping.codes.ts, puis une classe par refusexport const ShippingCodes = { ParcelUnpaid: 'PARCEL_UNPAID', ParcelTransitionRefused: 'PARCEL_TRANSITION_REFUSED',} as const;
export class ParcelUnpaid extends DomainRefusal { readonly code = ShippingCodes.ParcelUnpaid;
static forParcel(parcelId: string) { return ParcelUnpaid.refusal(`Parcel ${parcelId} is not paid yet.`, { parcelId }); }}
export class ParcelTransitionRefused extends DomainRefusal { readonly code = ShippingCodes.ParcelTransitionRefused;
static forParcel(parcelId: string, from: ParcelStatus, transition: string) { return ParcelTransitionRefused.refusal(`Parcel ${parcelId} cannot ${transition} once ${from}.`, { parcelId, from, transition, }); }}
// Ce sur quoi les transitions sont jugées : l'agrégat le passe à `next`.interface ParcelMoment { readonly parcelId: string; readonly paid: boolean;}
// domain/state-machines/parcel.state-machine.tsexport const parcelLifecycle = defineStateMachine({ states: Object.values(ParcelStatus), initial: [ParcelStatus.Registered], transitions: { ship: { from: [ParcelStatus.Registered], to: ParcelStatus.Shipped, guard: ({ parcelId, paid }: ParcelMoment) => (paid ? undefined : ParcelUnpaid.forParcel(parcelId)), }, reroute: { from: [ParcelStatus.Shipped] }, deliver: { from: [ParcelStatus.Shipped], to: ParcelStatus.Delivered }, }, refused: ({ from, transition }, { parcelId }: ParcelMoment) => ParcelTransitionRefused.forParcel(parcelId, from, transition),});
// domain/aggregates/parcel.aggregate.ts : l'agrégat interroge la machine, il ne teste jamais son statut à la mainexport class Parcel extends AggregateRoot { private status: ParcelStatus = parcelLifecycle.start(ParcelStatus.Registered);
private constructor( id: string, private readonly paid: boolean, ) { super(id); }
static register(id: string, paid: boolean): Parcel { return new Parcel(id, paid); }
ship(): void { this.status = parcelLifecycle.next(this.status, 'ship', this.moment()); }
deliver(): void { this.status = parcelLifecycle.next(this.status, 'deliver', this.moment()); }
private moment(): ParcelMoment { return { parcelId: this.id, paid: this.paid }; }}
Parcel.register('p-1', false).ship(); // lève PARCEL_UNPAID : la garde a refuséParcel.register('p-2', true).deliver(); // lève PARCEL_TRANSITION_REFUSED : registered ne peut pas deliver
parcelLifecycle.allowedFrom(ParcelStatus.Shipped); // ['reroute', 'deliver']parcelLifecycle.isFinal(ParcelStatus.Delivered); // trueLe cycle de vie d'un agrégat, dans domain/state-machines/<aggregate>.state-machine.ts.
next(from, transition, context) renvoie le statut suivant ou lève : le refus que refused
construit à partir d'une fabrique statique pour une transition que l'état ne permet pas, ou le
refus d'une garde. start(state) vérifie un état initial, can(...) répond sans lever,
allowedFrom(state) et isFinal(state) lisent le graphe, describe() le donne sous forme de
données et mermaidOfStateMachine(description) sous forme de diagramme Mermaid. Une transition
sans to garde l'état. Une déclaration qui nomme un état inconnu lève InvalidStateMachineError
au chargement du fichier. Pourquoi, et la règle qui y tient l'agrégat :
Machines à états.
Événements du domaine et unité de travail
Section intitulée « Événements du domaine et unité de travail »Un effet d'un événement du domaine n'existe que si le changement d'état qui l'a enregistré est validé.
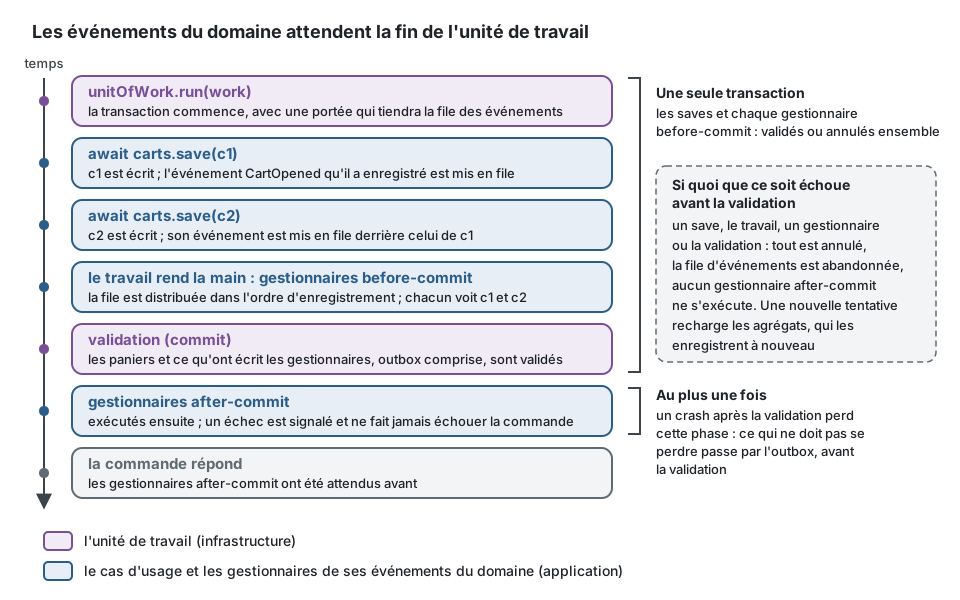
Un agrégat enregistre ses événements ; rien dans un cas d'usage ne les remet. Un repository
enveloppé par dispatchingOnSave(repository, () => dispatcher) les tire lui-même, une fois
résolue une méthode à laquelle on a confié l'agrégat :
const orders = dispatchingOnSave(new KnexOrderRepository(db), () => dispatcher);
await unitOfWork.run(async () => {  await orders.save(order);            // persisté ; les événements qu'a enregistrés `order` sont mis en file  await orders.saveAll([first, second]);  await orders.remove(order);          // un événement « deleted » est mis en file avec la suppression});                                    // distribués ici, dans l'ordre d'enregistrement, avant la validation
kernelModule() de @ddd-ts-kit/di l'applique à chaque liaison de type repository, si bien
qu'une application n'écrit jamais cette ligne ; le tableau de ce qu'il garantit (ordre,
réentrance, échecs, ordre des enveloppes) est dans le README de ce package. En bref :
- Dans une unité de travail, un save ne fait que mettre en file, dans l'ordre d'enregistrement sur l'ensemble des saves. Une fois le travail terminé, toujours dans la transaction, la file est distribuée : chaque gestionnaire voit chaque save. Les événements enregistrés par des gestionnaires qui enregistrent attendent derrière les autres, dans le même ordre, sans récursion. Puis la transaction est validée.
- Les événements ne sont tirés que si l'appel a réussi. Le premier gestionnaire
before-commitqui échoue rejette l'unité de travail ; le travail, un save ultérieur ou la validation aussi. Les événements en file sont alors abandonnés et jamais remis sur les agrégats : une nouvelle tentative les recharge. - Hors de toute unité de travail, le save distribue avant de se résoudre, les gestionnaires
before-commitpuis lesafter-commit.
Toute la chronologie, avec les doubles du noyau et rien d'autre, telle qu'une spec la mettrait en place :
import { NamedDomainEvent,  AggregateRoot,  InMemoryDomainEventDispatcher,  InMemoryUnitOfWork,  dispatchingOnSave,  type DomainEvent,} from '@ddd-ts-kit/kernel';
class CartOpened extends NamedDomainEvent('shop.cart.opened') {  constructor(    readonly aggregateId: string,    readonly occurredAt: Date,  ) {    super();  }}
class Cart extends AggregateRoot {  static open(id: string, now: Date): Cart {    const cart = new Cart(id);
    cart.record(new CartOpened(id, now));
    return cart;  }}
class InMemoryCarts {  readonly saved: string[] = [];
  async save(cart: Cart): Promise<void> {    this.saved.push(cart.id);  }}
const journal: string[] = [];const dispatcher = new InMemoryDomainEventDispatcher();const carts = dispatchingOnSave(new InMemoryCarts(), () => dispatcher);const unitOfWork = new InMemoryUnitOfWork();
dispatcher.on(CartOpened.eventName, async (event) => {  journal.push(`before-commit ${event.aggregateId} sees ${carts.saved.join(' and ')}`);});dispatcher.on(CartOpened.eventName, async (event) => void journal.push(`after-commit ${event.aggregateId}`), {  phase: 'after-commit',});
const now = new Date('2026-01-05T09:00:00Z');
await unitOfWork.run(async () => {  await carts.save(Cart.open('c1', now));  journal.push('saved c1');  await carts.save(Cart.open('c2', now));  journal.push('saved c2');});
// journal : saved c1, saved c2,//           before-commit c1 sees c1 and c2, before-commit c2 sees c1 and c2,//           after-commit c1, after-commit c2
pullEvents() reste public pour cette enveloppe et pour les specs d'un agrégat ; un cas d'usage
et un adaptateur de repository ne l'appellent jamais. Un agrégat se reconnaît à ce qu'il fait
(il a pullEvents), si bien qu'un contexte compilé contre une autre copie du noyau est suivi lui
aussi.
Deux phases
Section intitulée « Deux phases »| Phase | Déclarée | S'exécute | Un échec |
|---|---|---|---|
before-commit (par défaut) |
dispatcher.on(name, callback) |
à la fin de l'unité de travail, dans sa transaction | fait échouer la commande ; tout est annulé |
after-commit |
dispatcher.on(name, callback, { phase: 'after-commit' }) |
une fois la transaction validée, jamais quand elle a été annulée, dans l'ordre de distribution, attendue avant que la commande réponde | ne fait jamais échouer la commande : remonté, et les autres gestionnaires s'exécutent quand même |
Avec les déclarations, la phase est une option du décorateur :
@DomainEventHandler(OrderPaid, { phase: 'after-commit' }).
La phase after-commit vaut au plus une fois : un crash entre la validation et l'exécution la
perd. Ce qui ne doit pas se perdre passe par l'outbox sous forme d'événement d'intégration. Un
gestionnaire before-commit ne peut avoir que des effets que la transaction couvre, car la
validation peut encore échouer après son exécution
(domain-events/transactional-before-commit).
DomainEventDispatcher.dispatch(events, phase?) exécute les gestionnaires d'une phase,
before-commit par défaut. InMemoryDomainEventDispatcher(failed?) est informé de chaque échec
d'un gestionnaire after-commit et garde les cent derniers dans afterCommitFailures, pour les
specs. reportAfterCommitFailures({ reporter, logger, scope? }) est le failed à lui donner
partout où existent un logger et un rapporteur d'erreurs : une entrée Logger.error (« A
domain event handler failed after the commit », avec domainEvent, errorType, errorCode) et
l'erreur remise à l'ErrorReporter sous l'opération after-commit <event name>.
Un gestionnaire after-commit qui confie un agrégat à un repository enveloppé (save,
saveAll, remove(aggregate)) est refusé avant l'écriture avec SaveAfterCommitError :
l'unité de travail est terminée. Il envoie une commande par le CommandBus, qui ouvre sa propre
unité de travail. unitOfWorkStage() répond 'outside', 'open', 'before-commit' ou
'after-commit'.
La spec d'une réaction
Section intitulée « La spec d'une réaction »Qu'un gestionnaire before-commit s'exécute dans la transaction et qu'un gestionnaire
after-commit s'exécute une fois celle-ci validée est une garantie du noyau, prouvée une fois
par sa propre suite : la spec d'une réaction ne la prouve pas de nouveau. Elle donne le fait à
la réaction et vérifie ce que la réaction a envoyé. Un gestionnaire d'événement de domaine, un
gestionnaire d'événement d'intégration et un contrôleur envoient des commandes par le
CommandBus qu'ils reçoivent : RecordingCommandBus de @ddd-ts-kit/kernel/testing garde
chacune de celles qu'on lui confie, dans l'ordre, dans executed, et répond ce que la spec lui
a dit avec answering(type, answer) (un identifiant, ou un refus que la fonction lève), pour les
commandes de type et de ses sous-classes, rien sinon. Aucun gestionnaire ne s'exécute : ce que fait la commande est la spec de son propre
gestionnaire. RecordingQueryBus fait de même pour les requêtes. Les specs que
ddd-ts-kit generate écrit pour ces rôles partent de là :
import { Command, type CommandBus, type DomainEvent } from '@ddd-ts-kit/kernel';import { RecordingCommandBus } from '@ddd-ts-kit/kernel/testing';
class ScheduleReminderCommand extends Command {  constructor(readonly invoiceId: string) {    super();  }}
/** Quand une facture est émise, un rappel est planifié pour elle. */class InvoiceIssuedEventHandler {  constructor(private readonly commands: CommandBus) {}
  async handle(event: DomainEvent): Promise<void> {    await this.commands.execute(new ScheduleReminderCommand(event.aggregateId));  }}
const issued: DomainEvent = { name: 'billing.invoice.issued', aggregateId: 'invoice-1', occurredAt: new Date(0) };const commands = new RecordingCommandBus();
await new InvoiceIssuedEventHandler(commands).handle(issued);
export const sent = commands.executed; // [new ScheduleReminderCommand('invoice-1')]
Une unité de travail à vous
Section intitulée « Une unité de travail à vous »La file vit dans une portée AsyncLocalStorage ouverte par withinUnitOfWork(work, transaction).
InMemoryUnitOfWork et les unités de travail des packages ORM reposent dessus, si bien qu'un
run appelé directement (un consommateur, un script) a le déroulement d'une commande.
unitOfWorkMiddleware l'appelle aussi : une commande est couverte même avec un UnitOfWork qui
ne le fait pas. Un run imbriqué, ou une commande envoyée depuis une unité de travail, rejoint
la portée en cours : une seule distribution, à la fin de la plus externe, et la phase
after-commit après la validation la plus externe. Deux commandes concurrentes ne partagent
jamais une portée.
Un UnitOfWork écrit dans un projet construit run dessus. transaction commence, appelle ce
qu'on lui donne, valide quand cela s'est résolu et annule quand cela a été rejeté :
run<T>(work: () => Promise<T>): Promise<T> {  return withinUnitOfWork(work, (scoped) => {    if (this.current.getStore() !== undefined) { // imbriqué : rejoindre la transaction      return scoped();    }
    return this.database.transaction((transaction) => this.current.run(transaction, scoped));  });}
unitOfWorkContract de @ddd-ts-kit/testing/contracts fait échouer un adaptateur qui l'a
oublié.
Déclarations
Section intitulée « Déclarations »Une classe dit ce qu'elle est, et la racine de composition s'assemble à partir de ce que disent
les classes. @ddd-ts-kit/kernel/declarations contient les décorateurs qui l'enregistrent. Ce ne
sont que des métadonnées : une déclaration n'instancie rien, ne résout rien, ne lit aucune
configuration et ne connaît aucun conteneur. C'est pourquoi ils vivent ici, où la couche
application peut les importer. Transformer les déclarations en liaisons est le travail de
@ddd-ts-kit/di (contextModule, discoverContext), et de rien d'autre.
import { Repository } from '@ddd-ts-kit/kernel';import type { Order } from '@/contexts/ordering/domain/aggregates/order.aggregate';
export abstract class OrderRepository extends Repository<Order> { abstract findOpenOf(customerId: string): Promise<readonly Order[]>;}import { Clock } from '@ddd-ts-kit/kernel';import { CommandHandler } from '@ddd-ts-kit/kernel/declarations';import { OrderRepository } from '@/contexts/ordering/domain/repositories/order.repository';import { PlaceOrder } from '@/contexts/ordering/application/commands/place-order/place-order.command';
@CommandHandler(PlaceOrder)export class PlaceOrderHandler implements CommandHandler<PlaceOrder> { constructor( private readonly orders: OrderRepository, private readonly clock: Clock, ) {}
async execute(command: PlaceOrder): Promise<string> { /* ... */ }}import { Clock, ExecutionScope } from '@ddd-ts-kit/kernel';import { Repository } from '@ddd-ts-kit/kernel/declarations';import { Database } from '@/contexts/ordering/application/ports/database.port';import { OrderRepository } from '@/contexts/ordering/domain/repositories/order.repository';
@Repository(OrderRepository)export class KnexOrderRepository implements OrderRepository { constructor( private readonly database: Database, private readonly scope: ExecutionScope, private readonly clock: Clock, ) {}
/* findById, save, findOpenOf */}Repository désigne deux choses sous un même nom, chacune dans son point d'entrée : la classe
abstraite qu'étend un port de repository (point d'entrée principal, importé par le port) et le
décorateur de son adaptateur (ce point d'entrée-ci, importé par l'adaptateur). Aucun fichier n'a
besoin des deux.
Ports et jetons
Section intitulée « Ports et jetons »Un port est une classe abstraite, et la classe est le jeton d'injection. La classe nomme la
dépendance et porte son type : un paramètre de constructeur typé par elle nomme ce qui est
injecté, et app.resolve(Clock) renvoie un Clock. Token<T> est ce type :
abstract new (...args: never) => T. Il n'y a ni constante de jeton ni fichier de jetons. Un port
a une place, une classe abstraite par fichier :
| Port | Fichier |
|---|---|
| un repository du domaine | domain/repositories/*.repository.ts |
| tout autre port, et une classe de valeur | application/ports/*.port.ts |
export abstract class PaymentGateway { abstract charge(orderId: string, amount: Money): Promise<PaymentReceipt>;}La règle du port. Un port n'a que des membres abstraits : aucun corps, aucun paramètre de
constructeur, aucun membre privé ou protégé. Un port peut étendre un autre port. Un adaptateur
implements son port et ne l'extends jamais. Le type reste structurel, si bien qu'un fake,
une classe en mémoire ou un simple littéral objet tient lieu de port sans cérémonie.
import { Clock } from '@ddd-ts-kit/kernel';import { Adapter } from '@ddd-ts-kit/kernel/declarations';
interface Money {  readonly amount: string;  readonly currency: string;}
interface PaymentReceipt {  readonly reference: string;  readonly paidAt: Date;}
// application/ports/payment-gateway.port.ts : uniquement des membres abstraitsexport abstract class PaymentGateway {  abstract charge(orderId: string, amount: Money): Promise<PaymentReceipt>;}
// infrastructure/external/http-payment-gateway.adapter.ts : implémente son port, ne l'étend jamais@Adapter(PaymentGateway, { kind: 'external' })export class HttpPaymentGateway implements PaymentGateway {  constructor(private readonly clock: Clock) {}
  async charge(orderId: string, amount: Money): Promise<PaymentReceipt> {    // l'appel au prestataire de paiement se place ici    return { reference: `${orderId}:${amount.amount}:${amount.currency}`, paidAt: this.clock.now() };  }}
// test/fakes : un simple objet est un PaymentGateway, puisque le type est structurelexport const acceptingGateway: PaymentGateway = {  charge: async (orderId) => ({ reference: `fake-${orderId}`, paidAt: new Date('2026-01-05T09:00:00Z') }),};
Repository<A, Id> est le contrat que partagent tous les repositories (findById,
save), sous forme de classe abstraite. Le port de repository d'un agrégat l'étend et ajoute
ses propres méthodes de recherche, comme OrderRepository plus haut ; l'adaptateur implémente
ce port.
Une valeur qui n'est pas un port (un objet de configuration, une connexion à la base, une
liste, une primitive) est typée elle aussi par une classe abstraite, avec des propriétés
abstract readonly, et un simple objet lui est lié avec toValue de @ddd-ts-kit/di :
export abstract class Database {  abstract readonly client: Knex;}
// contexts/ordering/application/ports/payment-settings.port.tsexport abstract class PaymentSettings {  abstract readonly apiKey: string;}
// racine de compositionbuilder.bind(Database).toValue({ client: knex });builder.bind(PaymentSettings).toValue({ apiKey: configuration.paymentApiKey });
C'est la seule manière : ni jeton chaîne, ni jeton symbole, ni utilitaire. Plutôt qu'un jeton à côté du type, deux noms à garder en phase :
export const PAYMENT_GATEWAY = Symbol('PaymentGateway');
constructor(@Inject(PAYMENT_GATEWAY) private readonly payments: PaymentGateway) {}
écrivez le type seul, qui est le jeton :
constructor(private readonly payments: PaymentGateway) {}L'identité à travers les copies. Une classe est sa propre identité, et deux copies d'un
package chargées dans un même processus (une installation dupliquée, un bundle à côté de
node_modules) contiennent deux classes. Un port qui déclare
static readonly tokenKey = '<package>.<Port>' est connu par cette clé à la place, la même dans
chaque copie : tokenIdentity(port) renvoie ce par quoi un conteneur indexe, et
describeToken(port) son nom. Chaque port injectable du noyau en porte une (kernel.Clock,
kernel.CommandBus, ...) ; Repository<A, Id> est une base à étendre, jamais un jeton, et n'en
porte aucune.
export abstract class PaymentGateway {  static readonly tokenKey = 'ordering.PaymentGateway';
  abstract charge(orderId: string, amount: Money): Promise<PaymentReceipt>;}
La limite, franchement : un port à vous qui ne déclare pas de tokenKey et qui est chargé deux
fois fait deux jetons. Ce qui est lié sous une copie n'est pas trouvé sous l'autre. Une
application compilée en un seul programme ne le rencontre jamais ; un port publié dans un
package qui peut être installé deux fois, ou embarqué dans un bundle à côté de
node_modules, déclare une tokenKey. La clé est l'identité : deux ports qui déclarent la même
clé sont le même jeton, alors préfixez-la par le package ou le contexte. Elle est déclarée,
jamais héritée : un port qui étend un port à clé déclare la sienne.
Quand en déclarer une : seulement pour un port qu'un processus peut charger depuis deux copies de son package. Un port d'une application, compilé une fois dans un seul programme, ne déclare jamais de clé : la classe suffit comme identité, et une clé ne serait qu'un nom à garder unique à la main.
Un port qui étend un port du noyau déclare sa clé comme n'importe quel autre, sans override :
les ports du noyau portent la leur comme propriété propre qui n'est pas un membre déclaré
(kernel.<ClassName>, posée dans un bloc statique), si bien que rien n'est redéfini.
export abstract class OrderRepository extends Repository<Order> {  static readonly tokenKey = 'ordering.OrderRepository';}
export abstract class BusinessClock extends Clock {  static readonly tokenKey = 'ordering.BusinessClock';}
Ce dont dépend une classe est dit par son constructeur. Un décorateur ne liste rien : chaque
paramètre du constructeur est typé par une classe, son jeton, et ddd-ts-kit docs lit les
signatures dans les sources pour le fichier généré du contexte, qui les enregistre avec
injected :
import { AggregateRoot, Clock, Command, Repository } from '@ddd-ts-kit/kernel';import { CommandHandler, injected, injectedDependencies } from '@ddd-ts-kit/kernel/declarations';
declare class Order extends AggregateRoot {  static place(id: string, customerId: string, now: Date): Order;}
export abstract class OrderRepository extends Repository<Order> {}
export class PlaceOrder extends Command<string> {  constructor(    readonly orderId: string,    readonly customerId: string,  ) {    super();  }}
@CommandHandler(PlaceOrder)export class PlaceOrderHandler implements CommandHandler<PlaceOrder> {  constructor(    private readonly orders: OrderRepository,    private readonly clock: Clock,  ) {}
  async execute(command: PlaceOrder): Promise<string> {    const order = Order.place(command.orderId, command.customerId, this.clock.now());
    await this.orders.save(order);
    return order.id;  }}
// contexts/ordering/ordering.declarations.ts, généréinjected(PlaceOrderHandler, [OrderRepository, Clock]);
injectedDependencies(PlaceOrderHandler); // [OrderRepository, Clock] : ce avec quoi un conteneur construit le gestionnaire
injected(Class, [Tokens]) enregistre un jeton par paramètre de constructeur, dans l'ordre, dans
un registre partagé par toutes les copies du noyau qu'un processus charge ;
injectedDependencies(Class) le relit, et c'est un conteneur (@ddd-ts-kit/di) qui s'en sert.
Rien ici ne lit design:paramtypes : ces métadonnées n'existent qu'avec les décorateurs hérités
compilés par tsc ou swc, et pas avec les décorateurs standard, ni sous tsx ou esbuild. Un
décorateur accepte encore une liste comme dernier argument,
@CommandHandler(PlaceOrder, [OrderRepository, Clock]) : la forme qu'écrivaient les projets
0.1. Une déclaration la porte alors dans dependencies, qui vaut undefined quand c'est le
constructeur qui le dit, et un conteneur lui donne la priorité.
Ce que le compilateur refuse, dans les deux modes de décorateurs :
- une liste, d'
injectedou d'un décorateur, qui ne nomme pas un port par paramètre de constructeur, chacun du type de son paramètre, dans l'ordre : une entrée manquante ou en trop, un mauvais type, un mauvais ordre ;injected(Class)sans liste pour un constructeur qui prend quelque chose ; - une classe qui n'implémente pas le port dont elle est déclarée l'adaptateur, et une classe abstraite ;
- une classe concrète nommée là où son port est attendu :
[InMemoryOrderRepository, Clock]pour un paramètre typéOrderRepository. Une liste nomme des ports, jamais ce qui les implémente.
Ce qui a changé quand la liste est devenue facultative : un décorateur sans liste accepte n'importe quel constructeur, si bien que le compilateur ne repère plus, au décorateur, une classe dont la liste a été oubliée. Il n'a pas à le faire : la liste est déduite du constructeur, vérifiée là où elle est générée, et une classe restée sans liste est refusée nommément quand l'application est composée.
Ce qui est refusé au chargement du fichier, avec une DeclarationError de @Repository,
@Gateway et @Adapter, parce que le compilateur ne peut pas le voir :
- un port avec un corps :
TalkativePharmacy implements greet: a port is an abstract class with abstract members only. Un membre hérité d'un port parent compte ; - un adaptateur qui étend son port :
CornerPharmacy extends Pharmacy: an adapter implements its port, it never extends it.
portDefect(port, implementation) est cette vérification, qui renvoie la raison ou undefined ;
un conteneur l'applique à une liaison faite à la main. Une classe liée à elle-même n'est pas un
port et n'est pas vérifiée.
Les décorateurs
Section intitulée « Les décorateurs »| Décorateur | Sur | Exemple |
|---|---|---|
Requires(permission, options?) |
une commande ou une requête qui porte son acteur | @Requires(permissions['visit.schedule'], { resource: (c: ScheduleVisit) => ({ type: 'patient', id: c.patientId }), audited: ['startsAt'] }) |
Public(options?) |
une commande ou une requête que n'importe qui peut envoyer | @Public() |
CommandHandler(Message) |
l'unique gestionnaire d'une commande | @CommandHandler(PlaceOrder) |
QueryHandler(Message) |
l'unique gestionnaire d'une requête | @QueryHandler(GetOrder) |
IntegrationEventHandler(definition, { consumer, actorOf? }) |
le gestionnaire d'un événement d'intégration d'un autre contexte | @IntegrationEventHandler(OrderPlaced, { consumer: 'billing.invoice-on-order-placed' }) |
DomainEventHandler(Event) |
un gestionnaire d'un événement du domaine de son propre contexte | @DomainEventHandler(OrderPaid), rattaché au nom que la classe de l'événement déclare une fois dans static readonly eventName |
Scheduled(name, schedule and options) |
un job déclenché par le temps, qui déclenche des cas d'usage | @Scheduled('billing.send-reminders', { cron: '0 7 * * 1-5', timeZone: 'Europe/Paris' }) |
Projection(name) avec On(definition) sur ses méthodes |
un projecteur : la classe qui tient un modèle de lecture à jour | @Projection('scheduling.appointment-list'), @On(PaymentCaptured) |
Repository(Port, options?) |
l'adaptateur d'un repository du domaine | @Repository(OrderRepository) |
Gateway(Port, options?) |
l'adaptateur d'un port qui appelle un autre contexte | @Gateway(StockGateway) |
Adapter(Port, options?) |
l'adaptateur de tout autre port | @Adapter(PaymentGateway, { kind: 'external' }) |
Policy(permission, { name }) |
une règle qui a besoin de l'élément chargé | @Policy(permissions['invoice.void'], { name: 'billing.only-issuer-voids' }) |
- L'accès se dit sur le message. Une commande étend
CommandouAuthorizedCommand, une requêteQueryouAuthorizedQuery: la classe de base dit déjà laquelle des deux elle est, si bien que le décorateur dit seulement qui peut l'envoyer. Le compilateur refuse@Requiressur un message sans acteur.auditedliste les champs qu'un journal d'audit peut enregistrer (un nom, ou{ field, masked: true }), en données simples ; le compilateur vérifie que le message les a. - Les dépendances se disent par le constructeur, comme plus haut. Une liste écrite en dernier argument d'un décorateur, la forme de 0.1, nomme un port par paramètre et est vérifiée par rapport au constructeur. Il n'y a ni décorateur de paramètre ni réflexion.
- Le rôle est vérifié aussi : un gestionnaire d'un autre message ou d'un autre résultat, un
gestionnaire d'événement d'une autre charge utile, un job sans
runsont refusés par le compilateur. - Options d'un repository, d'une gateway et d'un adaptateur :
transient: true(une instance par résolution au lieu d'une par application),replaces: true(prend la place d'une liaison faite plus tôt, comme une valeur par défaut du module du noyau),aspects: [...](enveloppes, la première la plus externe) ; un adaptateur prend aussikind: 'external' | 'publisher'. - Un seul nom pour le décorateur et pour la forme de sa classe :
CommandHandler,QueryHandler,IntegrationEventHandleretDomainEventHandlersont chacun un décorateur et un type, si bien qu'un seul import sert@IntegrationEventHandler(OrderPlaced, ...)etimplements IntegrationEventHandler<OrderPlacedPayload>. Un job implémenteScheduledJob. - Les noms sont écrits, pas déduits : le nom du consommateur, celui de la politique, celui du
job et celui de l'événement du domaine survivent au renommage d'une classe, et la chaîne
vide est refusée. Le nom d'un événement du domaine s'écrit une fois sur
sa classe,
extends NamedDomainEvent('..')oustatic readonly eventName: ses gestionnaires et ses projections l'y lisent (NamedDomainEventType), et une classe qui ne le déclare pas est refusée par le compilateur. - Une classe déclarée est son propre jeton :
@ddd-ts-kit/dilie un gestionnaire, un job ou une politique sous sa classe.
declarationOf(Class) renvoie ce qu'une classe a déclaré, en données simples gelées, ou
undefined ; listDeclarations() liste les classes déclarées que le processus détient encore,
pour le diagnostic. Une classe joue un seul rôle : une seconde déclaration sur la même classe
lève DeclarationError au chargement du fichier, tout comme @Requires ou @Public sur ce qui
n'est ni une Command ni une Query, et @Scheduled avec un nom ou une planification illisible.
Une déclaration n'est pas héritée par une sous-classe.
Les noms du point d'entrée principal diffèrent exprès : là-bas, IntegrationEventCallback et
DomainEventCallback sont les simples fonctions données à subscribe et à on, et
CommandHandler et QueryHandler sont les seules interfaces.
Où c'est stocké. Dans un registre par processus, atteint par Symbol.for, avec les classes
tenues faiblement. Un contexte compilé contre une copie du noyau est donc lu par un conteneur qui
en tient une autre (une installation dupliquée, un bundle à côté de node_modules), et un
module rechargé par un observateur de fichiers ne laisse aucune trace de ses anciennes classes.
Symbol.metadata n'est pas utilisé : Node 24 ne le définit pas, et le mode des décorateurs
hérités n'a pas de contexte pour le porter.
Pas dans le domaine. domain/ ne porte aucun décorateur : agrégats, entités, objets-valeurs,
événements du domaine, services du domaine et ports de repository ne déclarent rien. Un
événement du domaine est nommé par le gestionnaire qui y réagit, pas par lui-même. @UseCase
n'existe pas : l'arborescence canonique a un gestionnaire par commande et aucun service
d'application à lier.
Les événements d'intégration et leurs abonnés
Section intitulée « Les événements d'intégration et leurs abonnés »IntegrationEventPublisher est ce par quoi les cas d'usage publient, IntegrationEventSubscriber
ce sur quoi les gestionnaires sont abonnés, et EventBus les deux à la fois. EventSubscribers
donne à chaque contexte délimité son abonné : forContext(name) renvoie un
IntegrationEventSubscriber. Un seul bus sert tous les contextes par défaut ; un broker donne à
chaque contexte consommateur le sien, pour qu'un contexte extrait dans son propre processus garde
ses files d'attente. @ddd-ts-kit/di abonne les gestionnaires d'événements d'intégration d'un
contexte sur EventSubscribers.forContext(<context name>).
Scheduled
Section intitulée « Scheduled »@Scheduled('billing.send-reminders', { cron: '0 7 * * 1-5', timeZone: 'Europe/Paris' })export class SendRemindersJob implements ScheduledJob { constructor(private readonly commands: CommandBus) {}
async run(execution: JobExecution): Promise<void> { await this.commands.execute(new SendReminders(systemActor('billing.send-reminders'), execution.scheduledAt)); }}Un job vit dans application/scheduling/, dans un fichier *.job.ts, et ne fait que
déclencher des cas d'usage : il reçoit des bus et des ports par son constructeur et envoie
typiquement une commande. Le second argument est la planification et, à côté, les options :
| Clé | Par défaut | |
|---|---|---|
every |
un intervalle, en millisecondes ou '30s', '15m', '2h', '1d', aligné sur l'époque Unix |
|
cron, timeZone |
timeZone: 'UTC' |
les cinq champs standard ou un raccourci (@hourly, @daily, @weekly, @monthly, @yearly), sur les horloges d'un fuseau IANA |
overlap |
'skip' |
une occurrence qui arrive pendant que l'exécution précédente est en cours est sautée, ou mise en file derrière elle ('queue') |
missed |
'skip' |
les occurrences passées sans avoir été atteintes sont abandonnées, ou la dernière est exécutée une fois ('run-once') |
timeoutMs |
aucun | le signal d'une exécution plus longue est interrompu |
jitterMs |
0 |
un délai aléatoire avant chaque exécution |
enabled |
true |
fait pour être surchargé par la configuration là où le job est câblé |
singleInstance |
true |
le planificateur prend le Lock de chaque occurrence |
On écrit exactement l'un de every et cron, et le compilateur refuse le reste. Le nom est
<context>.<job-name> en minuscules, unique dans l'application. JobExecution est ce que reçoit
run : scheduledAt, startedAt, attempt et un signal d'interruption. Ce que signifient
les planifications lors d'un changement d'heure, ce que garantit une instance parmi plusieurs et
comment tester un job sont dans le README de @ddd-ts-kit/scheduling.
Background
Section intitulée « Background »@Background({ maxAttempts: 3, timeout: '10m' })export class CompileStatementsBackgroundJob implements BackgroundJob<CompileStatementsPayload> { static readonly jobName = 'billing.compile-statements';
// le schéma de sa charge utile, `zodSchema(z.object({ month: z.string() }))` ou toute bibliothèque de validation static readonly payload = compileStatementsPayload;
constructor(private readonly commands: CommandBus) {}
async run(payload: CompileStatementsPayload, execution: BackgroundJobExecution): Promise<void> { await this.commands.execute(new CompileStatements(execution.jobId, payload.month)); }}Un job en arrière-plan est nommé par son jobName statique, par lequel un cas d'usage le met
en file (jobs.enqueue(CompileStatementsBackgroundJob, { month }), la charge utile typée par
run). Son payload statique est le schéma de cette charge utile, un BackgroundJobPayloadSchema
(parse(input) qui répond un Result, ce qu'est le Schema de @ddd-ts-kit/validation, quelle
que soit la bibliothèque qu'il adapte) : le worker lit la charge utile stockée avec lui avant
chaque exécution et n'en exécute jamais une qu'il refuse (INVALID_JOB_PAYLOAD) ; le job des
délais d'un processus utilise processTimeoutDuePayload. Le décorateur prend les options, toutes facultatives : maxAttempts (5), backoff
({ baseMs: 1000, factor: 2, maxMs: 300000 }), timeout et lease (30 s), en millisecondes
ou '10m'. Un nom qui n'est pas <context>.<job-name>, une classe sans payload statique et des options
illisibles lèvent une DeclarationError au chargement du fichier. BackgroundJobExecution est ce que reçoit run :
jobId, attempt, enqueuedAt, startedAt, le checkpoint qu'une tentative précédente a
enregistré, un signal d'interruption, saveCheckpoint(value) et
reportProgress({ done, total }).
Modes de décorateurs
Section intitulée « Modes de décorateurs »Chaque décorateur de ce point d'entrée fonctionne sous les deux modes de décorateurs de
TypeScript, et la même ligne de source passe la vérification de types sous les deux, vérification
du rôle et d'une liste de dépendances comprises. Aucun n'a besoin d'emitDecoratorMetadata, et
ce que prend un constructeur se sait de la même manière dans les deux : lu dans la source,
enregistré par injected.
| Stack | tsconfig.json |
|---|---|
| class-validator, NestJS, entités TypeORM, toute bibliothèque à décorateurs hérités | "experimentalDecorators": true |
| tout le reste | laissez experimentalDecorators non défini : les décorateurs standard (TC39) n'ont besoin d'aucune option |
Un programme a un seul mode, et c'est pourquoi le kit suit le projet au lieu de choisir. Un
décorateur de classe reçoit d'abord la classe dans les deux modes ; l'appel standard ajoute un
contexte, que ces décorateurs ne lisent pas. Rien d'autre ne diffère : ni
emitDecoratorMetadata, ni reflect-metadata, ni décorateur de paramètre dans aucun des deux
modes. Les deux sont compilés par TypeScript 5, 6 et le TypeScript 7 natif. Sous Vitest, les
décorateurs hérités n'ont besoin de rien ; les standard ont besoin de decorators() de
@ddd-ts-kit/testing/vitest.
Interfaces standard
Section intitulée « Interfaces standard »Standard signifie que chaque projet construit avec le kit a la même forme sous le même nom, si bien qu'un adaptateur, un middleware ou un tableau de bord écrit une fois leur convient à tous. Extensible signifie qu'un projet ajoute ses propres champs sans dupliquer le type (voir « Comment étendre »).
La session authentifiée d'un acteur, en données simples.
| Champ | |
|---|---|
id, actor, issuedAt, expiresAt? |
qui, depuis quand, jusqu'à quand |
authenticationMethod |
none, password, sso, token, api-key, service, ou une chaîne du projet |
authenticationStrength? |
{ mfa?, assuranceLevel? } |
impersonatedBy? |
id de l'acteur du support qui agit en tant qu'actor ; logFieldsOf le porte sur chaque ligne de journal |
locale?, timeZone?, client? |
étiquette BCP 47, fuseau IANA, { ip?, userAgent? } en chaînes opaques |
scopes? |
ce que le titre d'accès permet à quiconque le présente (le scope d'OAuth 2.0) : une limite sur le client, jamais ce que l'acteur peut faire |
extensions |
les champs du projet |
hasScope(session, scope) lit les scopes ; un projet nomme une fois son vocabulaire de scopes
par fusion de déclarations de SessionScopes
(interface SessionScopes { readonly 'invoices:read': true }), et SessionScope, le type que
prend une garde, est alors ce vocabulaire au lieu de n'importe quelle chaîne.
isExpired(session, clock.now()), isImpersonated(session), anonymousSession(),
systemSession(name, issuedAt?), et isSession(value), la garde structurelle qu'une frontière
applique à ce qu'elle a reçu comme principal.
ExecutionContext et ExecutionScope
Section intitulée « ExecutionContext et ExecutionScope »Ce que porte chaque unité de travail, quoi qui l'ait déclenchée : correlationId,
causationId?, actor, session?, tenantId?, elevation? (le personnel de la plateforme qui
lit par-dessus les tenants, voir « Multitenance »), locale?, deadline?, scheduledAt?
(pour un job planifié, l'instant où il était dû), origin (http, event, schedule,
queue pour un job en arrière-plan, cli, ou une chaîne du projet) et extensions.
executionContext(init) en construit un et prend le tenant de l'acteur ;
withActor(context, actor) est le même travail vu par un autre acteur.
ExecutionScope (current(), require(), run(context, work)) donne le contexte du travail en
cours au code à qui on ne le passe pas. La frontière le pose une fois :
// présentation ou plateforme : un run par requête HTTP, événement consommé, jobscope.run(executionContext({ correlationId, actor, session, origin: 'http' }), () => handle(request));// infrastructure : un adaptateur de repositoryconst row = { ...toRow(order), ...stampCreation(scope, clock), ...tenantScopeOf(scope) };Les deux bouts, avec l'implémentation qui suit la chaîne d'appels asynchrones :
import {  AsyncLocalStorageExecutionScope,  FixedClock,  executionContext,  stampCreation,  tenantScopeOf,  type Actor,} from '@ddd-ts-kit/kernel';
const scope = new AsyncLocalStorageExecutionScope();const clock = new FixedClock(new Date('2026-01-05T09:00:00Z'));const actor: Actor = { id: 'u-42', type: 'user', tenantId: 'acme', roles: ['agent'], attributes: {} };
// la frontière : posé une fois pour la requête HTTPawait scope.run(executionContext({ correlationId: 'req-7f3a', actor, origin: 'http' }), async () => {  // ...la commande passe par le bus jusqu'à son gestionnaire, qui enregistre ; dans l'adaptateur du repository :  const row = { id: 'o-1', ...stampCreation(scope, clock), ...tenantScopeOf(scope) };  // { id: 'o-1', createdAt, createdBy: 'u-42', updatedAt, updatedBy: 'u-42', tenantId: 'acme' }  return row;});
Les cas d'usage et le domaine ne lisent jamais la portée : ils reçoivent l'acteur, et tout ce
dont ils ont besoin d'autre, dans la commande ou la requête (authz/actor-explicit). La portée
sert aux loggers, aux colonnes d'audit, au cloisonnement par tenant et aux en-têtes sortants.
Plutôt qu'un gestionnaire qui demande à la portée qui agit, une dépendance que sa signature
cache :
const actor = this.scope.require().actor;écrivez une commande qui porte son acteur, le premier argument d'une AuthorizedCommand, et
lisez command.actor dans le gestionnaire :
export class CancelOrder extends AuthorizedCommand { constructor(actor: Actor, readonly orderId: string) { super(actor); }}Un événement consommé ouvre son propre contexte : executionContextOfEvent(event, { consumer })
a pour origine event, la corrélation de l'événement (son id quand il n'en nomme aucune),
l'événement comme causationId, systemActor(consumer) comme acteur et le tenantId de
l'événement, si bien que le consommateur lit et écrit dans ce tenant seulement ;
inEventScope(scope, { consumer }, handler) enveloppe un gestionnaire avec. L'enveloppe standard
ne porte aucun acteur, pour qu'aucune donnée personnelle ne voyage par défaut : un projet dont
les enveloppes en nomment un passe actorOf. À la sortie, scopedPublisher(publisher, scope)
appose la corrélation et le tenant du travail en cours sur chaque événement publié sans eux,
si bien que tout ce qu'un même stimulus provoque se retrouve d'un processus à l'autre et reste
dans son tenant.
ActorContext demeure, inchangé. ScopedActorContext l'implémente par-dessus une portée :
l'acteur courant est l'acteur du contexte d'exécution courant, si bien que les deux ne peuvent
pas diverger. AsyncLocalStorageExecutionScope suit la chaîne d'appels asynchrones ;
FixedExecutionScope est le double de test, et suit un FixedActorContext quand on lui en
donne un.
debug, info, warn, error(message, fields?), child(fields), isLevelEnabled(level) et
flush(). LogFields énonce une fois les clés bien connues : correlationId, causationId,
context, actorId, tenantId, errorType, errorCode, durationMs ; toute autre clé est
acceptée. Un appel ne lève jamais, quels que soient les champs : quand ils ne peuvent être ni lus
ni sérialisés, l'entrée est écrite avec UNWRITABLE_FIELDS
(logError: "unserializable fields") à leur place. Le noyau n'écrit jamais sur la console :
NoopLogger est la valeur par défaut, InMemoryLogger enregistre des entries pour un test,
un adaptateur JSON lines est dans @ddd-ts-kit/aspects, et @ddd-ts-kit/pino et
@ddd-ts-kit/winston sont les adaptateurs de ces bibliothèques. Le domaine et les cas d'usage
ne journalisent pas.
Les erreurs sont des valeurs de journal. LogValue admet une Error, si bien que
logger.error('payment failed', { error }) compile tel quel, et un projet peut nommer la clé une
fois (interface LogFields { error?: Error }, voir « Comment étendre »). Une Error placée
directement sous une clé des champs est écrite par chaque logger telle que
describeError(error) la décrit, une ErrorDescription :
| Clé | |
|---|---|
type |
le nom de la classe |
code |
le code d'une DomainError ; absent pour toute autre erreur |
message |
le message |
stack |
la pile de cette seule erreur |
cause |
la cause, décrite de la même manière quand c'est une Error : huit erreurs de profondeur au plus, pour qu'une chaîne qui boucle se termine |
Plus profondément dans les champs (dans un objet imbriqué ou une liste), une erreur est laissée
au sérialiseur de l'adaptateur : passez-la sous une clé. describeErrorFields(fields) est la
copie des champs qu'écrit un logger ; un adaptateur à vous l'appelle et est tenu au résultat
par loggerContract.
Les messages des erreurs inattendues peuvent être retirés. Chaque logger du kit prend
scrubMessages: true (DescribeErrorOptions) : le message de toute erreur qui n'est pas une
DomainError devient SCRUBBED_MESSAGE ([message removed]) et sa pile perd sa première ligne,
qui le répète. Les messages des DomainError sont écrits par le projet et restent. C'est
l'option du même nom de @ddd-ts-kit/sentry, avec la même règle et le même marqueur. Par défaut
les messages sont gardés : un journal qui dit [message removed] coûte à chaque investigation.
Ce que le kit journalise de lui-même ne contient jamais de message. L'aspect logged,
loggingMiddleware et le planificateur de jobs ne remettent jamais une erreur à un logger :
ils écrivent errorType et errorCode, tels que identifyError(error) les donne, et l'erreur
elle-même va à l'ErrorReporter. Cela vaut quoi que dise scrubMessages. La description
complète est pour l'erreur qu'un projet décide de journaliser, dans un adaptateur ou une route ;
le retrait des messages est son choix explicite pour les journaux qui quittent ses mains.
isLevelEnabled(level) dit si une entrée de ce niveau serait écrite, pour le logger et ses
enfants. Interrogez-le avant de construire des champs coûteux ; le kit le fait, dans logged,
loggingMiddleware et le planificateur. NoopLogger répond false.
flush() se résout une fois que chaque entrée journalisée jusque-là, par le logger ou un
enfant, a été remise à sa destination, et ne rejette jamais. On l'appelle une fois, à l'arrêt du
processus, après la dernière entrée : l'application de @ddd-ts-kit/di l'appelle à la fin de
stop(). Ce qui est journalisé après un flush n'est pas spécifié, et ne lève jamais : pino et
StdoutLogger l'écrivent encore, winston, dont le flush termine le logger, l'abandonne. Un
second appel se résout aussi.
InMemoryLogger prend { level?, fields?, base?, scrubMessages? } comme un vrai adaptateur : un
seuil (par défaut debug, chaque entrée), des champs lus à chaque entrée, des champs ajoutés à
chaque entrée. Ses entries contiennent ce qu'écrit un logger : une erreur passée en champ est
enregistrée sous forme de sa description. CREDENTIAL_KEYS et REDACTED sont les noms de champs
et le marqueur avec lesquels StdoutLogger et les adaptateurs pino et winston masquent, et
isCredentialKey(name) la comparaison qu'ils partagent, sans tenir compte de la casse ;
InMemoryLogger ne masque rien.
counter(name).increment(labels?, by?), histogram(name).record(value, labels?),
gauge(name).set(value, labels?). Les valeurs des labels viennent d'un petit ensemble fermé,
jamais d'un identifiant. NoopMetrics est la valeur par défaut ; InMemoryMetrics enregistre
des samples et répond counterValue, histogramValues et gaugeValue pour un sous-ensemble de
labels.
ErrorReporter
Section intitulée « ErrorReporter »report(error, report) et flush(timeoutMs) : là où vont les échecs inattendus pour être
examinés, un traqueur d'erreurs. report est synchrone : il met en file et rend la main, ne lève
jamais et n'attend jamais le traqueur ; flush attend la file avant l'arrêt du processus et ne
rejette jamais. ErrorReport est en données simples, uniquement des identifiants : origin,
operation, context, correlationId, traceId, actorId, tenantId, errorCode,
severity (fatal, error, warning) et les extensions du projet. NoopErrorReporter est
la valeur par défaut, InMemoryErrorReporter enregistre des reports pour un test, et
@ddd-ts-kit/sentry est l'adaptateur pour Sentry et GlitchTip.
Aucun gestionnaire, agrégat ou repository ne l'appelle : ils lèvent. Ce qui les entoure remonte, chaque pièce attachée de l'extérieur :
| Point de capture | Est | Remonte |
|---|---|---|
| bus | errorReportingMiddleware(reporter, scope), premier sur le bus |
une commande ou une requête qui échoue avec autre chose qu'une DomainError ; silencieux pendant la consommation d'un événement |
| HTTP | reportHttpErrors(reporter) de @ddd-ts-kit/http, en onError |
chaque requête HTTP répondue en 5xx |
| jobs | reportFailedRuns(reporter) de @ddd-ts-kit/scheduling, en onRun |
une exécution qui a échoué avec autre chose qu'une DomainError |
| événements | new DeadLetterReports(reporter) : onFailure sur le hook du fournisseur, observing(subscriber) autour de son abonné |
un événement que son fournisseur abandonne, jamais une livraison retentée |
| processus | reportProcessFailures(reporter) |
uncaughtException et unhandledRejection, puis code de sortie 1 après un flush |
Une DomainError est un refus métier et n'est jamais remontée, sauf si HTTP la répond en 5xx ou
si elle enterre un événement (un warning). Toutes passent par reportOnce : le premier point
de capture qui voit un objet d'erreur le remonte, les frontières qu'il traverse ensuite le
reconnaissent, si bien qu'une commande qui échoue dans une requête HTTP ou un job fait un seul
rapport, au nom de la commande. errorReportOf(error, source, executionContext?) construit le
rapport : les ids d'origine, de corrélation, d'acteur et de tenant viennent du contexte
d'exécution, jamais passés à la main.
import { FixedClock, InMemoryCache, cacheKey } from '@ddd-ts-kit/kernel';
interface Quote {  readonly pair: string;  readonly rate: string;}
const quoteKey = (pair: string) => cacheKey<Quote>('quote', pair);
const clock = new FixedClock(new Date('2026-01-05T09:00:00Z'));const cache = new InMemoryCache(clock, { maxEntries: 500 });
await cache.set(quoteKey('EUR-USD'), { pair: 'EUR-USD', rate: '1.0842' }, { ttlMs: 60_000 });const hit: Quote | undefined = await cache.get(quoteKey('EUR-USD')); // la cotation, typée par sa clé
clock.advance(60_000);await cache.get(quoteKey('EUR-USD')); // undefined : expirée, selon l'horloge
La clé porte le type de sa valeur. InMemoryCache(clock, { maxEntries? }) expire selon le
Clock et est borné. tenantCacheKey<Quote>(scope, 'quote', pair) est la même clé confinée au
tenant du travail en cours : ce qu'un tenant a mis en cache n'est jamais servi à un autre.
Purger les caches HTTP
Section intitulée « Purger les caches HTTP »Deux ports, pour qu'un cas d'usage ne puisse jamais purger avant sa validation :
| Port | Appelé par | Fait |
|---|---|---|
CacheInvalidation.invalidate(tags) |
un gestionnaire before-commit de l'événement du domaine qui a changé ce que montrent les réponses |
demande que les tags soient purgés une fois le travail validé ; domain-events/transactional-before-commit le permet |
CachePurger.purge(tags) |
le relais de l'outbox, jamais un cas d'usage (refusé avant la validation) | purge un cache partagé tout de suite : InMemoryCachePurger ici, Varnish et les CDN dans @ddd-ts-kit/http/purgers |
cacheTag('calendar', id) nomme une ressource (calendar:c-1, l'identifiant encodé en pourcent),
cacheTag('calendar') toutes les ressources d'un type ; les routes de @ddd-ts-kit/http
étiquettent leurs réponses avec la même fonction.
PublishedCacheInvalidation({ publisher, ids, clock, scope, perTenant? }), ce que lie
kernelModule() de @ddd-ts-kit/di, publie une CachePurgeRequest sur le publisher, les
tags sous le tenant du travail (tenantCacheTags) quand perTenant est posé, comme le pose
une application multitenant dont les réponses sont étiquetées par tenant (un travail qui ne
nomme aucun tenant est alors refusé avec NoCurrentTenantError : sa purge ne rencontrerait
aucune réponse) : derrière une outbox, c'est une ligne de la transaction, disparue avec une
annulation, conservée à travers un crash après la validation.
new PurgingPublisher(purger, broker) est ce par quoi le relais publie : les demandes de purge
vont au purgeur, les autres événements au broker, et une purge échouée lève pour que le relais
la retente. new RepeatedCachePurger(purger, { againAfterMs, onFailure? }) purge, puis purge les
mêmes tags une fois de plus againAfterMs plus tard, pour une lecture qui a chargé l'état
précédent avant la validation et atteint le cache après la première purge ; la seconde purge est
au mieux, remontée à onFailure. InMemoryCacheInvalidation retient les tags demandés
(invalidated), pour les specs.
import type { Lock } from '@ddd-ts-kit/kernel';
declare function exportEverything(): Promise<void>;
export async function nightlyExport(lock: Lock): Promise<void> {  const handle = await lock.acquire('nightly-export', { ttlMs: 60_000, waitMs: 0 });
  if (handle === undefined) { // quelqu'un d'autre tient la clé    return;  }
  try {    await exportEverything();  } finally {    await handle.release();  }}
Un mutex entre processus, pour éviter de faire deux fois le même travail. acquire renvoie
undefined quand la clé est tenue, tout de suite ou après waitMs ; le verrou se libère de
lui-même après ttlMs ; le fencingToken d'un LockHandle croît à chaque acquisition d'une
clé, si bien qu'une ressource qui retient le plus élevé refuse un détenteur dont le verrou a
expiré. C'est un outil d'efficacité, jamais la garde d'un invariant : ce qui ne doit pas arriver
deux fois est refusé par une contrainte de la base de données.
InMemoryLock(clock, { retryDelayMs?, sleep? }) exclut à l'intérieur d'un processus et expire
selon le Clock : le fake, et assez pour une instance unique. L'adaptateur entre processus est
dans @ddd-ts-kit/redis. acquiring(attempt, waitMs, waiting) est la boucle de nouvelles
tentatives que partagent les adaptateurs.
FileStorage, StoredFile, FileScanner
Section intitulée « FileStorage, StoredFile, FileScanner »// La commande enveloppe ce que le contrôleur a reçu : le bus le met en zone de transit avant l'ouverture de la transaction.this.document = new FileUpload(received, 'appointment-documents');
// Le gestionnaire, dans l'unité de travail :const { file, fileName } = command.document; // un StoredFile, en transit et analyséappointment.attachDocument(unwrap(AttachedDocument.create(file, fileName, now)), now);await appointments.save(appointment);await staging.promoteOnCommit(file.key); // déplacé vers sa clé avec la validationFileStorage contient le contenu des fichiers, jamais la base de données : put (un flux en
entrée, mesuré et haché, refusé avec FILE_TOO_LARGE au-delà de maxBytes, sans rien laisser),
get (un flux en sortie), stat, delete, copy, move, list(prefix), et des liens signés
courts, signedDownloadUrl et signedUploadUrl (au plus MAX_SIGNED_URL_SECONDS, une heure).
Aucune méthode ne prend ni ne renvoie un fichier entier. Une clé est vérifiée par isFileKey
(des segments de lettres, de chiffres, de ., de - et de _, aucun ne commençant par un
point) avant que quoi que ce soit soit touché, et FileKeys la génère sur le serveur :
TenantFileKeys(ids, clock, scope) écrit tenants/<tenant>/<area>/<year>/<month>/<id>, le
segment du tenant seulement quand le travail en cours en nomme un (l'id du tenant tel quel :
le noyau refuse tout autre caractère que lettres, chiffres, - et _, si bien que deux
tenants ne partagent jamais un préfixe). Les liens de signedUploadUrl portent un maxBytes,
que les stockages servis par l'application font respecter.
StoredFile est ce que garde un agrégat : key, size, mediaType, checksum
(sha256:<hex>), jamais le fournisseur. FileScanner est le point d'accroche d'un antivirus ou
d'une vérification de contenu, appelé sur le fichier en transit avant qu'il soit accepté ;
AcceptEveryFileScanner est celui d'un projet qui n'en a pas encore. FileError porte les
refus : FILE_TOO_LARGE, UNSUPPORTED_MEDIA_TYPE, FILE_NOT_FOUND, INVALID_FILE_KEY,
FILE_REJECTED, INVALID_FILE_URL_EXPIRY.
Une écriture dans le stockage n'est pas annulée avec une transaction.
FileStaging(storage, scanner, reporter) donne l'ordre qui garde les deux cohérents, chaque
étape une seule fois :
stage(key, content, options)écrit sousstaging/<key>et analyse ; un fichier refusé est supprimé (FILE_REJECTED). Un fichier venu d'un client voyage dans sa commande sous forme deFileUpload(leReceivedFileet la zone de sa clé), mis en transit parfileUploadsMiddleware(desk), un middleware de bus placé après la permission et avant l'unité de travail, si bien qu'aucune transaction n'attend un téléversement.upload.fileest leStoredFileen transit.promoteOnCommit(key)déplace le fichier vers sa clé comme dernière étape de l'unité de travail (atCommit, unCommitStepfait d'applyet d'undo) : une promotion qui échoue annule la commande, et une transaction annulée après elle renvoie le fichier dansstaging/. Une ligne validée ne pointe jamais dansstaging/.deleteAfterCommit(key)supprime, une fois la validation faite, un fichier que l'agrégat ne référence plus (afterCommit, au plus une fois : un échec ou un crash laisse un fichier non référencé, remonté).purge(olderThan)supprime les fichiers en transit plus anciens que l'instant, tous orphelins ; le jobPurgeStagedFilesl'exécute (la plateforme l'enregistre sousfiles.purge-staged, toutes les heures, pour les fichiers en transit depuis un jour ou plus).
Pour un gros fichier, le client téléverse directement vers le stockage :
uploadUrl(key, { expiresInSeconds, mediaType, accepted, maxBytes }) renvoie le link pour le
client et l'autorisation pending (PendingUpload : clé, plafond de taille, types de média, et
la règle text et les contentRules données avec eux) que la commande enregistre sur
l'agrégat ; il lève une erreur quand un type accepté n'a pas de règle de contenu, puisqu'aucun
fichier de ce type ne pourrait être confirmé ; confirm(pending), appelé par une commande qui relit
l'autorisation depuis l'agrégat, jamais depuis le client, vérifie ce qui est arrivé par rapport
au plafond et sur ses octets (contentMatches), l'analyse, et renvoie le StoredFile. Aucune
clé finale ne peut commencer par staging/ (assertFinalKey).
FileInspection est le passage par lequel chaque connecteur fait couler son flux : il compte,
hache et, avec une attente, retient les premiers octets jusqu'à ce qu'ils prouvent le type de
média déclaré (acceptsMediaType, contentMatches : un PDF commence par %PDF-, les documents
bureautiques sont des archives zip, le texte est de l'UTF-8 sans caractères de contrôle, SVG et
les formats binaires inconnus ne correspondent jamais).
Chaque type de média a une règle de contenu (contentRuleOf) : une signature
(SIGNED_MEDIA_TYPES), le texte (TEXT_MEDIA_TYPES), ou celle que l'attente énonce dans
contentRules pour un type pour lequel le kit n'en a pas, text ou unchecked (les octets
sont pris tels quels) ; une règle énoncée pour une famille (image/*) n'atteint jamais un type
qu'un navigateur exécute (NAMED_ONLY_MEDIA_TYPES : SVG, HTML, JavaScript), qui s'énonce par
son nom. contentRuleDefects liste, avant qu'un contenu n'arrive, les types
acceptés qu'aucun contenu ne pourrait prouver et les règles énoncées qui ne font rien :
@ddd-ts-kit/http refuse une route là-dessus, uploadUrl un lien. L'attente dit aussi le
texte qu'elle prend (TextRule) : utf-8, le défaut, ou single-byte, qui laisse aussi passer
un texte en Windows-1252 ou en ISO-8859-1 (aucun NUL, aucun caractère de contrôle, aucune marque
d'ordre d'octets UTF-16 ou UTF-32) et refuse toujours un fichier binaire. Le kit ne décode
jamais les octets : isUtf8(bytes) dit à un lecteur quel décodeur prendre.
Connecteurs : InMemoryFileStorage pour les tests (keys() liste ce qu'il contient) et
LocalFileStorage({ directory, baseUrl, secret }) pour le développement, tous deux
ServedFileStorage : leurs liens signés pointent vers l'application, qui y répond avec
signedFileRoutes de @ddd-ts-kit/http. Le connecteur de stockage objet est
@ddd-ts-kit/s3. Chacun passe fileStorageContract de @ddd-ts-kit/testing/contracts.
L'import et l'export en arrière-plan (validation ligne par ligne, un rapport d'erreurs, la
reprise) sont une conception bâtie sur ces ports et la file de jobs (voir « JobQueue »), pas
une fonctionnalité de cette version :
Import et export de fichiers.
JobScheduler
Section intitulée « JobScheduler »abstract class JobScheduler { abstract register(job: JobDefinition): void; // { name, schedule, run, ...options } abstract start(): Promise<void>; abstract stop(): Promise<void>; // attend les exécutions en cours, puis interrompt leur signal abstract runNow(name: string): Promise<JobRun>; // pour une opération ou un test abstract describe(): readonly JobDescription[]; // name, schedule, enabled, running, nextRunAt, lastRun}Ce qui exécute les jobs déclarés quand ils sont dus. Ce n'est pas le Scheduler de
@ddd-ts-kit/aspects, qui est une minuterie pour les nouvelles tentatives et les délais
d'expiration : celui-ci connaît les jobs, les planifications et les instances. Un JobRun est
une occurrence et son issue (succeeded, failed avec le code de l'erreur et jamais son
message, skipped-overlap, skipped-locked, missed). Un job qui échoue n'arrête ni le
planificateur ni les autres jobs, et runNow répond failed au lieu de rejeter : seul un nom
inconnu rejette (UnknownJobError), et un nom enregistré deux fois lève (DuplicateJobError). Une exécution réussie d'un job par tenant
porte tenants, le nombre de tenants pour lesquels il a tourné : 0 veut dire que l'annuaire des
tenants était vide et que le job n'a jamais été appelé.
Une exécution se déroule dans ExecutionScope, dans le contexte que construit
executionContextOfJob(name, { correlationId, scheduledAt, deadline?, tenantId? }) : origine
schedule, systemActor(name), une corrélation propre, et scheduledAt, l'instant où
l'exécution était due, que ExecutionContext porte pour cette origine. Un job est global par
défaut et ne s'exécute dans aucun tenant ; tenancy: 'per-tenant' fait que le planificateur
l'exécute une fois par tenant d'un TenantDirectory, chaque exécution dans ce tenant.
parseJobSchedule(schedule) valide une planification et renvoie la forme à partir de laquelle
les occurrences sont calculées (InvalidJobScheduleError, code INVALID_JOB_SCHEDULE, sinon) ;
describeJobSchedule(schedule) en est le texte ; jobPolicy(options) valide les options et
complète les valeurs par défaut. Le noyau ne contient aucun planificateur : celui en processus, le
calcul des occurrences et le planificateur manuel pour les tests sont dans
@ddd-ts-kit/scheduling, et le contrat du port est jobSchedulerContract de
@ddd-ts-kit/testing/contracts.
JobQueue
Section intitulée « JobQueue »abstract class JobQueue { abstract enqueue<P>(job: BackgroundJobType<P>, payload: P, options?: EnqueueOptions): Promise<EnqueuedJob>; abstract cancel(id: string): Promise<boolean>; abstract find(id: string): Promise<QueuedJob | undefined>; // statut, tentatives, progression, code de la dernière erreur}Là où un cas d'usage confie du travail à un worker. Les EnqueueOptions sont delay ou
runAt, une idempotencyKey (un job de même nom et de même clé, mis en file pour le même
tenant et encore conservé, est renvoyé, duplicate: true) et un subject (l'id de ce sur quoi
travaille le job, que find renvoie à côté du tenant : une requête vérifie que le job
appartient à l'élément sur lequel on l'a interrogée). QueuedJobStatus est le vocabulaire fermé
des statuts (waiting, running, succeeded, cancelled, dead), à publier dans un contrat.
Un travail fait pour un tenant ne trouve et n'annule que les jobs de ce tenant (une
élévation, ceux des tenants qu'elle nomme). Appelé dans une unité de travail, un job est
ajouté ou annulé avec le changement métier : les stores des packages ORM écrivent avec la
transaction, un store qui ne le peut pas (Redis, la mémoire) attend la validation par
whenCommitted(write, failed?), l'utilitaire que tout adaptateur de ce genre utilise. Une
exécution se déroule dans ExecutionScope, dans le contexte que construit
executionContextOfBackgroundJob({ jobId, enqueuedBy, deadline? }) : origine queue, la
corrélation, l'acteur et le tenant du travail qui l'a mis en file (EnqueuedBy), le job
comme cause. backgroundJobPolicy(options) complète les valeurs par défaut et
retryDelayMs(policy, attempt) est le délai entre tentatives. La file, son worker et ses
stores sont dans @ddd-ts-kit/scheduling et les packages ORM ; pourquoi et comment :
Jobs en arrière-plan.
ProcessRunner et ProcessStore
Section intitulée « ProcessRunner et ProcessStore »abstract class ProcessRunner { abstract run<State>(process: ProcessType<State>, id: string, step: (current: State | undefined) => ProcessDecision<State> | undefined): Promise<void>; abstract timeout<State>(process: ProcessType<State>, due: ProcessTimeoutDue & { jobId: string }, step: (current: State) => ProcessDecision<State> | undefined): Promise<void>;}
abstract class ProcessStore { abstract load(name: string, id: string): Promise<StoredProcess | undefined>; abstract save(process: StoredProcess): Promise<void>; // ConcurrencyError sauf si version vaut celle stockée plus 1}Les gestionnaires de processus : une classe de application/processes/ (ProcessManager<State>)
avec un processName statique, un timeoutJob statique facultatif et une garde statique
isState ; ses étapes renvoient une ProcessDecision (state, commands, timeouts sous la
forme { name, at }, cancel, ended). Un état que la garde ne reconnaît pas lève
UnreadableProcessStateError. InMemoryProcessStore garde les instances en JSON, pour les tests
et un processus unique. L'exécuteur est StoredProcessRunner de @ddd-ts-kit/scheduling ;
pourquoi et comment :
Sagas et gestionnaires de processus.
RateLimiter
Section intitulée « RateLimiter »import { DomainRefusal, type RateLimiter } from '@ddd-ts-kit/kernel';
export const IdentityCodes = { TooManyResetAttempts: 'TOO_MANY_RESET_ATTEMPTS' } as const;
export class TooManyResetAttempts extends DomainRefusal { readonly code = IdentityCodes.TooManyResetAttempts;
static withRetryAfter(retryAfterMs: number) { return TooManyResetAttempts.refusal('Too many password resets: try again later.', { retryAfterMs }).exposing( 'retryAfterMs', ); }}
export async function allowReset(limiter: RateLimiter, accountId: string): Promise<void> { const decision = await limiter.consume(`password-reset:${accountId}`, { limit: 3, windowMs: 3_600_000 });
if (!decision.allowed) { throw TooManyResetAttempts.withRetryAfter(decision.retryAfterMs); }}Une fenêtre glissante : à tout instant, au plus limit appels autorisés dans les windowMs qui
le précèdent. Une RateLimitDecision vaut { allowed, remaining, retryAfterMs } ; un appel
refusé n'est pas compté. La clé est ce qu'on limite : un client, un tenant, une route et une
adresse ensemble. Dans un projet multitenant, tenantKey(scope, 'password-reset', accountId) la
confine au tenant du travail en cours (tenant:<id>:password-reset:<account>) et refuse un
travail qui n'en nomme aucun.
InMemoryRateLimiter(clock) compte à l'intérieur d'un processus ; l'adaptateur partagé par
plusieurs instances est dans @ddd-ts-kit/redis. rateLimitDecisionOf(counted, limit)
transforme ce qu'un adaptateur a compté en décision.
Multitenance
Section intitulée « Multitenance »Le tenant du travail est ExecutionContext.tenantId, posé à la frontière et lu par
l'infrastructure seulement, comme le reste du contexte. Le noyau contient ce que toutes les
stratégies partagent ; l'isolation elle-même (colonne de tenant, sécurité au niveau des lignes,
schéma ou base de données par tenant) est dans les packages de persistance, et le tableau
complet dans Multitenance.
| Concept | Ce qu'il fait |
|---|---|
isTenantId(value), assertTenantId(id), InvalidTenantIdError |
la seule grammaire d'un id de tenant (lettres, chiffres, _, -, 63 au plus) : executionContext, executionContextOfEvent, acrossTenants, InMemoryTenantDirectory, tenantScopeOf, tenantReachOf et les réglages de sécurité au niveau des lignes refusent tout autre, pour qu'aucun id de tenant ne puisse être lu comme un joker, une liste ou un séparateur de clé |
tenantScopeOf(scope) |
le seul tenant que nomme une écriture ; NoCurrentTenantError pour un travail qui n'en nomme aucun |
assertNamesTenant(context, access) |
ce qu'un store de données de tenant vérifie avant de lire ou d'écrire : le travail nomme un tenant, ou lit sous une élévation ; NoCurrentTenantError sinon, hors de toute portée d'exécution compris |
tenantReachOf(scope) |
ce qu'une lecture peut voir : { kind: 'tenant', tenantId }, ou { kind: 'elevated', tenants } sous une élévation |
tenantsOf(actor), isTenantMember(actor, tenantId) |
les tenants auxquels appartient un acteur : son tenantId et son attribut tenants |
acrossTenants({ scope, trail, clock, ids }, { reason, tenants }, work) |
le personnel de la plateforme qui lit par-dessus les tenants : refusé sans raison ou sans tenant, enregistré dans l'AuditTrail (action tenancy:elevate) avant que le travail s'exécute ; les écritures nomment toujours un seul tenant |
tenantKey(scope, ...segments), tenantCacheKey(scope, ...segments) |
les clés de limites de débit, de verrous et de caches confinées au tenant : tenant:<id>:<segments>, chaque segment encodé en pourcent, pour que deux listes de segments ne donnent jamais une même clé |
TenantDirectory, InMemoryTenantDirectory |
les tenants qui existent, pour les jobs par tenant, le provisionnement et les migrations |
TENANT_SETTINGS, tenantSettingValues(context), TENANT_ISOLATION_POLICIES, tenantPolicyExpressions(column) |
ce que partage la sécurité au niveau des lignes des packages de persistance : les trois réglages d'une transaction (ddd_ts_kit.tenant_id, et pour une élévation seulement ddd_ts_kit.reach et ddd_ts_kit.every_tenant), leurs valeurs pour le travail en cours, les noms des quatre politiques (une par commande) et leurs expressions read et write |
Une élévation n'est jamais impliquée par un rôle : la plateforme décide de la permission
d'élever (un cas d'usage ou une garde), puis appelle acrossTenants. Un journal qui ne parvient
pas à l'enregistrer la refuse.
Page et PageRequest
Section intitulée « Page et PageRequest »Une seule forme pour chaque recherche, en deux variantes :
import { cursorPage, offsetPage } from '@ddd-ts-kit/kernel';
declare const cursor: string; // le nextCursor de la page précédente
offsetPage({ offset: 40, limit: 20, sort: [{ field: 'placedAt', direction: 'desc' }] });cursorPage({ cursor, limit: 50 });// les deux construisent une PageRequest ; la recherche renvoie une Page<T> : { items, total?, nextCursor? }
Un curseur est opaque pour le client et lisible pour le lecteur : encodeCursor(position) écrit
les valeurs de tri du dernier élément d'une page, decodeCursor(cursor) les relit et refuse ce
qu'il n'a pas écrit. Il n'est pas signé : le port de lecture vérifie les types de ce qu'il décode
avant qu'ils atteignent une instruction. Un curseur a besoin d'un ordre total : ajoutez une
clé unique (la clé primaire) au tri, dans la même direction, mettez-la dans la position, et
comparez le tuple entier. Sinon, des lignes égales sur le champ de tri n'ont pas d'ordre défini,
et une page pourrait en répéter ou en sauter une. Les packages d'adaptateurs montrent la
requête pour chaque ORM.
offsetPage et cursorPage valident et lèvent InvalidPageRequestError
(INVALID_PAGE_REQUEST) au-delà de PageLimits (taille par défaut 20, maximum 100).
pageOf(items, more) et mapPage(page, map) construisent et traduisent la réponse. Les champs
triables sont un paramètre de type, PageRequest<'placedAt' | 'total'> : ils diffèrent pour
chaque port de lecture, ce qu'une augmentation globale ne pourrait pas exprimer.
AuditStamp et TenantScoped
Section intitulée « AuditStamp et TenantScoped »AuditStamp (createdAt, createdBy, updatedAt, updatedBy) et TenantScoped (tenantId)
sont des colonnes d'un enregistrement stocké, pas des propriétés d'un agrégat.
stampCreation(scope, clock), stampUpdate(scope, clock) et tenantScopeOf(scope) les
remplissent dans un adaptateur de repository :
// insertion : qui crée est aussi qui a modifié en dernierconst row = { ...toRow(order), ...tenantScopeOf(scope), ...stampCreation(scope, clock) };// mise à jour : les deux colonnes à poser, la création n'est pas touchée ; le tenant fait partie de chaque conditionawait update({ ...toRow(order), ...stampUpdate(scope, clock) }, { id: order.id, ...tenantScopeOf(scope) });stampUpdate(stamp, scope, clock) est la forme pour un adaptateur qui détient le tampon stocké
(un store de documents qui réécrit l'enregistrement entier) : il le renvoie entier, création
intacte. tenantScopeOf lève NoCurrentTenantError pour un travail qui ne nomme aucun tenant,
si bien qu'une instruction ne peut jamais s'exécuter sans restriction par oubli. Chaque package
d'adaptateur nomme les colonnes de la même manière : created_at, created_by, updated_at,
updated_by, tenant_id.
AuditTrail, AuditReader et AuditEntry
Section intitulée « AuditTrail, AuditReader et AuditEntry »abstract class AuditTrail { abstract record(record: AuditRecord): Promise<void>;}
abstract class AuditReader { abstract search(filter: AuditFilter, page: PageRequest<AuditSortField>): Promise<Page<AuditEntry>>;}Les deux ports d'un journal d'audit et la forme d'une entrée (AuditEntry, AuditRecord pour ce
que remet une source, AuditFilter, et les types qu'ils nomment), pour que le code qui enregistre
ou liste ne dépende que du noyau. AuditTrail est en ajout seul et est alimenté par
l'infrastructure et le code transverse (un middleware de bus, le hook d'autorisation, un
abonnement à des événements), jamais par un cas d'usage ou un agrégat. AuditReader est ce dont
dépend un gestionnaire de requête pour lister les entrées. Un projet ajoute des champs à chaque
entrée par AuditEntryExtensions.
Le noyau ne contient aucune implémentation : la chaîne de hachage, les sources, le masquage, la
vérification et les stores, celui en mémoire compris, sont dans @ddd-ts-kit/audit.
Hors du noyau
Section intitulée « Hors du noyau »Les feature flags n'ont pas de port ici. Leur modèle d'évaluation (booléen ou variante, ciblage, pourcentage, qui est le sujet) diffère selon chaque fournisseur, et OpenFeature est déjà le contrat neutre vis-à-vis des fournisseurs : un projet qui a besoin de flags déclare un port dans le contexte qui les lit, nommé d'après la décision qu'il prend.
Critères
Section intitulée « Critères »Une lecture d'un modèle de lecture, décrite une fois pour toutes les recherches : des filtres, un tri, une page. Des critères connaissent des noms de champs et rien d'un store. Ce n'est pas une spécification : une spécification est un prédicat métier sur un agrégat et vit dans le domaine ; des critères décrivent une lecture.
import { ReadModelStore, defineCriteria } from '@ddd-ts-kit/kernel';
export interface AppointmentRow {  readonly id: string;  readonly status: 'booked' | 'confirmed' | 'cancelled';  readonly startsAt: Date;  readonly practitionerId: string;  readonly cancelledAt: Date | null;  readonly tenantId: string;}
export const appointmentCriteria = defineCriteria<AppointmentRow>({  fields: {    id: { type: 'string' },    status: { type: 'string', filter: ['eq', 'in'], sortable: true },    startsAt: { type: 'instant', filter: ['gte', 'lt', 'between'], sortable: true },    practitionerId: { type: 'string', filter: ['eq'] },    cancelledAt: { type: 'instant', filter: ['isNull'], nullable: true },    tenantId: { type: 'string' },  },  defaultSort: [{ field: 'startsAt', direction: 'asc' }],  tieBreaker: 'id',  limits: { maxPageSize: 50 },});
export abstract class AppointmentList extends ReadModelStore<AppointmentRow> {}const criteria = Criteria.of<AppointmentRow>() .where('status', 'in', ['booked', 'confirmed']) .where('startsAt', 'gte', query.from) .or((any) => any.where('practitionerId', 'eq', query.practitionerId).where('cancelledAt', 'isNull', false)) .orderBy('startsAt', 'asc') .page(query.page);
const scope = await this.access.scope(query.actor, permissions['appointment.read'], 'appointment');
return this.appointments.search(scoped(criteria, scope, { ids: 'id', filter: { tenantId: 'tenantId' } }));Du gestionnaire jusqu'au store, des critères sont vérifiés deux fois, et le périmètre de l'acteur voyage avec eux :
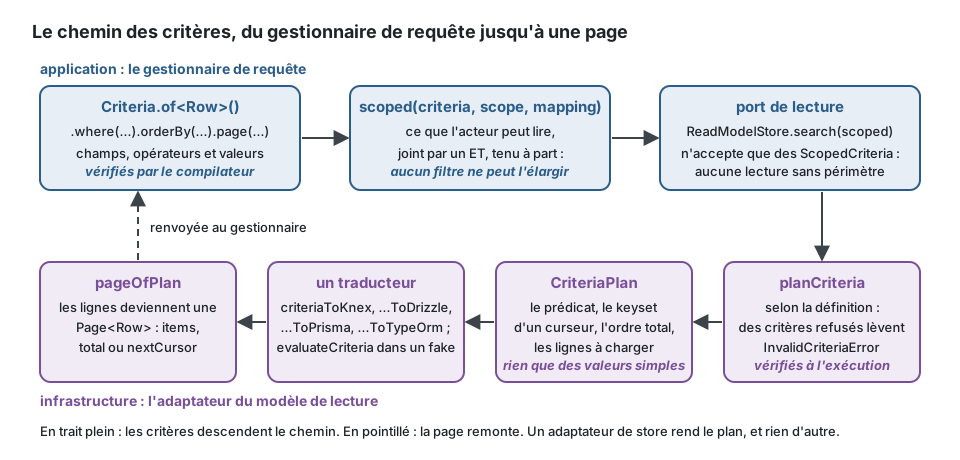
Vérifiés par le compilateur. where prend un champ de la ligne, un opérateur qui s'applique
à ce que contient le champ, et une valeur de son type : where('seats', 'contains', '2'), un tri
sur un booléen, isNull sur un champ qui n'est jamais nul, une valeur hors d'une union de
littéraux et un champ hydraté au moment de la requête sont tous refusés. Il en va de même pour
une déclaration : le type de chaque champ, ses opérateurs et nullable sont vérifiés par rapport
à la ligne.
Vérifiés par le port de lecture. validateCriteria(definition, criteria) renvoie les
violations, ne lève jamais, et ne cite jamais une valeur. planCriteria(definition, criteria)
valide d'abord et lève InvalidCriteriaError (INVALID_CRITERIA) : des critères que leur
définition refuse n'atteignent jamais une instruction.
| Code | Chemin | Refusé |
|---|---|---|
unknown_field |
filter.<field> |
un champ que la définition ne déclare pas |
operator_not_allowed |
filter.<field> |
un opérateur que le champ ne déclare pas |
invalid_value |
filter.<field> |
une valeur qui n'est pas du type du champ, une liste vide, un between sans deux valeurs, un texte à chercher vide |
in_list_too_long |
filter.<field> |
une liste au-delà de maxInList (100) |
too_deep |
filter |
des groupes imbriqués plus profondément que maxDepth (1 : or(a, b) ; 2 : or(and(a, b), c)) |
empty_group |
filter |
un groupe sans filtre |
too_many_filters |
filter |
plus de conditions que maxFilters (20) |
unsortable_field |
sort |
un tri sur un champ non déclaré sortable (le départage l'est toujours) |
page_too_large |
page.limit |
une page au-delà de maxPageSize (100 ; la taille par défaut est 20) |
invalid_cursor |
page.cursor |
un curseur qui n'est pas le nextCursor d'une page du même tri |
Ce que signifient des critères
Section intitulée « Ce que signifient des critères »La référence est evaluateCriteria(definition, rows, criteria), qui exécute des critères sur des
lignes tenues en mémoire et avec quoi répond un fake d'un port de lecture. Chaque traducteur de
store est tenu au même tableau par criteriaContract de @ddd-ts-kit/testing/contracts.
| Règle | Signification |
|---|---|
| Types | string ; number ; boolean ; instant, une Date comparée par son instant, à la milliseconde ; decimal, une chaîne de chiffres (-12.50) comparée comme un nombre sans l'arrondi d'un flottant |
eq, ne, in |
par valeur : deux instants identiques sont égaux quel que soit le fuseau dans lequel ils ont été écrits, 10.5 vaut 10.50 |
gt, gte, lt, lte |
nombres, décimaux et instants par valeur ; chaînes par point de code Unicode, si bien que les majuscules viennent avant les minuscules ('B' < 'a') ; pas sur un booléen |
between |
les deux bornes incluses |
contains, startsWith |
sur une chaîne seulement, sensibles à la casse, le texte pris littéralement : %, _ et \ sont des caractères ; un texte vide est refusé |
containsIgnoringCase, startsWithIgnoringCase |
les mêmes recherches, chaque lettre des deux côtés mise en minuscule, et rien d'autre : un accent est gardé (e ne trouve pas é), aucune lettre n'est réécrite (ss ne trouve pas ß). Tous les stockages répondent la même chose pour les lettres ASCII et pour une lettre qui a une seule majuscule et une seule minuscule, d'un caractère chacune (É et é, Ñ et ñ, grec et cyrillique compris) ; voir plus bas pour les autres |
isNull |
true garde les lignes sans valeur, false celles qui en ont une ; seulement sur un champ déclaré nullable |
| Un nul | ne satisfait jamais une comparaison, ne compris ; seul isNull le voit |
| Conditions | jointes par ET |
and, or, not |
not vaut pour les lignes qui ne satisfont pas tous ses filtres, nuls compris : la logique a deux valeurs, si bien que not(room eq 'B') garde les lignes sans salle, là où SQL seul les écarterait |
| Tri | les appels à orderBy, puis le tri de la demande de page pour les champs pas encore ordonnés ; sans aucun, le defaultSort de la définition |
| Ordre total | le départage de la définition termine chaque tri, dans la direction du dernier champ, sauf si le tri le nomme |
| Nul dans un tri | la plus grande valeur : en dernier en ordre croissant, en premier en ordre décroissant (le défaut de PostgreSQL) |
false et true |
false d'abord en ordre croissant |
| Page par décalage | la tranche et total, le nombre de lignes filtrées |
| Page par curseur | pas de total ; nextCursor quand une autre page suit. Le curseur contient les valeurs de tri de la dernière ligne, est vérifié par rapport aux types déclarés à son retour, et appartient à un seul tri |
| Pas de page | la première page de la taille par défaut |
Une recherche qui ignore la casse. foldCase(text) est la règle en mémoire : le
toLowerCase() de JavaScript des deux côtés. Les packages d'ORM écrivent un ILIKE (le mode
insensitive de Prisma), que PostgreSQL replie avec la locale de la base : une base créée avec
la locale C ne replie que les lettres ASCII. OpenSearch reçoit une expression régulière qui
nomme les deux formes de chaque lettre. Hors des lettres que le tableau garantit, chaque
stockage suit sa propre table : le I avec et sans point du turc, ß et ẞ, le sigma final,
les ligatures et le signe Kelvin peuvent être trouvés par un stockage et pas par un autre. Un
index b-tree ne sert ni LIKE '%x%' ni aucun ILIKE : sur PostgreSQL, un index GIN de
l'extension pg_trgm sur la colonne (gin_trgm_ops) sert les deux, pour un texte de trois
caractères ou plus. Le kit ne le crée pas : il va dans une migration du projet.
Deux conséquences découlent de l'endroit où un store garde ses données, et sont écrites dans le
README de chaque adaptateur. Les chaînes sont ordonnées par la collation de leur colonne : la
référence est la collation "C" de PostgreSQL, si bien qu'une colonne de texte triée ou comparée
par intervalle est déclarée COLLATE "C". Un décimal se relit tel que sa colonne le formate
(10.5, ou 10.5000 pour une échelle fixe) : comparez les décimaux comme des nombres.
Le périmètre de l'acteur
Section intitulée « Le périmètre de l'acteur »scoped(criteria, accessScope, mapping) renvoie des ScopedCriteria, ce que demande un port de
lecture : une lecture ne peut l'atteindre sans périmètre. Le périmètre est tenu à part des filtres
et leur est joint par un ET, si bien que rien de ce qu'écrit un appelant, un or ou un not
compris, n'élargit ce que l'acteur peut lire ; refine change les critères et garde la
restriction.
| Périmètre | Devient |
|---|---|
{ kind: 'all' } |
rien : les critères tels quels |
{ kind: 'none' }, ou ids sans aucun id |
une page vide, sans requête |
{ kind: 'ids', ids } |
in sur le champ que nomme mapping.ids ; la liste est celle de l'autorisateur et n'est pas bornée par maxInList |
{ kind: 'filter', filter } |
un eq par entrée, sur le champ que mapping.filter nomme pour sa clé |
Un périmètre que la correspondance ne sait pas exprimer lève UnmappedReadScopeError au lieu de
lire sans la restriction, tout comme un champ mis en correspondance que la définition ne déclare
pas. Les champs d'un périmètre n'ont besoin d'aucun opérateur dans la définition : c'est le port
de lecture qui les a choisis, pas l'appelant. Le périmètre est la forme AccessScope de
@ddd-ts-kit/auth, nommée ReadScope ici pour que le noyau ne dépende d'aucun modèle
d'autorisation.
Ce que cela signifie sur quatre lignes, exécutées en mémoire avec la sémantique de référence :
import { Criteria, defineCriteria, evaluateCriteria, scoped } from '@ddd-ts-kit/kernel';
interface BookingRow {  readonly id: string;  readonly room: string | null;  readonly tenantId: string;}
const bookings = defineCriteria<BookingRow>({  fields: {    id: { type: 'string' },    room: { type: 'string', filter: ['eq'], nullable: true },    tenantId: { type: 'string' },  },  defaultSort: [{ field: 'id', direction: 'asc' }],  tieBreaker: 'id',});
const rows: BookingRow[] = [  { id: 'a-1', room: 'A', tenantId: 'acme' },  { id: 'a-2', room: 'B', tenantId: 'acme' },  { id: 'a-3', room: null, tenantId: 'acme' },  { id: 'g-1', room: 'A', tenantId: 'globex' },];
// `not` garde la ligne sans salle, là où SQL seul l'écarteraitevaluateCriteria(bookings, rows, Criteria.of<BookingRow>().not((all) => all.where('room', 'eq', 'B')));// items : a-1, a-3, g-1
// un `or` qu'écrit l'appelant n'élargit jamais le périmètre : le périmètre lui est joint par un ETconst anyRoom = Criteria.of<BookingRow>().or((any) => any.where('room', 'eq', 'A').where('room', 'eq', 'B'));const acmeOnly = { kind: 'filter', filter: { tenantId: 'acme' } } as const;evaluateCriteria(bookings, rows, scoped(anyRoom, acmeOnly, { filter: { tenantId: 'tenantId' } }));// items : a-1, a-2 ; g-1 appartient à un autre tenant
// l'appelant ne peut pas filtrer lui-même sur tenantId : le champ ne déclare aucun opérateurevaluateCriteria(bookings, rows, Criteria.of<BookingRow>().where('tenantId', 'eq', 'globex'));// lève InvalidCriteriaError : filter.tenantId (operator_not_allowed)
Côté store
Section intitulée « Côté store »planCriteria renvoie un CriteriaPlan, des données simples qu'un traducteur rend et rien
d'autre : le prédicat des filtres et du périmètre, le prédicat du keyset pour une page par
curseur, l'ordre total, les lignes à charger. Les négations sont déjà poussées jusqu'aux
comparaisons, si bien qu'un traducteur rend des and, des or et des tests ; le keyset est un
prédicat comme un autre, si bien que la pagination par curseur s'écrit une seule fois.
pageOfPlan(plan, rows, total?) transforme les lignes qu'une requête a renvoyées en Page. Les
packages d'adaptateurs contiennent les traducteurs : criteriaToKnex, criteriaToDrizzle,
criteriaToPrisma, criteriaToTypeOrm.
Limites. Pas de jointure : on filtre sur un champ d'un autre contexte une fois qu'une
projection l'a copié. Pas d'agrégation, pas de recherche plein texte. Un long périmètre ids est
une longue liste IN : au-delà de quelques milliers d'identifiants, projetez dans le modèle de
lecture le droit que représente le périmètre.
Hydratation
Section intitulée « Hydratation »Compléter les lignes d'une lecture avec des données d'un autre contexte délimité, au moment de la requête, par un port gateway : pour les vues de détail et les petites pages dont les données étrangères doivent être fraîches. Une liste qui filtre ou trie selon le champ étranger a besoin d'une projection à la place.
const page = await this.appointments.search(criteria);
return hydrate(page)  .with('practitioner', (row) => row.practitionerId, this.practitioners.byIds)  .with('location', (row) => row.locationId, this.locations.byIds)  .orElse('practitioner', unknownPractitioner, { onFailure: 'fallback', timeoutMs: 300 });
lookup est (ids: readonly string[]) => Promise<ReadonlyMap<string, T>>, une méthode du port
gateway ; l'aspect cached de @ddd-ts-kit/aspects entoure la gateway comme n'importe
quelle autre.
| Règle | |
|---|---|
| Appels | un par relation pour toute la page, avec chaque clé une seule fois ; aucun quand aucune ligne n'a de clé. Jamais un par ligne |
| Concurrence | les relations sont recherchées en même temps |
| Résultat | la ligne et les propriétés hydratées, typées ; une Page reste une Page avec le même total et le même nextCursor, une liste de lignes devient une page de celles-ci ; warnings est ajouté |
| Une ligne sans clé, ou inconnue de l'autre côté | laissée sans la propriété, qui est typée facultative |
orElse(name, fallback) |
chaque ligne a la propriété, typée obligatoire : la valeur de repli là où rien n'a été trouvé |
| Une recherche qui rejette | fait échouer toute l'hydratation (politique fail, le défaut), valeur de repli ou non |
orElse(name, fallback, { onFailure: 'fallback' }) |
les lignes prennent la valeur de repli et warnings contient { relation, code: 'lookup_failed' } : jamais un succès silencieux, jamais le message d'erreur |
timeoutMs |
la recherche est abandonnée après ce délai (HydrationTimeoutError, code d'avertissement lookup_timed_out), puis suit onFailure |
Une propriété hydratée ne peut pas être nommée par une définition de critères : FieldOf<Row>
garde les champs qui contiennent un scalaire, et le compilateur refuse le reste. Les traces
montrent un span gateway <Port>.byIds par relation, comme pour tout appel à une gateway :
l'hydratation n'ouvre elle-même aucun span.
Projections
Section intitulée « Projections »Un projecteur tient un modèle de lecture à jour à partir d'événements : les événements d'intégration des contextes amont, les événements du domaine du sien. Il écrit son modèle de lecture par un port et ne fait rien d'autre : il n'envoie aucune commande et ne lit aucun autre contexte.
import { stampOf, type IntegrationEvent } from '@ddd-ts-kit/kernel';import { On, Projection } from '@ddd-ts-kit/kernel/declarations';
@Projection('scheduling.appointment-list')export class AppointmentListProjection {  constructor(private readonly appointments: AppointmentList) {}
  @On(AppointmentBooked)  booked(event: AppointmentBooked) {    return this.appointments.upsertIfNewer(event.aggregateId, stampOf(event), () => rowOf(event));  }
  @On(PaymentCaptured)  paid(event: IntegrationEvent<PaymentCapturedPayload>) {    return this.appointments.updateIfNewer(event.payload.appointmentId, stampOf(event), (row) => ({      ...row,      paid: true,    }));  }
  @On(AppointmentCancelled)  cancelled(event: AppointmentCancelled) {    return this.appointments.delete(event.aggregateId, stampOf(event));  }}
@Projection('<context>.<name>') est une déclaration comme les autres : les deux modes de
décorateurs, ses dépendances dites par son constructeur, une classe par fichier, dans
application/projections/, dans un fichier *.projection.ts. @On(definition) sur une méthode
dit « cette méthode applique cet événement d'intégration » ; @On(EventClass) le dit pour un
événement du domaine du contexte propre de la projection, sous le nom que sa classe déclare une
fois, static readonly eventName. Une méthode qui prend un autre événement est refusée par le
compilateur, une projection sans aucun @On et un @On sur une classe sans @Projection
lèvent au chargement du fichier. Une méthode renvoie ce qu'a renvoyé son store, ce qui permet à l'application de compter ce qui a été appliqué et ce qui était périmé.
Un rôle de la CLI. application/projections/ est un répertoire de l'arborescence canonique,
ddd-ts-kit generate projection <context> <Name> <event-type> écrit un projecteur avec sa spec,
le barrel généré <context>.declarations.ts l'exporte et enregistre ce que prend son
constructeur, et ddd-ts-kit describe et la référence de CONTEXT.md le listent avec les
événements qu'il applique.
Idempotentes et ordonnées par construction
Section intitulée « Idempotentes et ordonnées par construction »ReadModelStore<Row> est le port d'un modèle de lecture : get, upsertIfNewer, updateIfNewer, delete et
search(scopedCriteria). Chaque ligne porte le tampon de l'événement qui l'a modifiée en dernier,
et une écriture n'a lieu que si son événement est plus récent :
| Règle | |
|---|---|
| Tampon | stampOf(event) : l'id et l'instant d'un événement d'intégration ; le nom, l'agrégat et l'instant d'un événement du domaine ; plus stampOf(event, version) quand l'événement porte une version par clé |
| Plus récent | une version plus grande quand les deux tampons en portent une ; sinon un instant plus tardif ; au même instant, le plus grand id d'événement. Un même événement n'est jamais plus récent que lui-même. L'ordre est total parmi des tampons qui portent tous une version, et parmi des tampons qui n'en portent aucune ; entre un de chaque les instants décident, ce qui n'est pas un ordre, si bien qu'une clé devrait n'en voir qu'une sorte (une seule sorte de tampon par clé) |
upsertIfNewer(key, stamp, next) |
pour un événement qui dit toute la ligne, ou peut la créer : écrit next(current), current valant undefined quand la clé ne tient aucune ligne ; stale quand la ligne contient cet événement ou un plus tardif ; ignored quand next renvoie undefined, ce qui est un filtre (l'événement ne concerne pas ce modèle de lecture) et jamais la façon d'attendre une ligne |
updateIfNewer(key, stamp, change) |
pour un événement qui change une partie d'une ligne qu'un autre événement a créée : écrit change(current) ; stale quand la ligne, ou la trace de sa suppression, contient cet événement ou un plus tardif ; missing quand la clé ne tient aucune ligne, la trace d'une suppression plus ancienne que l'événement, ou une ligne d'un autre locataire : rien n'est écrit, le store ne lève jamais pour cela, et la projection décide. Juste seulement quand les événements de la clé sont appliqués dans l'ordre (quelle écriture pour quel événement) |
delete(key, stamp) |
la ligne disparaît pour get et search, et une trace reste, sa clé et son tampon sans aucune de ses données : un événement plus ancien livré en retard ne la ramène pas, un plus tardif oui. Une clé que le modèle de lecture ne tient pas prend la même trace et répond traced, puisqu'aucune ligne n'a été retirée (comme une suppression par-dessus une trace antérieure), si bien que la création que cette suppression suit est stale quand elle est livrée après elle. Sur un stockage SQL, chaque colonne de la ligne accepte NULL, sinon le registre refuse la table par ReadModelTableNotReadyError (ce que laisse une ligne supprimée) |
| Concurrence | une écriture est conditionnée au tampon entier qu'elle a lu (sameStamp : l'id de l'événement, l'instant et la version, dans chaque store) et est relue quand une autre est arrivée d'abord ; cinq tentatives, puis ConcurrencyError et la nouvelle livraison de l'événement |
| Transaction | le store écrit sur l'exécuteur de l'unité de travail, si bien que la ligne et la marque d'événement traité sont validées ou annulées ensemble |
Ainsi une nouvelle livraison, un doublon et deux événements d'une même clé livrés dans le
désordre aboutissent tous à la même ligne. Ce que cela ne donne pas : un événement plus
ancien écarté comme périmé n'est pas appliqué plus tard, si bien qu'un événement devrait porter
l'état des champs qu'il pose, ou arriver dans l'ordre par clé (l'outbox ordonne par clé) ; un
changement pour lequel updateIfNewer a répondu missing ou stale n'est pas appliqué plus tard
non plus ; avec des instants et sans
version, l'ordre de deux événements d'une même clé est l'ordre des horloges qui les ont
tamponnés ; une version est comparée à la version que contient la ligne, alors n'en passez une
que si chaque événement d'une ligne vient du même flux, et alors sur chacun d'eux. Une écriture vaut une ligne : un événement
qui concerne de nombreuses lignes les liste avec des critères et écrit chacune.
TableReadModelStore est l'unique implémentation du port, sur une ReadModelTable que donne un
adaptateur (trois instructions et la requête d'un plan) : InMemoryReadModelStore ici pour les
fakes, KnexReadModelStore, DrizzleReadModelStore, PrismaReadModelStore et
TypeOrmReadModelStore dans les packages d'adaptateurs, tous tenus à readModelStoreContract.
Sur PostgreSQL, la table d'un tel store ne contient la trace d'une ligne supprimée que si chaque
colonne que le store associe comme champ de sa ligne accepte NULL. PostgresTraceColumns le lit
dans la base, pour ces colonnes et aucune autre : celles qui refusent NULL, celles que rien ne peut
ouvrir (une partie de la clé primaire, une colonne d'identité ou générée, une colonne d'un domaine
qui refuse NULL, une colonne qui n'existe pas), si la table existe, ce que sa contrainte de
vérification <table>_live_rows_whole garde entier, quelles autres contraintes de vérification
nomment une colonne de la ligne, et si c'est une vue. C'est le refus d'un store avant sa première
trace, et tableState() d'un TableReadModelStore rend la même lecture sous la forme d'un
ReadModelTableState. ReadModelTables le demande aux stores qu'une application liste, chaque
entrée un nom et ce qui construit le store comme l'application le lie : hosting(contexts) garde
les entrées des contextes qu'une application héberge et contexts nomme ceux que tient la liste ;
states() et notReady() listent, require() refuse avec ReadModelTablesNotReadyError, atStart(logger) est ce
qu'appelle une application à son démarrage (atStart(logger, 'reported') journalise les tables en
une erreur et laisse le démarrage se poursuivre), et report() est ce qu'affiche une commande,
avec un outcome qui distingue une table qui n'est pas prête d'une base qui n'a pas pu être lue.
Chaque entrée est essayée : celle dont le store ne peut pas être construit ou dont la base refuse
de lire la table est dite sous son nom, dans unread de l'erreur, avec sa cause en quelques mots
(le message du pilote, jamais l'instruction), et les autres sont lues quand même. Une base
injoignable n'est pas un refus de démarrage : atStart journalise un seul avertissement avec la
cause courte et poursuit, report() rend unread. Le verdict est celui du store par construction, une table que personne ne liste n'est jamais
lue, et un store sans table (mémoire, OpenSearch) n'a rien à dire. Ce que la vérification ne peut
pas trancher est un avertissement : une contrainte non validée, une contrainte de ce nom qui n'est
pas écrite comme le kit l'écrit (la forme est lue exactement, telle que PostgreSQL l'affiche), une
autre vérification sur une colonne de la ligne sauf si elle est écrite pour les seules lignes
vivantes (deleted or ..), une vue, un store que l'application nomme comme
non listé. Un refus nomme la table, ce qui l'empêche de contenir une trace et la migration à
écrire, dans steps (statements tient les deux dans l'ordre) : le changement de définition, une
instruction qui ne touche que les colonnes associées, écrit la contrainte not valid et ne
supprime jamais une contrainte qui n'est pas celle du kit ; puis la validation et le nettoyage des
lignes supprimées auparavant, qu'une grande table exécute hors de la transaction de la première
étape. Elle peut être exécutée deux fois. Le tout tenu à readModelTablesContract sur les quatre
ORM : voir
Chaque table vérifiée au démarrage, et avant un déploiement.
Reconstruction
Section intitulée « Reconstruction »Un modèle de lecture alimenté par des événements qu'aucun event store ne garde se reconstruit à partir de la source de vérité, le contrat de lecture que publie le contexte propriétaire, derrière un port gateway qui renvoie des lignes tamponnées. Un modèle de lecture d'agrégats en event sourcing se reconstruit plutôt à partir du store : Alimentée par l'event store.
await new ProjectionRebuild({ table: appointments.table, source, unitOfWork }).run();// source.export(cursor) : une page de { key, row, stamp } et son nextCursor// source.lookup(keys) : les lignes de ces clés telles qu'elles sont maintenant| Étape | Ce qui se passe |
|---|---|
| 1 | une copie vide de la table est ouverte, avec ses index et ses contraintes et les traces des lignes supprimées ; dès lors, chaque écriture de la projection enregistre sa clé avant d'écrire |
| 2 | l'export est copié, page par page, dans la copie. Les événements continuent d'être appliqués à la table, qui continue de répondre aux lectures |
| 3 | les clés enregistrées sont relues depuis la source, par tours, jusqu'à ce qu'il en reste peu |
| 4 | en une transaction : les écrivains sont retenus, les dernières clés enregistrées sont relues, la copie prend le nom de la table, l'ancienne table est supprimée |
La copie est remplie à partir de la source seule, jamais de la table qu'elle remplace, si bien
qu'une reconstruction répare les lignes que la projection avait faussées. Aucun événement n'est
perdu : un événement est livré après que sa source l'a validé, si bien que soit l'export a lu
sa ligne après, soit sa clé a été enregistrée et relue, soit il est appliqué après l'échange à
une ligne dont le tampon est plus ancien. Aucun événement n'est appliqué deux fois : un
événement que la source reflétait déjà est stale face au tampon avec lequel sa ligne est venue.
Les deux reposent sur ce que la source dit de chaque ligne : le tampon du dernier événement que
son état reflète. Avec l'id et l'instant de cet événement, ou une version par clé, la garantie
est exacte ; avec un updatedAt seul, un événement du même instant exactement est appliqué une
fois de plus sur l'état qui le contient déjà, ce qui est sans conséquence pour un événement qui
pose un état et faux pour un événement qui compte.
La fenêtre. Les lectures ne sont jamais interrompues jusqu'à l'étape 4. Les écrivains
attendent pendant l'étape 4, le temps de relire les dernières clés (au plus settledBelow, 50
par défaut, sauf si la table change plus vite que maxRounds tours ne peuvent suivre) et de
renommer deux tables. Une écriture qui avait commencé juste avant échoue et est relivrée. Une
reconstruction qui échoue supprime sa copie et laisse la table telle qu'elle était. Sur
PostgreSQL, la copie est faite avec LIKE ... INCLUDING ALL : les privilèges accordés sur la
table par son nom, les politiques de sécurité des lignes et les déclencheurs ne sont pas copiés
et sont restaurés par la migration qui suit, et les index de la copie gardent les noms que
PostgreSQL leur a dérivés.
Alimentée par l'event store
Section intitulée « Alimentée par l'event store »Une projection d'agrégats en event sourcing peut être alimentée par le store plutôt que là où
les événements du domaine sont distribués :
@Projection('scheduling.attendance-history', { feed: 'event-store' }). Le distributeur ne
l'appelle alors jamais (@ddd-ts-kit/di n'enregistre aucun gestionnaire pour elle) ; un
abonnement de rattrapage le fait, sous le nom de la projection, et la même projection reconstruit
son modèle de lecture depuis la position zéro.
const apply = applyingProjection(projection, serializer); // les méthodes @On, par nom d'événement
const subscription = new CatchUpSubscription({ name: 'scheduling.attendance-history', store, checkpoints, unitOfWork, apply });
await subscription.catchUp(); // ou poll() depuis un job : un lot, une unité de travail
await new EventStoreProjectionRebuild({ table: history.table, store, unitOfWork, applierOn: (copy) => applyingProjection(new AttendanceHistoryProjection(copy), serializer),}).run();| Pièce | Ce qu'elle fait |
|---|---|
CatchUpSubscription |
Lit le store après le point de reprise de son abonné (CheckpointStore), applique un lot et déplace le point de reprise en une unité de travail. Un échec n'applique rien du lot ; deux exécutions d'un même abonné ne le déplacent jamais toutes les deux (ConcurrencyError). Une nouvelle projection commence à zéro, si bien qu'elle rattrape tout l'historique |
applyingProjection(projection, serializer) |
(@ddd-ts-kit/kernel/declarations) remet à la méthode @On qui l'applique chaque événement stocké, relu par le sérialiseur de son agrégat ; passe sur le reste du store |
storedStampOf(event) |
Le tampon d'un événement lu depuis le store : son id, son instant et sa version dans son flux, si bien que les lignes d'un même flux sont ordonnées par le flux, pas par les horloges. undefined pour un événement qui ne vient pas d'un store |
EventStoreProjectionRebuild |
Remplit une copie vide de la table en rejouant le store depuis la position zéro à travers la projection construite sur la copie (ShadowReadModelStore) ; puis, en une transaction, retient les écrivains, rejoue ce qui a été ajouté entre-temps et met la copie à la place de la table. L'abonnement continue depuis son point de reprise ; ce qu'il applique à nouveau est périmé face à la copie. Une reconstruction échouée laisse la table telle qu'elle était |
Une projection alimentée par le store n'applique que les événements du domaine de son contexte :
un événement d'intégration atteint une projection là où il est consommé, et @On(definition) sur
une telle projection lève au chargement du fichier.
Vue de l'extérieur
Section intitulée « Vue de l'extérieur »Par les ports qui existent. @ddd-ts-kit/di compte projection_events_total par context,
projection, event et result (applied, traced, stale, ignored, missing, failed) sur Metrics, et
pose projection_last_event_age_ms, l'âge du dernier événement appliqué au moment où il l'a été :
le retard. missing est un changement pour lequel updateIfNewer n'a trouvé aucune ligne. Une projection est abonnée comme consommateur sous son nom, si bien que chaque
livraison est un span process <projection>, avec les appels à son modèle de lecture en
dessous, et qu'un événement enterré après ses nouvelles tentatives atteint le rapporteur
d'erreurs comme pour tout consommateur.
Event sourcing
Section intitulée « Event sourcing »Choisi par agrégat, jamais par projet : les autres agrégats du contexte gardent leur état dans des tables. Quand le choisir et ce qu'il coûte : docs/concepts/event-sourcing.fr.md.
type AttendanceEvent = AttendanceRecordOpened | NoShowNoted;
export class AttendanceRecord extends EventSourcedAggregate<AttendanceEvent, AttendanceState> {  private state: AttendanceState = { noShows: 0 };
  private constructor(id: string) {    super(id);  }
  static open(id: string, now: Date): AttendanceRecord {    const record = new AttendanceRecord(id);
    record.record(new AttendanceRecordOpened(id, now));
    return record;  }
  static rehydrate(id: string, history: AggregateHistory<AttendanceEvent, AttendanceState>): AttendanceRecord {    const record = new AttendanceRecord(id);
    return record.replay(history, (state) => record.restore(state));  }
  noteNoShow(appointmentId: string, now: Date): void {    if (this.state.noShows >= 3) {      throw PatientBarred.forRecord(this.id);    }
    this.record(new NoShowNoted(this.id, now, appointmentId));  }
  protected appliers(): Appliers<AttendanceEvent> {    return {      [AttendanceRecordOpened.eventName]: () => undefined,      [NoShowNoted.eventName]: (event) => this.applyNoShowNoted(event),    };  }
  private restore(state: AttendanceState): void {    this.state = state;  }
private applyNoShowNoted(event: NoShowNoted): void { this.state = { noShows: this.state.noShows + 1 }; }}| Pièce | Ce qu'elle fait |
|---|---|
EventSourcedAggregate<E, S> |
Une commande vérifie ses invariants sur l'état, puis record(event) : l'événement est appliqué par la méthode que appliers() lui associe, et gardé pour l'enregistrement. Seules les méthodes d'application (et restore, pour un snapshot) changent l'état (event-sourcing/state-in-apply). appliers() doit nommer chaque événement de l'union, sinon cela ne compile pas |
replay(history, restore?) |
Reconstruit à partir de { snapshot?, events }, par les mêmes méthodes d'application, sans rien enregistrer. version est le nombre d'événements du flux que l'agrégat reflète |
appendChanges(aggregate, append) |
Ce qu'appelle un adaptateur de repository : les événements enregistrés depuis le chargement et la version que le flux doit encore avoir ; en cas de succès l'agrégat est à la nouvelle version |
EventStore |
Le port : append(stream, expectedVersion, events) (une ConcurrencyError quand quelqu'un a ajouté d'abord, rien n'en est gardé), readStream(stream, after?), readAll(after, limit) dans l'ordre où les ajouts ont été validés, head(). InMemoryEventStore ici ; PostgreSQL par chaque adaptateur ORM. Tenu à eventStoreContract |
defineStoredEvent(Event, spec) |
Comment un événement est stocké : version de sa forme, encode(event): NamedData (données simples, dates gardées en texte ISO), decode(data, envelope) qui lit chaque champ par type (data.text('x'), data.instant('at'), data.record('amount')), et des upcasters depuis chaque version antérieure |
EventSerializer<E> |
Chaque événement stocké d'un agrégat (StoredEventTypes<E> : une entrée par événement, sinon cela ne compile pas). Un événement stocké n'est jamais réécrit : il passe par un upcaster à la lecture. Un événement d'une forme plus récente que ce que connaît la version publiée, ou une version sans upcaster, est une UnreadableEventError |
EventSourcedRepository |
Ce à quoi délègue l'adaptateur de repository : findById rejoue le flux <category>-<id> (depuis le dernier snapshot), save ajoute dans la transaction de l'unité de travail ; les événements partent ensuite avec l'enregistrement comme n'importe quels autres |
SnapshotPolicy |
Par agrégat : every tant d'événements, une version de la forme (une autre est ignorée, le flux rejoué), encode, qui scelle une valeur personnelle avec personalData comme dans un événement, et decode. expectSnapshotEquivalence de @ddd-ts-kit/testing prouve qu'un snapshot reconstruit l'état que donne un rejeu complet |
personalData(subject, value) |
Marque une valeur personnelle dans encode. PersonalDataCipher sur un SubjectKeyStore la scelle avec la clé de sa personne concernée (AES-256-GCM) ; SubjectKeyStore.erase(subject) détruit la clé, et un rejeu lit alors ERASED_PERSONAL_DATA. decode lit une valeur personnelle avec data.personalText('x'), data.personalInstant('at') ou data.personal('email', Email.of), qui répondent undefined une fois la personne effacée : une valeur qui n'est pas un texte libre ne rend jamais l'agrégat illisible ; data.isErased('x') dit si elle l'a été. Le chiffreur ouvre une valeur effacée en ErasedValue, { $erased: { key } }, jamais en texte : data.text la lit ERASED_PERSONAL_DATA, un texte qui se lit [erased] n'est pas pris pour elle, et un upcaster voit cette forme |
EventStorePersonalDataExport({ events, keys, name?, scope? }) |
Le PersonalDataExport de ce que l'event store garde d'une personne : un enregistrement par événement qui porte une valeur scellée avec une clé de la personne, sous <name>.<type d'événement> (event-store par défaut), qui nomme son event (flux, identifiant de l'agrégat, version, instant), chaque valeur ouverte sous son chemin dans les données. Lit tout le store par tours (batchSize, 500) dans l'ordre des positions, celui où un store valide ses ajouts, avec un scope les seuls événements du tenant du travail ; une valeur dont la clé a été détruite ne répond rien, une qui ne se déchiffre pas est nommée dans unreadable. runExport d'un projet en --event-sourcing on la remet comme platform.event-store |
@Repository(AttendanceRecordRepository)export class EventStoreAttendanceRecordRepository implements AttendanceRecordRepository {  private readonly streams: EventSourcedRepository<AttendanceRecord, AttendanceEvent, AttendanceState>;
  constructor(store: EventStore, snapshots: SnapshotStore, cipher: PersonalDataCipher) {    this.streams = new EventSourcedRepository({      store,      category: 'scheduling.attendance-record',      serializer: new EventSerializer<AttendanceEvent>(attendanceRecordEvents, { cipher }),      rehydrate: (id, history) => AttendanceRecord.rehydrate(id, history),      snapshots: { store: snapshots, every: 50, version: 1, encode: (record) => record.toState(), decode: stateOf },    });  }
  findById(id: string): Promise<AttendanceRecord | undefined> {    return this.streams.findById(id);  }
  save(record: AttendanceRecord): Promise<void> {    return this.streams.save(record);  }}
Pas de double écriture. Le store rejoint la transaction de l'unité de travail, et le
publisher des événements d'intégration est un gestionnaire des événements du domaine qui
s'exécute avant la validation et écrit l'outbox : le flux et les enregistrements de l'outbox
sont validés ensemble ou pas du tout. eventStoreUnitOfWorkContract de @ddd-ts-kit/testing le
prouve pour chaque store transactionnel : rien n'est publié pour un ajout annulé ou refusé par un
conflit de concurrence.
Données personnelles
Section intitulée « Données personnelles »Le droit à l'effacement, d'accès et à la portabilité, pour ce qu'un contexte garde d'une personne en clair : ses lignes. Ce qu'un événement stocké scelle est effacé par la clé de sa personne concernée (voir « Event sourcing ») ; ce qu'une table garde en clair est déclaré une fois, à côté du mapper, puis effacé, exporté et inventorié à partir de cette déclaration.
export const personPersonalFields = personalFields<PersonRow>(PERSONS, { subject: 'id', // la colonne qui nomme la personne concernée : un identifiant opaque, jamais une donnée personnelle fields: ['display_name', 'email'], erasure: 'row', // ou 'pseudonymise' : les lignes restent, chaque champ texte lit ERASED_PERSONAL_DATA});| Pièce | Ce qu'elle fait |
|---|---|
personalFields(table, { subject, fields, erasure, files?, retention? }) |
La déclaration : quelles colonnes d'une table sont personnelles, à qui elles appartiennent, et comment les lignes d'une personne sont effacées (row, supprimées ; pseudonymise, chaque champ texte lit ERASED_PERSONAL_DATA et tout autre champ rien). files nomme les colonnes qui tiennent la clé d'un fichier de la personne : le fichier est supprimé du FileStorage et la colonne vidée, quel que soit le mode. Refusé (InvalidPersonalFieldsError) : aucun champ, une colonne listée deux fois, une colonne sujet déclarée personnelle |
PersonalDataErasure |
Le port qu'un contexte étend et nomme, comme il étend Repository : export abstract class PatientErasure extends PersonalDataErasure {}. name est la copie qu'il atteint, telle que le rapport la nomme ; erase(subject) efface ce que le contexte garde de la personne dans le tenant du travail et répond combien de lignes il a atteintes, aucune la seconde fois. Les packages de persistance l'implémentent à partir des déclarations ; InMemoryPersonalData ici |
PersonalDataExport |
Le port du droit d'accès et de la portabilité, étendu et nommé par le contexte comme l'effacement : exportOf(subject) répond un PersonalDataRecord par ligne sur la personne dans le tenant du travail, { source, values }, la source <name>.<table>, chaque colonne personnelle et chaque colonne de fichier (par sa clé) en données simples (PersonalDataValue : un scalaire tel quel, un instant en texte ISO, null pour rien, du texte JSON pour tout le reste), aucune autre colonne et rien de personne d'autre. Les paquets de persistance l'implémentent depuis les déclarations (KnexPersonalDataExport, DrizzlePersonalDataExport, PrismaPersonalDataExport, TypeOrmPersonalDataExport) ; InMemoryPersonalData ici |
eraseDataSubject(subject, { keys?, copies, shared, inEveryTenant, rebuilds, isKnown }) |
L'effacement entier, dans l'ordre : la clé de la personne détruite (SubjectKeyStore.erase, enveloppé par auditedSubjectKeys de @ddd-ts-kit/audit pour qu'une entrée datée le prouve ; sans keys, rien n'est scellé et seules les copies sont effacées, comme dans un projet dont les agrégats sont des lignes), chaque copie effacée dans chaque tenant (chacune enveloppée par auditedPersonalDataErasure, dont les entrées prouvent l'effacement avec ou sans clé), shared, les copies qu'aucun tenant ne confine (l'outbox, le stockage des jobs), effacées une fois, chaque projection alimentée par le store reconstruite. Une copie ou une reconstruction qui échoue n'arrête pas les autres ; le premier échec est levé une fois que tout a tourné, et relancer l'effacement l'achève. Un sujet qui n'est pas un identifiant opaque (isDataSubjectId, la grammaire d'un id de tenant) est refusé avant qu'une clé ne soit touchée (NotADataSubjectIdError) ; un id qui n'a détruit aucune clé, rien effacé et qu'isKnown ne connaît pas est refusé avant les reconstructions (UnknownDataSubjectError) : une faute de frappe, ou un effacement déjà complet. Répond { erased, copies, rebuilt } : si une clé a été détruite, les lignes atteintes par chaque copie, les événements rejoués par chaque projection |
inEachTenant(scope, tenants) |
Ce qu'on donne à inEveryTenant : exécute une copie une fois par tenant, dans le contexte du travail doté de ce tenant, et somme les lignes. Une écriture de données de tenant est confinée au tenant de son contexte et jamais élargie par une élévation : c'est le seul moyen d'effacer dans chaque tenant |
exportDataSubject(subject, { exports, inEveryTenant, clock, isKnown }) |
Le droit d'accès et la portabilité (RGPD, articles 15 et 20) : chaque export, dans l'ordre listé, dans chaque tenant, rassemblé en un PersonalDataExportDocument : format (PERSONAL_DATA_EXPORT_FORMAT, ddd-ts-kit/personal-data-export@1, pour qu'un lecteur connaisse la forme et distingue une forme ultérieure), subject (l'id opaque, jamais un nom), exportedAt (de l'horloge : ce que le document affirme est vrai de cet instant), records. Écrit en JSON, c'est la forme structurée, couramment utilisée et lisible par machine que demande l'article 20. Un export qui échoue arrête le rassemblement, puisqu'un document auquel un contexte manquerait en silence affirmerait moins que ce que le système garde ; un sujet qui n'est pas un identifiant opaque est refusé avant toute lecture (NotADataSubjectIdError : un export cherche une personne par son id, jamais par un nom ou un email, ce qui serait une recherche dans des données personnelles) ; un id qui ne répond aucun enregistrement et qu'isKnown ne connaît pas est refusé (UnknownDataSubjectError) plutôt que de recevoir un document vide qui affirmerait que rien n'est gardé. Donnez-lui les exports enveloppés par auditedPersonalDataExport de @ddd-ts-kit/audit, pour que chaque remise laisse une entrée datée disant qui a lu quoi de qui, jamais les valeurs |
retention: { after, days | months | years } |
Combien de temps les lignes gardent la personne (RGPD, article 5(1)(e)), compté depuis une colonne de date de la ligne qui n'est pas une donnée personnelle et date la fin de la relation (ended_at), jamais son début : comptée depuis une inscription, la purge effacerait des personnes encore clientes ; une unité, un nombre entier positif de celle-ci (refusé sinon, InvalidPersonalFieldsError). Au-delà, la purge efface la ligne comme erasure le dit ; une ligne dont la date est vide n'expire jamais. expiredBefore(period, now) donne l'instant, en unités de calendrier de l'UTC |
PersonalDataRetention, purgeExpiredPersonalData(now, retentions), isPersonalDataRetention |
La limitation de la conservation : le port purgeExpired(now) répond les lignes qu'une copie a effacées, dans le tenant du travail ou dans chaque tenant quand le travail n'en nomme aucun ; les adaptateurs d'effacement des quatre paquets de persistance et InMemoryPersonalData l'implémentent depuis les mêmes déclarations. purgeExpiredPersonalData lance chaque copie au même instant, une copie qui échoue n'arrêtant pas les autres, et répond { purged } par copie ; isPersonalDataRetention distingue une copie qui purge d'une copie qui ne fait qu'effacer. Un projet généré la lance chaque nuit (privacy.purge-expired) et à la main (privacy:purge) |
dataSubjectErasedV1 |
L'annonce d'un effacement, privacy.data-subject.erased version 1, { subjectId, erasedAt } : l'id de la personne seul, aucun opérateur (le journal d'audit garde qui a demandé, l'id de corrélation de l'événement y mène), un nom refusé à create (InvalidDataSubjectErasedError). Il vit ici parce que la couche application de chaque contexte le traite, et il a la forme d'une définition de @ddd-ts-kit/events, pour que son registre, son catalogue, AsyncAPI, on et consume le prennent ; @IntegrationEventHandler(dataSubjectErasedV1, { consumer }) déclare un handler. Un projet généré le publie par l'outbox à la fin de privacy:erase |
recordsInEachTenant(scope, tenants), eachTenant(scope, tenants, work) |
Ce qu'on donne à l'inEveryTenant d'un export : exécute un export une fois par tenant et rassemble les enregistrements dans l'ordre des tenants, comme inEachTenant somme les lignes d'un effacement ; les deux sur eachTenant, qui exécute le travail une fois par tenant, dans le contexte du travail doté de ce tenant, et répond chaque résultat |
InMemoryPersonalData(name, declaration, { files? }) |
L'implémentation de référence des deux ports sur une déclaration, les lignes gardées en mémoire (insert, all) : le fake d'un contexte, et ce à quoi personalDataErasureContract et personalDataExportContract de @ddd-ts-kit/testing tiennent chaque adaptateur |
pseudonymisedValueOf(sqlType) |
Ce que lit une colonne pseudonymisée, d'après son type SQL : ERASED_PERSONAL_DATA pour un texte (text, varchar, char, citext), rien pour tout autre type. La règle unique que suivent les adaptateurs des quatre packages de persistance (KnexPersonalDataErasure, DrizzlePersonalDataErasure, PrismaPersonalDataErasure, TypeOrmPersonalDataErasure), pour qu'une déclaration efface de la même façon sur chaque ORM. NotNullablePersonalColumnError est ce qu'ils lèvent, avant qu'un fichier ou une ligne ne soit touché, pour une colonne qui ne lirait rien et n'accepte pas null |
Ce que cela n'atteint pas : un événement d'intégration publié avant l'effacement et ce qui l'a
consommé, les sauvegardes jusqu'à leur expiration, et le journal d'audit, qui nomme une personne
par un identifiant opaque et jamais par un nom. Dites-le là où l'effacement est offert. L'exemple
scheduling exécute cette chaîne (npm run privacy:erase) sur le PersonalDataErasure de chacun
de ses contextes, le réseau de chaque copie atteint comme un tenant, et
docs/concepts/personal-data.fr.md dit ce qu'un projet
généré contient : les adaptateurs de chaque package de persistance, le dossier de plateforme
qu'init écrit, le registre et les règles.
Comment étendre
Section intitulée « Comment étendre »Session, ExecutionContext, Actor, AuditEntry et ErrorReport ont chacun une interface
vide qu'un projet remplit par fusion de déclarations, une fois, dans un fichier de déclarations
de sa plateforme :
import '@ddd-ts-kit/kernel';
declare module '@ddd-ts-kit/kernel' { interface SessionExtensions { readonly plan: 'free' | 'team'; } interface ExecutionContextExtensions { readonly region: string; } interface ActorExtensions { readonly department: string; } interface AuditEntryExtensions { readonly region: 'eu' | 'us'; } interface ErrorReportExtensions { readonly deployment: 'blue' | 'green'; } interface LogFields { orderId?: string; error?: Error; } interface MetricLabels { region?: 'eu' | 'us' | undefined; }}session.extensions.plan; // 'free' | 'team' | undefinedcontext.extensions.region; // string | undefinedactor.attributes.department; // string | undefinedentry.extensions.region; // 'eu' | 'us' | undefinedlogger.info('shipped', { orderId: 42 }); // erreur de compilation : orderId est une stringextensions, pas des champs de premier niveau. Un champ du projet vit sousextensions, si bien qu'un champ standard ajouté àSessionou àExecutionContextdans une version ultérieure ne peut jamais entrer en collision avec lui.- Facultatives à la lecture.
anonymousSession(),systemSession()etexecutionContext()ne portent aucune extension, et ils doivent rester véridiques dans chaque projet : une extension se lit commeT | undefined. Actorgarde son sac. Les autorisateurs lisent déjàactor.attributespar nom, et les acteurs voyagent dans les messages :ActorExtensionsdonne aux attributs connus un nom et un type à l'intérieur de ce sac au lieu d'en ajouter un second. Une extension qui n'est pas unActorAttribute(une chaîne, un nombre, un booléen ou une liste de chaînes) se lit commenever.AuditEntryExtensionscontient du JSON. Une entrée est hachée et stockée telle quelle : une extension qui n'est pas du JSON simple (uneDate, une classe) se lit commenever.LogFieldsetMetricLabelsacceptent de nouvelles clés bien connues de la même manière ; les clés inconnues restent permises.- Rien à enregistrer. L'augmentation ne porte que sur les types. Les adaptateurs du kit continuent de compiler : ils ne lisent jamais une extension de projet.